
大数据安装之Kafka(用于实时处理的消息队列)
一、安装部署kafka
1、集群规划
hadoop102 hadoop103 hadoop104
zk zk zk
kafka kafka kafka
2、jar包下载
http://kafka.apache.org/downloads.html
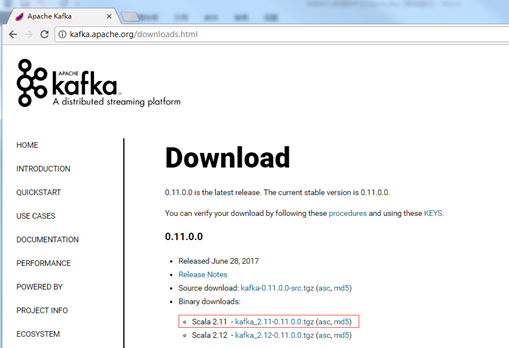
3、集群部署
1)解压安装包
[test@hadoop102 software]$ tar -zxvf kafka_2.11-0.11.0.0.tgz -C /opt/module/
2)修改解压后改名
[test@hadoop102 module]$ mv kafka_2.11-0.11.0.0/ kafka
3)在/opt/module/kafka目录下创建logs文件夹
[test@hadoop102 kafka]$ mkdir logs
4)修改配置文件
[test@hadoop102 kafka]$ cd config/
[test@hadoop102 config]$ vi server.properties
输入以下内容:
broker的全局唯一编号,不能重复
broker.id=0
#删除topic功能使能
delete.topic.enable=true
#处理网络请求的线程数量
num.network.threads=3
#用来处理磁盘IO的线程数量
num.io.threads=8
#发送套接字的缓冲区大小
socket.send.buffer.bytes=102400
#接收套接字的缓冲区大小
socket.receive.buffer.bytes=102400
#请求套接字的缓冲区大小
socket.request.max.bytes=104857600
#kafka运行日志存放的路径
log.dirs=/opt/module/kafka/logs
#topic在当前broker上的分区个数
num.partitions=1
#用来恢复和清理data下数据的线程数量
num.recovery.threads.per.data.dir=1
#segment文件保留的最长时间,超时将被删除
log.retention.hours=168
#配置连接Zookeeper集群地址
zookeeper.connect=hadoop102:2181,hadoop103:2181,hadoop104:2181
5)配置环境变量
[test@hadoop102 module]$ sudo /etc/profile.d/env.sh
#KAFKA_HOME
export KAFKA_HOME=/opt/module/kafka
export PATH=$PATH:$KAFKA_HOME
[test@hadoop102 module]$ source /etc/profile.d/env.sh
6)分发安装包
[test@hadoop102 module]$ xsync kafka/
注意:分发之后记得配置其他机器的环境变量
7)分别在hadoop103和hadoop104上修改配置文件/opt/module/kafka/config/server.properties中的
broker.id=1、broker.id=2
注:broker.id不得重复
8)启动集群
依次在hadoop102、hadoop103、hadoop104节点上启动kafka
[test@hadoop102 kafka]$ bin/kafka-server-start.sh -daemon config/server.properties
[test@hadoop103 kafka]$ bin/kafka-server-start.sh -daemon config/server.properties
[test@hadoop104 kafka]$ bin/kafka-server-start.sh -daemon config/server.properties
9)关闭集群
[test@hadoop102 kafka]$ bin/kafka-server-stop.sh stop
[test@hadoop103 kafka]$ bin/kafka-server-stop.sh stop
[test@hadoop104 kafka]$ bin/kafka-server-stop.sh stop
10)kafka群起脚本
for i in hadoop102 hadoop103 hadoop104
do
echo "========== $i =========="
ssh $i '/opt/module/kafka/bin/kafka-server-start.sh -daemon /opt/module/kafka/config/server.properties'
二、 Kafka命令行操作
1)查看当前服务器中的所有topic
[test@hadoop102 kafka]$ bin/kafka-topics.sh --zookeeper hadoop102:2181 --list
2)创建topic
[test@hadoop102 kafka]$ bin/kafka-topics.sh --zookeeper hadoop102:2181 --create --replication-factor 3 --partitions 1 --topic first
选项说明:
--topic 定义topic名
--replication-factor 定义副本数
--partitions 定义分区数
3)删除topic
[test@hadoop102 kafka]$ bin/kafka-topics.sh --zookeeper hadoop102:2181 --delete --topic first
需要server.properties中设置delete.topic.enable=true否则只是标记删除。
4)发送消息
[test@hadoop102 kafka]$ bin/kafka-console-producer.sh --broker-list hadoop102:9092 --topic first
>hello world
>test test
5)消费消息
[test@hadoop102 kafka]$ bin/kafka-console-consumer.sh \
--zookeeper hadoop102:2181 --topic first
[test@hadoop102 kafka]$ bin/kafka-console-consumer.sh \
--bootstrap-server hadoop102:9092 --topic first
[test@hadoop102 kafka]$ bin/kafka-console-consumer.sh \
--bootstrap-server hadoop102:9092 --from-beginning --topic first
--from-beginning:会把主题中以往所有的数据都读取出来。
6)查看某个Topic的详情
[test@hadoop102 kafka]$ bin/kafka-topics.sh --zookeeper hadoop102:2181 --describe --topic first
7)修改分区数
[test@hadoop102 kafka]$ bin/kafka-topics.sh --zookeeper hadoop102:2181 --alter --topic first --partitions 6
大数据安装之Kafka(用于实时处理的消息队列)的更多相关文章
- 大数据技术之Kafka
Kafka概述 1.1 消息队列 (1)点对点模式(一对一,消费者主动拉取数据,消息收到后消息清除) 点对点模型通常是一个基于拉取或者轮询的消息传送模型,这种模型从队列中请求信息,而不是将消息 ...
- 大数据架构之:Kafka
Kafka 是一个高吞吐.分布式.基于发布订阅的消息系统,利用Kafka技术可在廉价PC Server上搭建起大规模消息系统.Kafka具有消息持久化.高吞吐.分布式.多客户端支持.实时等特性,适用于 ...
- 【kafka】一、消息队列
在高并发的应用场景中,由于来不及同步处理请求,接收到的请求往往会发生阻塞.例如,大量的插入.更新请求同时到达数据库,这会导致行或表被锁住,最后会因为请求堆积过多而触发“连接数过多的异常” 的错误.因此 ...
- 【原创】大数据基础之Kafka(1)简介、安装及使用
kafka2.0 http://kafka.apache.org 一 简介 Kafka® is used for building real-time data pipelines and strea ...
- 大数据基础之Kafka(1)简介、安装及使用
kafka2.0 http://kafka.apache.org 一 简介 Kafka® is used for building real-time data pipelines and strea ...
- 大数据平台搭建-kafka集群的搭建
本系列文章主要阐述大数据计算平台相关框架的搭建,包括如下内容: 基础环境安装 zookeeper集群的搭建 kafka集群的搭建 hadoop/hbase集群的搭建 spark集群的搭建 flink集 ...
- 大数据 -- zookeeper和kafka集群环境搭建
一 运行环境 从阿里云申请三台云服务器,这里我使用了两个不同的阿里云账号去申请云服务器.我们配置三台主机名分别为zy1,zy2,zy3. 我们通过阿里云可以获取主机的公网ip地址,如下: 通过secu ...
- 入门大数据---Spark_Streaming整合Kafka
一.版本说明 Spark 针对 Kafka 的不同版本,提供了两套整合方案:spark-streaming-kafka-0-8 和 spark-streaming-kafka-0-10,其主要区别如下 ...
- 入门大数据---安装ClouderaManager,CDH和Impala,Hue,oozie等服务
1.要求和支持的版本 (PS:我使用的环境,都用加粗标识了.) 1.1 支持的操作系统版本 操作系统 版本 RHEL/CentOS/OL with RHCK kernel 7.6, 7.5, 7.4, ...
随机推荐
- 【转载/部分修改】超实用STL——set的入门使用
本文部分转载自他人博文,少部分自行进行了添改qwq 参考文章:https://blog.csdn.net/chaoyueziji123/article/details/38422211 作者:chao ...
- Java并发编程入门与高并发面试(三):线程安全性-原子性-CAS(CAS的ABA问题)
摘要:本文介绍线程的安全性,原子性,java.lang.Number包下的类与CAS操作,synchronized锁,和原子性操作各方法间的对比. 线程安全性 线程安全? 线程安全性? 原子性 Ato ...
- Django学习之路04
视图层 小白必会三板斧 HttpResponse render redirect django视图函数必须要给返回一个HttpResponse对象(render和redirect内部返回的也是一个Ht ...
- 携程酒店DevOps测试实践
作者简介 王幸福,携程酒店研发部高级测试经理,负责无线自动化测试相关工作.在测试框架和平台研发.移动测试.DevOps等领域有着丰富的经验. 如今很多大型互联网公司.创新型企业都在积极地进行DevOp ...
- tar:file-changed-as-we-read-it报错处理
在使用tar命令对Mysql的数据目录进行备份打包时出现如下报错: tar cvzf mysql.tgz mysql /bin/tar: /path/to/mysql: file changed as ...
- [PyTorch入门之60分钟入门闪击战]之神经网络
神经网络 来源于这里. 神经网络可以使用torch.nn包构建. 现在你对autograd已经有了初步的了解,nn依赖于autograd定义模型并区分它们.一个nn.Module包含了层(layers ...
- 《深入理解 Java 虚拟机》读书笔记:类文件结构
正文 一.无关性的基石 1.两种无关性 平台无关性: Java 程序的运行不受计算机平台的限制,"一次编写,到处运行". 语言无关性: Java 虚拟机只与 Class 文件关联, ...
- Web 通信技术 ——跨文档信息传输(JavaScript)
*/ * Copyright (c) 2016,烟台大学计算机与控制工程学院 * All rights reserved. * 文件名:text.html * 作者:常轩 * 微信公众号:Worldh ...
- springboot 解决实体类值为null或者数组为空,不返回前台
一个注解解决问题 @JsonInclude(JsonInclude.Include.NON_EMPTY) @JsonInclude(JsonInclude.Include.NON_NULL)
- SpringBoot一些基础配置
定制banner Spring Boot项目在启动的时候会有一个默认的启动图案: . ____ _ __ _ _ /\\ / ___'_ __ _ _(_)_ __ __ _ \ \ \ \ ( ( ...