
3.Python爬虫入门三之Urllib和Urllib2库的基本使用
1.分分钟扒一个网页下来
怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由浏览器解释才呈现出来的,实质它是一段HTML代码,加 JS、CSS,如果把网页比作一个人,那么HTML便是他的骨架,JS便是他的肌肉,CSS便是它的衣服。所以最重要的部分是存在于HTML中的,下面我们就写个例子来扒一个网页下来。
 import urllib

 import urllib2

 response = urllib2.urlopen("http://www.baidu.com")

 print response
是的你没看错,真正的程序就两行,把它保存成 demo.py,进入该文件的目录,执行命令查看运行结果,会发现整个页面的源码就打印出来了。
2.分析扒网页的方法
那么我们来分析这两行代码,第一行:
response = urllib2.urlopen("http://www.baidu.com")
首先我们调用的是urllib2库里面的urlopen方法,传入一个URL,这个网址是百度首页,协议是HTTP协议,当然你也可以把HTTP换做FTP,FILE,HTTPS 等等,只是代表了一种访问控制协议,urlopen可以接受的三个参数,它的参数如下:
def urlopen(url, data=None, timeout=socket._GLOBAL_DEFAULT_TIMEOUT,cafile=None, capath=None, cadefault=False, context=None):
一般情况下接受常用的三个参数:url, data, timeout
第一个参数url即为URL,第二个参数data是访问URL时要传送的数据,第三个timeout是设置超时时间。
第二三个参数是可以不传送的,data默认为空None,timeout默认为 socket._GLOBAL_DEFAULT_TIMEOUT
第一个参数URL是必须要传送的,在这个例子里面我们传送了百度的URL,执行urlopen方法之后,返回一个response对象,返回信息便保存在这里面。
print response
response对象有一个read方法,可以返回获取到的网页内容。如果不加read直接打印会是什么?会直接打印出内存地址 所以在获取网页源代码的时候需要调用response的read()方法。
3.构造Request
其实上面的urlopen参数可以传入一个request请求,它其实就是一个Request类的实例,构造时需要传入Url,Data等等的内容。比如上面的两行代码,我们可以这么改写:
response = urllib2.Request("http://www.baidu.com")

response = urllib2.urlopen(response)

print response.read()
运行结果是完全一样的,只不过中间多了一个request对象,推荐大家这么写,因为在构建请求时还需要加入好多内容,通过构建一个request,服务器响应请求得到应答,这样显得逻辑上清晰明确。
4.POST和GET数据传送
上面的程序演示了最基本的网页抓取,不过,现在大多数网站都是动态网页,需要你动态地传递参数给它,它做出对应的响应。所以,在访问时,我们需要传递数据给它。最常见的情况是什么?对了,就是登录注册的时候呀。
把数据用户名和密码传送到一个URL,然后你得到服务器处理之后的响应,这个该怎么办?下面让我来为小伙伴们揭晓吧!
数据传送分为POST和GET两种方式,两种方式有什么区别呢?
最重要的区别是GET方式是直接以链接形式访问,链接中包含了所有的参数,当然如果包含了密码的话是一种不安全的选择,不过你可以直观地看到自己提交了什么内容。POST则不会在网址上显示所有的参数,不过如果你想直接查看提交了什么就不太方便了,大家可以酌情选择。
POST方式:
上面我们说了data参数是干嘛的?对了,它就是用在这里的,我们传送的数据就是这个参数data,下面演示一下POST方式。
#post 方式

values = {'username':'xxxxxx','password':'xxxxxxx'} #设置values 保存了用户名和密码

data = urllib.urlencode(values)# 用urllib的urlencode方法将字典编码

url = 'https://passport.csdn.net/account/login?from=http%3A%2F%2Fmy.csdn.net%2Fmy%2Fmycsdn'

request = urllib2.Request(url,data) #构建的request传入两个参数 即可运行程序登陆

response = urllib2.urlopen(request)

print response.read()
我们引入了urllib库,现在我们模拟登陆CSDN,当然上述代码可能登陆不进去,因为CSDN还有个流水号的字段,没有设置全,比较复杂在这里就不写上去了,在此只是说明登录的原理。一般的登录网站一般是这种写法。
我们需要定义一个字典,名字为values,参数我设置了username和password,下面利用urllib的urlencode方法将字典编码,命名为data,构建request时传入两个参数,url和data,运行程序,返回的便是POST后呈现的页面内容。
注意上面字典的定义方式还有一种,下面的写法是等价的
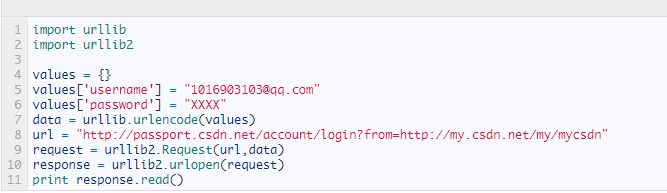
以上方法便实现了POST方式的传送
GET方式:
至于GET方式我们可以直接把参数写到网址上面,直接构建一个带参数的URL出来即可。
#get 方式

values = {}

values['username'] = '1000000@qq.com'

values['password'] = 'xxxxx'

data = urllib.urlopen(values)

url = 'http://password.csdn.net/account/login'

geturl = url + '?' + data

request = urllib2.request(geturl)

response = urllib2.urlopen(request)

print response.read()
你可以print geturl,打印输出一下url,发现其实就是原来的url加?然后加编码后的参数。
和我们平常GET访问方式一模一样,这样就实现了数据的GET方式传送。
转载:静觅 » Python爬虫入门三之Urllib库的基本使用
3.Python爬虫入门三之Urllib和Urllib2库的基本使用的更多相关文章
- 转 Python爬虫入门三之Urllib库的基本使用
静觅 » Python爬虫入门三之Urllib库的基本使用 1.分分钟扒一个网页下来 怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由浏览器 ...
- Python爬虫入门三之Urllib库的基本使用
转自http://cuiqingcai.com/947.html 1.分分钟扒一个网页下来 怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由 ...
- Python爬虫入门四之Urllib库的高级用法
1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性. 首先,打开我们的浏览 ...
- 转 Python爬虫入门四之Urllib库的高级用法
静觅 » Python爬虫入门四之Urllib库的高级用法 1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我 ...
- Python爬虫入门(二)之Requests库
Python爬虫入门(二)之Requests库 我是照着小白教程做的,所以该篇是更小白教程hhhhhhhh 一.Requests库的简介 Requests 唯一的一个非转基因的 Python HTTP ...
- 4.Python爬虫入门四之Urllib库的高级用法
1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性. 首先,打开我们的浏览 ...
- python爬虫入门三:requests库
urllib库在很多时候都比较繁琐,比如处理Cookies.因此,我们选择学习另一个更为简单易用的HTTP库:Requests. requests官方文档 1. 什么是Requests Request ...
- Python爬虫入门之Urllib库的基本使用
那么接下来,小伙伴们就一起和我真正迈向我们的爬虫之路吧. 1.分分钟扒一个网页下来 怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由浏览器解 ...
- Python爬虫入门之Urllib库的高级用法
1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性. 首先,打开我们的浏览 ...
随机推荐
- LeetCode--232--用栈实现队列
问题描述: 使用栈实现队列的下列操作: push(x) -- 将一个元素放入队列的尾部. pop() -- 从队列首部移除元素. peek() -- 返回队列首部的元素. empty() -- 返回队 ...
- Confluence 6 内容在空间中是如何组织的
你可以将空间考虑为一个容器,在这个容器中保持了有关你项目中所有重要的东西,包括小组,项目或者项目相关的工作.这些东西有很高的自主性,这表示的是每个空间都有自己的的页面,文件,评论以及 RSS 新闻源. ...
- 架构探险笔记6-ThreadLocal简介
什么是ThreadLocal? ThreadLocal直译为“线程本地”或“本地线程”,如果真的这么认为,那就错了!其实它就是一个容器,用于存放线程的局部变量,应该叫ThreadLocalVariab ...
- appium自动化环境搭建(python语言开发)
简述 1.安装jdk,配置环境变量 2.安装AndroidSDK,配置环境变量 3.安装Python 4.安装Python集成开发环境PyCharm 5.安装node 6.安装appium服务端 7. ...
- 【洛谷p1319】压缩技术
(许久不见,甚是想念) 压缩技术[传送门] 洛谷上滴算法标签: 然而这是一道入门难度的题.(不管不管,就写它了) 好的先说一下思路吧wait!我忘记了咋做的当时. 首先做题第一道坎儿,如何输入若干个( ...
- Python基础之文件的初识函数
初识函数函数定义:定义一个事情或者功能. 等到需要的时候直接去用就好了了. 那么这里定义的东西就是一个函数即函数: 对代码块和功能的封装和定义1.1常用形式: def 函数名(): 函数体1.2 函数 ...
- 『MXNet』第三弹_Gluon模型参数
MXNet中含有init包,它包含了多种模型初始化方法. from mxnet import init, nd from mxnet.gluon import nn net = nn.Sequenti ...
- leetcode-algorithms-3 Longest Substring Without Repeating Characters
leetcode-algorithms-3 Longest Substring Without Repeating Characters Given a string, find the length ...
- JQ 实现监测input中值的变化并绑定到另个input
$('#input').bind('input propertychange', function () { $('#myDiv ...
- hdu1569-方格取数-二分图网络流
方格取数(2) Time Limit: 10000/5000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others)Total Su ...