
GAN生成式对抗网络(三)——mnist数据生成
通过GAN生成式对抗网络,产生mnist数据
引入包,数据约定等
import numpy as np

import matplotlib.pyplot as plt

import input_data  #读取数据的一个工具文件,不影响理解

import tensorflow as tf

# 获取数据

mnist = input_data.read_data_sets('data/', one_hot=True)

trainimg = mnist.train.images

X = mnist.train.images[:, :]

batch_size = 64

#用来返回真实数据

def iterate_minibatch(x, batch_size, shuffle=True):

    indices = np.arange(x.shape[0])

    if shuffle:

        np.random.shuffle(indices)

    for i in range(0, x.shape[0]-1000, batch_size):

        temp = x[indices[i:i + batch_size], :]

        temp = np.array(temp) * 2 - 1

        yield np.reshape(temp, (-1, 28, 28, 1))
GAN对象结构
class GAN(object):

    def __init__(self):

        #初始函数,在这里对初始化模型

    def netG(self, z):

        #生成器模型

    def netD(self, x, reuse=False):

        #判别器模型
生成器函数
对随机值z(维度为1,100),进行包装,伪造,产生伪造数据。
包装过程概括为:全连接->reshape->反卷积
包装过程中使用了batch_normalization,Leaky ReLU,dropout,tanh等技巧
   #对随机值z(维度为1,100),进行包装,伪造,产生伪造数据。

    #包装过程概括为:全连接->reshape->反卷积

    #包装过程中使用了batch_normalization,Leaky ReLU,dropout,tanh等技巧

    def netG(self,z,alpha=0.01):

        with tf.variable_scope('generator') as scope:

            layer1 = tf.layers.dense(z, 4 * 4 * 512)  # 这是一个全连接层,输出 (n,4*4*512)

            layer1 = tf.reshape(layer1, [-1, 4, 4, 512])

            # batch normalization

            layer1 = tf.layers.batch_normalization(layer1, training=True)  # 做BN标准化处理

            # Leaky ReLU

            layer1 = tf.maximum(alpha * layer1, layer1)

            # dropout

            layer1 = tf.nn.dropout(layer1, keep_prob=0.8)

            # 4 x 4 x 512 to 7 x 7 x 256

            layer2 = tf.layers.conv2d_transpose(layer1, 256, 4, strides=1, padding='valid')

            layer2 = tf.layers.batch_normalization(layer2, training=True)

            layer2 = tf.maximum(alpha * layer2, layer2)

            layer2 = tf.nn.dropout(layer2, keep_prob=0.8)

            # 7 x 7 256 to 14 x 14 x 128

            layer3 = tf.layers.conv2d_transpose(layer2, 128, 3, strides=2, padding='same')

            layer3 = tf.layers.batch_normalization(layer3, training=True)

            layer3 = tf.maximum(alpha * layer3, layer3)

            layer3 = tf.nn.dropout(layer3, keep_prob=0.8)

            # 14 x 14 x 128 to 28 x 28 x 1

            logits = tf.layers.conv2d_transpose(layer3, 1, 3, strides=2, padding='same')

            # MNIST原始数据集的像素范围在0-1,这里的生成图片范围为(-1,1)

            # 因此在训练时,记住要把MNIST像素范围进行resize

            outputs = tf.tanh(logits)

            return outputs
判别器函数
通过深度卷积+全连接的形式,判别器将输入分类为真数据,还是假数据。
    def netD(self, x, reuse=False,alpha=0.01):

        with tf.variable_scope('discriminator') as scope:

            if reuse:

                scope.reuse_variables()

            layer1 = tf.layers.conv2d(x, 128, 3, strides=2, padding='same')

            layer1 = tf.maximum(alpha * layer1, layer1)

            layer1 = tf.nn.dropout(layer1, keep_prob=0.8)

            # 14 x 14 x 128 to 7 x 7 x 256

            layer2 = tf.layers.conv2d(layer1, 256, 3, strides=2, padding='same')

            layer2 = tf.layers.batch_normalization(layer2, training=True)

            layer2 = tf.maximum(alpha * layer2, layer2)

            layer2 = tf.nn.dropout(layer2, keep_prob=0.8)

            # 7 x 7 x 256 to 4 x 4 x 512

            layer3 = tf.layers.conv2d(layer2, 512, 3, strides=2, padding='same')

            layer3 = tf.layers.batch_normalization(layer3, training=True)

            layer3 = tf.maximum(alpha * layer3, layer3)

            layer3 = tf.nn.dropout(layer3, keep_prob=0.8)

            # 4 x 4 x 512 to 4*4*512 x 1

            flatten = tf.reshape(layer3, (-1, 4 * 4 * 512))

            f = tf.layers.dense(flatten, 1)

            return f
初始化函数
有一个前置训练,将真实数据喂给判别器,训练判别器的鉴别能力
    # 有一个前置训练,将真实数据喂给判别器,训练判别器的鉴别能力

    def __init__(self):

        self.z = tf.placeholder(tf.float32, shape=[batch_size, 100], name='z')  # 随机输入值

        self.x = tf.placeholder(tf.float32, shape=[batch_size, 28, 28, 1], name='real_x')  # 图片值

        self.fake_x = self.netG(self.z)  # 将随机输入,包装为伪造图片值

        self.pre_logits = self.netD(self.x, reuse=False)  # 判别器预训练时,判别器对真实数据的判别情况-未sigmoid处理

        self.real_logits = self.netD(self.x, reuse=True)  # 判别器对真实数据的判别情况-未sigmoid处理

        self.fake_logits = self.netD(self.fake_x, reuse=True)  # 判别器对伪造数据的判别情况-未sigmoid处理

        # 预训练时判别器,判别器将真实数据判定为真的得分情况。

        self.loss_pre_D = tf.reduce_mean(tf.nn.sigmoid_cross_entropy_with_logits(logits=self.pre_logits,

                                                                                 labels=tf.ones_like(self.pre_logits)))

        # 训练时,判别器将真实数据判定为真,将伪造数据判定为假的得分情况。

        self.loss_D = tf.reduce_mean(tf.nn.sigmoid_cross_entropy_with_logits(logits=self.real_logits,

                                                                             labels=tf.ones_like(self.real_logits))) + \

                      tf.reduce_mean(tf.nn.sigmoid_cross_entropy_with_logits(logits=self.fake_logits,

                                                                             labels=tf.zeros_like(self.fake_logits)))

        # 训练时,生成器伪造的数据,被判定为真实数据的得分情况。

        self.loss_G = tf.reduce_mean(tf.nn.sigmoid_cross_entropy_with_logits(logits=self.fake_logits,

                                                                             labels=tf.ones_like(self.fake_logits)))

        # 获取生成器和判定器对应的变量地址,用于更新变量

        t_vars = tf.trainable_variables()

        self.g_vars = [var for var in t_vars if var.name.startswith("generator")]

        self.d_vars = [var for var in t_vars if var.name.startswith("discriminator")]
开始训练
gan = DCGAN()

#预训练时的梯度优化函数

d_pre_optim = tf.train.AdamOptimizer(learning_rate=0.001, beta1=0.4).minimize(gan.loss_pre_D, var_list=gan.d_vars)

#判别器的梯度优化函数

d_optim = tf.train.AdamOptimizer(learning_rate=0.001, beta1=0.4).minimize(gan.loss_D, var_list=gan.d_vars)

#预训练时的梯度优化函数

g_optim = tf.train.AdamOptimizer(learning_rate=0.001, beta1=0.4).minimize(gan.loss_G, var_list=gan.g_vars)

init = tf.global_variables_initializer()

with tf.Session() as sess:

    sess.run(init)

    #对判别器的预训练,训练了两个epoch

    for i in range(2):

        print('判别器初始训练,第' + str(i) + '次包')

        for x_batch in iterate_minibatch(X, batch_size=batch_size):

            loss_pre_D, _ = sess.run([gan.pre_logits, d_pre_optim],

                                     feed_dict={

                                         gan.x: x_batch

                                     })

    #训练5个epoch

    for epoch in range(5):

        print('对抗' + str(epoch) + '次包')

        avg_loss = 0

        count = 0

        for x_batch in iterate_minibatch(X, batch_size=batch_size):

            z_batch = np.random.uniform(-1, 1, size=(batch_size, 100))  # 随机起点值

            loss_D, _ = sess.run([gan.loss_D, d_optim],

                                 feed_dict={

                                     gan.z: z_batch,

                                     gan.x: x_batch

                                 })

            loss_G, _ = sess.run([gan.loss_G, g_optim],

                                 feed_dict={

                                     gan.z: z_batch,

                                     # gan.x: np.zeros(z_batch.shape)

                                 })

            avg_loss += loss_D

            count += 1

        # 显示预测情况

        if True:

            avg_loss /= count

            z = np.random.normal(size=(batch_size, 100))

            excerpt = np.random.randint(100, size=batch_size)

            needTest = np.reshape(X[excerpt, :], (-1, 28, 28, 1))

            fake_x, real_logits, fake_logits = sess.run([gan.fake_x, gan.real_logits, gan.fake_logits],

                                                        feed_dict={gan.z: z, gan.x: needTest})

            # accuracy = (np.sum(real_logits > 0.5) + np.sum(fake_logits < 0.5)) / (2 * batch_size)

            print('real_logits')

            print(len(real_logits))

            print('fake_logits')

            print(len(fake_logits))

            print('\ndiscriminator loss at epoch %d: %f' % (epoch, avg_loss))

            # print('\ndiscriminator accuracy at epoch %d: %f' % (epoch, accuracy))

            print('----')

            print()

            # curr_img = np.reshape(trainimg[i, :], (28, 28))  # 28 by 28 matrix

            curr_img = np.reshape(fake_x[0], (28, 28))

            plt.matshow(curr_img, cmap=plt.get_cmap('gray'))

            plt.show()

            curr_img2 = np.reshape(fake_x[10], (28, 28))

            plt.matshow(curr_img2, cmap=plt.get_cmap('gray'))

            plt.show()

            curr_img3 = np.reshape(fake_x[20], (28, 28))

            plt.matshow(curr_img3, cmap=plt.get_cmap('gray'))

            plt.show()

            curr_img4 = np.reshape(fake_x[30], (28, 28))

            plt.matshow(curr_img4, cmap=plt.get_cmap('gray'))

            plt.show()

            curr_img5 = np.reshape(fake_x[40], (28, 28))

            plt.matshow(curr_img5, cmap=plt.get_cmap('gray'))

            plt.show()

            # plt.figure(figsize=(28, 28))

            # plt.title("" + str(i) + "th Training Data "

            #           + "Label is " + str(curr_label))

            # print("" + str(i) + "th Training Data "

            #       + "Label is " + str(curr_label))

            # plt.scatter(X[:, 0], X[:, 1])

            # plt.scatter(fake_x[:, 0], fake_x[:, 1])

            # plt.show()
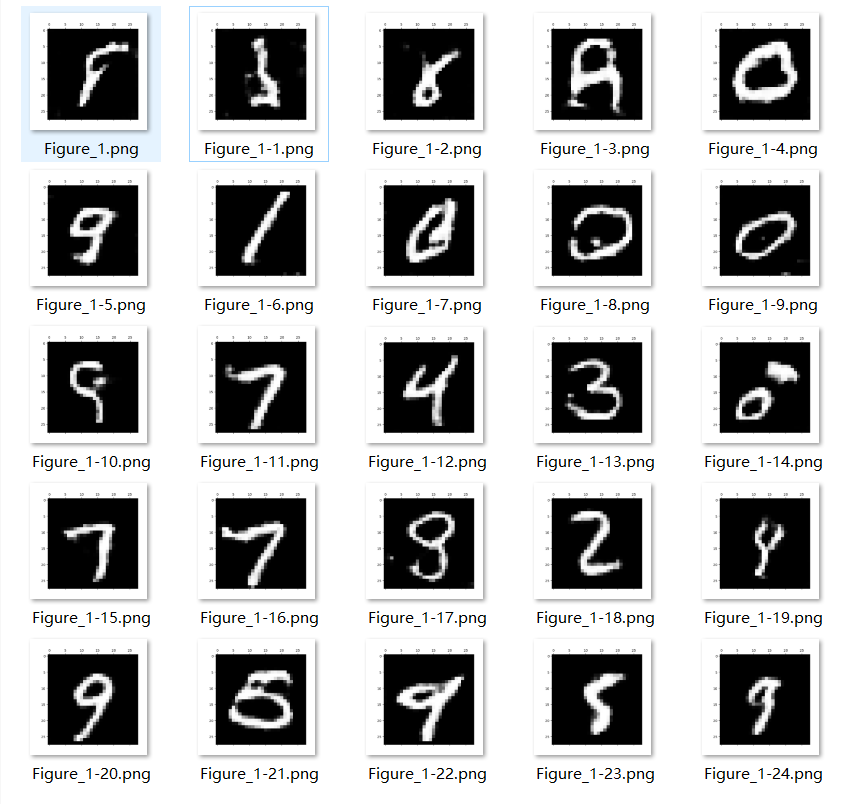
结果
GAN生成式对抗网络(三)——mnist数据生成的更多相关文章
- GAN生成式对抗网络(四)——SRGAN超高分辨率图片重构
论文pdf 地址:https://arxiv.org/pdf/1609.04802v1.pdf 我的实际效果 清晰度距离我的期待有距离. 颜色上面存在差距. 解决想法 增加一个颜色判别器.将颜色值反馈 ...
- GAN生成式对抗网络(一)——原理
生成式对抗网络(GAN, Generative Adversarial Networks )是一种深度学习模型 GAN包括两个核心模块. 1.生成器模块 --generator 2.判别器模块--de ...
- 不要怂,就是GAN (生成式对抗网络) (一)
前面我们用 TensorFlow 写了简单的 cifar10 分类的代码,得到还不错的结果,下面我们来研究一下生成式对抗网络 GAN,并且用 TensorFlow 代码实现. 自从 Ian Goodf ...
- 不要怂,就是GAN (生成式对抗网络) (一): GAN 简介
前面我们用 TensorFlow 写了简单的 cifar10 分类的代码,得到还不错的结果,下面我们来研究一下生成式对抗网络 GAN,并且用 TensorFlow 代码实现. 自从 Ian Goodf ...
- 不要怂,就是GAN (生成式对抗网络) (二):数据读取和操作
前面我们了解了 GAN 的原理,下面我们就来用 TensorFlow 搭建 GAN(严格说来是 DCGAN,如无特别说明,本系列文章所说的 GAN 均指 DCGAN),如前面所说,GAN 分为有约束条 ...
- 不要怂,就是GAN (生成式对抗网络) (二)
前面我们了解了 GAN 的原理,下面我们就来用 TensorFlow 搭建 GAN(严格说来是 DCGAN,如无特别说明,本系列文章所说的 GAN 均指 DCGAN),如前面所说,GAN 分为有约束条 ...
- 不要怂,就是GAN (生成式对抗网络) (六):Wasserstein GAN(WGAN) TensorFlow 代码
先来梳理一下我们之前所写的代码,原始的生成对抗网络,所要优化的目标函数为: 此目标函数可以分为两部分来看: ①固定生成器 G,优化判别器 D, 则上式可以写成如下形式: 可以转化为最小化形式: 我们编 ...
- 不要怂,就是GAN (生成式对抗网络) (三):判别器和生成器 TensorFlow Model
在 /home/your_name/TensorFlow/DCGAN/ 下新建文件 utils.py,输入如下代码: import scipy.misc import numpy as np # 保存 ...
- 不要怂,就是GAN (生成式对抗网络) (四):训练和测试 GAN
在 /home/your_name/TensorFlow/DCGAN/ 下新建文件 train.py,同时新建文件夹 logs 和文件夹 samples,前者用来保存训练过程中的日志和模型,后者用来保 ...
随机推荐
- Spring (2)框架
Spring第二天笔记 1. 使用注解配置Spring入门 1.1. 说在前面 学习基于注解的IoC配置,大家脑海里首先得有一个认知,即注解配置和xml配置要实现的功能都是一样的,都是要降低程序间的耦 ...
- JS 03事件
<script type="text/javascript"> function getUserInput() { //获取用户输入的内容 var val = docu ...
- 音视频入门-02-RGB拼图
* 音视频入门文章目录 * 图片 & 像素点 & RGB 平时浏览的图片看不出像素点: 图片放大时,可以看出图片是一个个像素点组成的: 每个像素点的颜色可以用 RGB 表示: RGB ...
- Docker多阶段构建实战(multi-stage builds)
在编写Dockerfile构建docker镜像时,常遇到以下问题: RUN命令会让镜像新增layer,导致镜像变大,虽然通过&&连接多个命令能缓解此问题,但如果命令之间用到docker ...
- 二级菜单被banner遮住的解决方法
原因:z-index的问题 解决:在导航box加 position: relative; z-index: 4; 比banner 大就可以.然后在一级导航的 li 设置 相对定位 positio ...
- 7.生产者消费者 案例 (使用Lock 同步锁 方式,使用Condition完成线程之间的通信)
/* * 生产者消费者 案例 (使用Lock 同步锁 方式,使用Condition完成线程之间的通信) * */ public class TestProductorAndConsumerForLoc ...
- css border-raidus 百分比和数值设置效果不同
1.水平方向和竖直方向半径相等:设置数值和百分比的效果是一样的: 2.水平方向和竖直方向半径不相同:则效果不一致,具体参见:http://www.zhangxinxu.com/wordpress/20 ...
- Java入门学习总结_02
一:注释 注释主要就是用来解释某句或者某段代码使得其他人调试更加方便.特点是在编译代码的时候不会编译注释, 不管发不发生错误.注释主要分为单行注释//(快捷键ctrl+/).多行注释/* */(快捷键 ...
- 2018牛客网暑期ACM多校训练营(第二场)I- car ( 思维)
2018牛客网暑期ACM多校训练营(第二场)I- car 链接:https://ac.nowcoder.com/acm/contest/140/I来源:牛客网 时间限制:C/C++ 1秒,其他语言2秒 ...
- Java字节码常量池深度剖析与字节码整体结构分解
常量池深度剖析: 在上一次[https://www.cnblogs.com/webor2006/p/9416831.html]中已经将常量池分析到了2/3了,接着把剩下的分析完,先回顾一下我们编译的源 ...