
中文分词中的战斗机-jieba库
英文分词的第三方库NLTK不错,中文分词工具也有很多(盘古分词、Yaha分词、Jieba分词等)。但是从加载自定义字典、多线程、自动匹配新词等方面来看。
大jieba确实是中文分词中的战斗机。
请随意观看表演
安装
- 使用pip包傻瓜安装:
py -3 -m pip install jieba/pip install jiba(windows下推荐第一种,可以分别安装python2和3对应jieba) - pypi下载地址
分词
3种模式
- 精确模式:试图将句子最精确地切开,适合文本分析
- 全模式:把句子中所有的可以成词的词语都扫描出来(速度快)
- 搜索引擎模式:在精确模式的基础上,对长词再次切分,提高召回率,适合用于搜索引擎分词
实现方式
- 精确模式:
jieba.cut(sen) - 全模式:
jieba.cut(sen,cut_all=True) - 搜索引擎模式:
jieba.cut_for_search(sen)
import jieba

sen = "我爱深圳大学"

sen_list = jieba.cut(sen)

sen_list_all = jieba.cut(sen,cut_all=True)

sen_list_search = jieba.cut_for_search(sen)

for i in sen_list:

    print(i,end=" ")

print()

for i in sen_list_all:

    print(i,end=" ")

print()

for i in sen_list_search:

    print(i,end=" ")

print()
结果:附截图
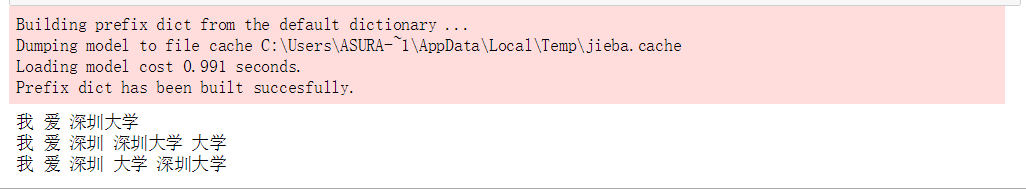
自定义词典
创建方式
- 后缀:txt
- 格式:词语( 权重 词性 )
- 注意事项:
- windows下txt不能用自带的编辑器,否则会乱码。可以用VSCODE,或者其他编辑器
- 可以只有词语
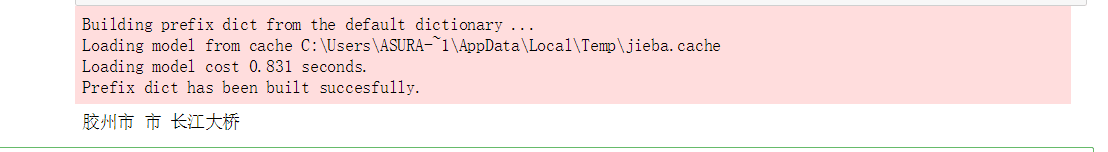
- 在没有权重的情况下,只有比默认词典长的词语才可以加载进去。附截图
加载字典
jieba.load_userdict(txtFile)
调整字典
添加词:jieba.add_word(word,freq=None,tag=None)
删除词:jieba.del_word(word)
import jieba

sen = "胶州市市长江大桥"

sen_list = jieba.cut(sen)

for i in sen_list:

    print(i,end=" ")

print()
胶州市 市 长江大桥
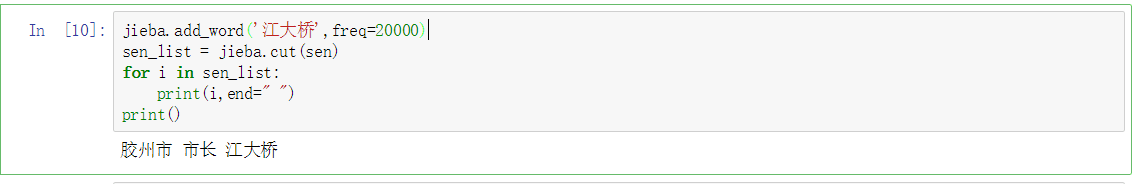
jieba.add_word('江大桥',freq=20000)

sen_list = jieba.cut(sen)

for i in sen_list:

    print(i,end=" ")

print()
结果附截图
改变主字典
- 占用内存较小的词典文件
- 支持繁体分词更好的词典文件
- 加载方法:
jieba.set_dictionary('data/dict.txt.big')
延迟加载
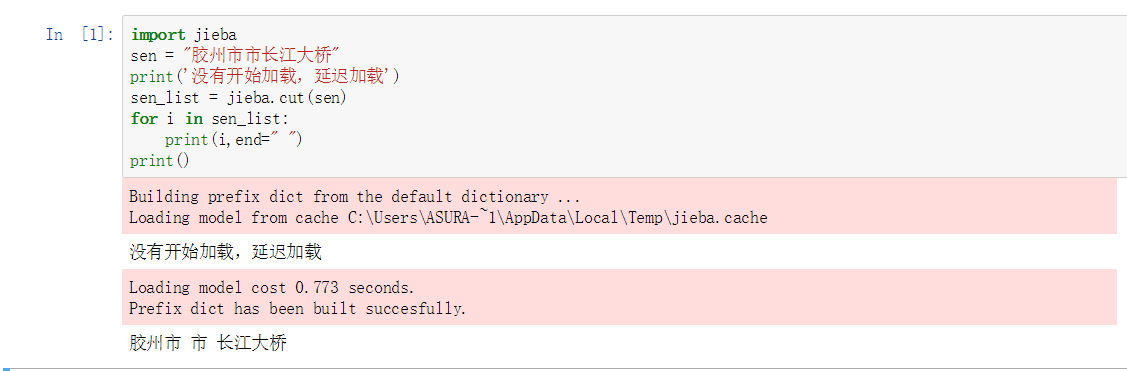
之前发现,词典不是一次性加载的,说明它采用的是延迟加载。即:当遇到应用的时候才会加载。有点类似于python高级特性中的
yield(节省内存)
效果图如下:
- 手动加载的方法:
jieba.initialize()
关键词提取
jieba.analyse.extract_tags(sentence,topK=20):返回topK个TF/IDF权重最大的词语
import jieba.analyse

sen_ana = jieba.analyse.extract_tags(sen,3)

for i in sen_ana:

    print(i)
江大桥

胶州市

市长
词性标注
jieba.posseg.cut(sen):返回的每个迭代对象有两个属性-> word 词语 + flag 词性
import jieba.posseg

words = jieba.posseg.cut(sen)

for word in words:

    print(word.flag," ",word.word)
ns   胶州市

n   市长

x   江大桥
词语定位
jieba.tokenize(sen,mode):mode可以设置为search,开启搜索模式
index= jieba.tokenize(sen)

for i in index:

    print(i[0],"from",i[1],"to",i[2])
胶州市 from 0 to 3

市长 from 3 to 5

江大桥 from 5 to 8
内部算法
- 基于Trie树结构实现高效的词图扫描,生成句子中汉字所有可能成词情况所构成的有向无环图(DAG)
- 采用了动态规划查找最大概率路径, 找出基于词频的最大切分组合
- 对于未登录词,采用了基于汉字成词能力的HMM模型,使用了Viterbi算法。
参考文献
中文分词中的战斗机-jieba库的更多相关文章
- SCWS中文分词,向xdb词库添加新词
SCWS是个不错的中文分词解决方案,词库也是hightman个人制作,总不免有些不尽如人意的地方.有些词语可能不会及时被收入词库中. 幸好SCWS提供了词库XDB导出导入词库的工具(phptool_f ...
- Hanlp在java中文分词中的使用介绍
项目结构 该项目中,.jar和data文件夹和.properties需要从官网/github下载,data文件夹下载 项目配置 修改hanlp.properties: 1 #/Test/src/han ...
- 结巴(jieba)中文分词及其应用实践
中文文本分类不像英文文本分类一样只需要将单词一个个分开就可以了,中文文本分类需要将文字组成的词语分出来构成一个个向量.所以,需要分词. 这里使用网上流行的开源分词工具结巴分词(jieba),它可以有效 ...
- 如何运用jieba库分词
使用jieba库分词 一.什么是jieba库 1.jieba库概述 jieba是优秀的中文分词第三方库,中文文本需要通过分词获得单个词语. 2.jieba库的使用:(jieba库支持3种分词模式) 通 ...
- 运用jieba库分词
代码: 统计出团队中文简介中词频 import jieba txt=open("C:\\Users\\Administrator\\Desktop\\介绍.txt","r ...
- NLP舞动之中文分词浅析(一)
一.简介 针对现有中文分词在垂直领域应用时,存在准确率不高的问题,本文对其进行了简要分析,对中文分词面临的分词歧义及未登录词等难点进行了介绍,最后对当前中文分词实现的算法原理(基于词表. ...
- HMM(隐马尔科夫)用于中文分词
隐马尔可夫模型(Hidden Markov Model,HMM)是用来描述一个含有隐含未知参数的马尔可夫过程. 本文阅读了2篇blog,理解其中的意思,附上自己的代码,共同学习. 一.理解隐马尔科夫 ...
- R语言中文分词包jiebaR
R语言中文分词包jiebaR R的极客理想系列文章,涵盖了R的思想,使用,工具,创新等的一系列要点,以我个人的学习和体验去诠释R的强大. R语言作为统计学一门语言,一直在小众领域闪耀着光芒.直到大数据 ...
- 开源中文分词工具探析(四):THULAC
THULAC是一款相当不错的中文分词工具,准确率高.分词速度蛮快的:并且在工程上做了很多优化,比如:用DAT存储训练特征(压缩训练模型),加入了标点符号的特征(提高分词准确率)等. 1. 前言 THU ...
随机推荐
- .NET遇上Docker - Harbor的安装与基本使用
Harbor是一个开源企业级Docker注册中心,可以用于搭建私有的Docker Image仓库.可以实现权限控制等. 安装Harbor 首先,需要安装Docker和Docker Compose,参考 ...
- NPOI操作类
using System; using System.Data; using System.Configuration; using System.Web; using System.Web.Secu ...
- python入门编程之基础
Python, 是一种面向对象.解释型计算机程序设计语言.Python语法简洁清晰,特色之一是强制用空白符作为语句缩进.Python的设计哲学是"优雅"."明确" ...
- TomCat杀进程
有时候当你的tomcat启动时会发现 因为报以下的错误: "Several ports ( 8080, 8009) required by Tomcat v6.0 Server at loc ...
- 修改linux系统时间和同步
date 查看当前时间 date -s 15:14:13 修改时间 cp /usr/share/zoneinfo/Asia/Shanghai /etc/localtime 修改时区 yes cront ...
- IDEA第一章----下载安装idea,设置背景字体编码,配置JDK/Maven
写在前面的话: 在程序的世界混迹了5年+,认真过,蹉跎过,回首突然发现自己得到的东西却很少.于是想写点东西记录下学习.工作抑或生活的种种,人生不只是眼前的苟且还有诗和远方,任沧海桑田韶华不在,愿无岁月 ...
- IOC容器的依赖注入
1.依赖注入发生的时间 当Spring IoC容器完成了Bean定义资源的定位.载入和解析注册以后,IoC容器中已经管理类Bean定义的相关数据,但是此时IoC容器还没有对所管理的Bean进行依赖注入 ...
- C语言学习第四章
今天学习C语言循环结构,为什么要用循环呢?因为有时候我们对一堆的数字进行重复的处理的时候要重复的编写一些相同或者差不多的代码,让程序显得很臃肿,而且写着也麻烦,如果用循环来写的话能简化很多,出错的话也 ...
- 物理提取大绝招”Advanced ADB”???
近来手机取证有个极为重大的突破,是由手机取证大厂Cellebrite所率先发表的"Advanced ADB" 物理提取方法,此功能已纳入其取证设备产品UFED 6.1之中. 这个所 ...
- 学习Spark——环境搭建(Mac版)
大数据情结 还记得上次跳槽期间,与很多猎头都有聊过,其中有一个猎头告诉我,整个IT跳槽都比较频繁,但是相对来说,做大数据的比较"懒"一些,不太愿意动.后来在一篇文中中也证实了这一观 ...