
How to Reuse Old PCs for Solr Search Platform?
家裡或公司的舊電腦不夠力? 效能慢到想砸爛它們? 朋友或同事有電腦要丟嗎? 我有一個廢物利用的方法, 我收集了四台舊電腦, 組了一個Fully Distributed Mode的Hadoop Cluster, 在Hadoop上架了Hbase, 執行Nutch, 儲存Solr的資料在Hbase。
PC Specs
| Name | CPU | RAM |
|---|---|---|
| pigpigpig-client2 | T2400 1.82GHz | 2GB |
| pigpigpig-client4 | E7500 2.93GHz | 4GB |
| pigpigpig-client5 | E2160 1.80GHz | 4GB |
| pigpigpig-client6 | T7300 2.00GHz | 2GB |
Roles
| Name | Roles |
|---|---|
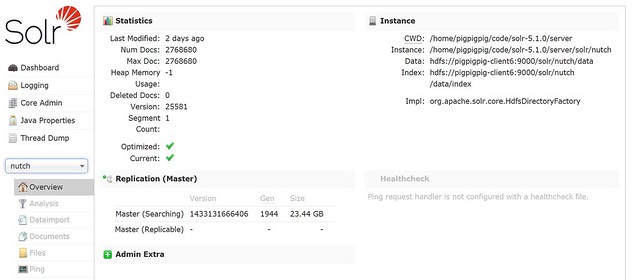
| pigpigpig-client2 | HQuorumPeer, SecondaryNameNode, ResourceManager, Solr |
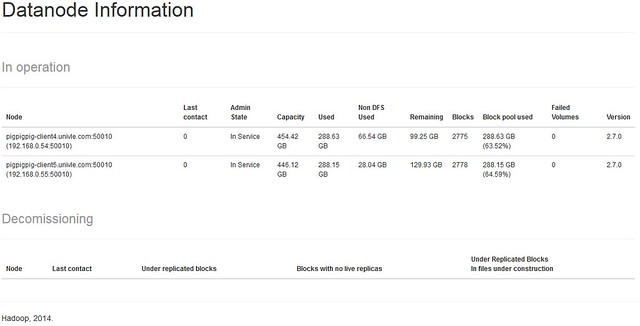
| pigpigpig-client4 | NodeManager, HRegionServer, DataNode |
| pigpigpig-client5 | NodeManager, HRegionServer, DataNode |
| pigpigpig-client6 | NameNode, HMaster, Nutch |
Version
- Hadoop 2.7.0
- Hbase 0.98.8-hadoop2
- Gora 0.6.1-SNAPSHOT (P.S. 此時此刻官網尚未正式release, 請參考Build Apache Gora With Solr 5.1.0)
- Nutch 2.4-SNAPSHOT (P.S. 此時此刻官網尚未正式release, 請參考Build Apache Nutch with Solr 5.1.0)
Configuration
剛開始執行Nutch時, 並沒有特別修改預設的設定檔, 每次經過大約10小時, RegionServer一定會發生隨機crash, 錯誤訊息大概都是Out Of Memory之類的, 我們的限制是資源有限, 舊電腦已經無法升級, 不像EC2是資源不夠就能升級, 所以performance tuning對我們是很重要的議題。
in hadoop-env.sh
記憶體很珍貴, 因為只有兩個DATANODE, 不需要預設的512MB那麼多, 全部減半
export HADOOP_NAMENODE_OPTS=“-Dhadoop.security.logger=${HADOOP_SECURITY_LOGGER:-INFO,RFAS} -Dhdfs.audit.logger=${HDFS_AUDIT_LOGGER:-INFO,NullAppender} $HADOOP_NAMENODE_OPTS -Xmx256m”
export HADOOP_DATANODE_OPTS=“-Dhadoop.security.logger=ERROR,RFAS $HADOOP_DATANODE_OPTS -Xmx256m”
export HADOOP_SECONDARYNAMENODE_OPTS=“-Dhadoop.security.logger=${HADOOP_SECURITY_LOGGER:-INFO,RFAS} -Dhdfs.audit.logger=${HDFS_AUDIT_LOGGER:-INFO,NullAppender} $HADOOP_SECONDARYNAMENODE_OPTS -Xmx256m”
export HADOOP_PORTMAP_OPTS=“-Xmx256m $HADOOP_PORTMAP_OPTS”
export HADOOP_CLIENT_OPTS=“-Xmx256m $HADOOP_CLIENT_OPTS”
in hdfs-site.xml
為了避免hdfs timeout errors, 延長timeout的時間
1 |
|
in mapred-env.sh
export HADOOP_JOB_HISTORYSERVER_HEAPSIZE=256
in mapred-site.xml
CPU效能不好, node不夠多, mapred.task.timeout調高一點, 免得mapreduce來不及做完, 尤其nutch inject、generate、fetch、parse、updatedb執行幾輪之後, 每次處理的資料都幾百萬筆, timeout太低會做不完。
1 |
|
in yarn-env.sh
JAVA_HEAP_MAX=-Xmx256m
YARN_HEAPSIZE=256
in yarn-site.xml
4GB的RAM要分配給OS、NodeManager、HRegionServer和DataNode, 資源實在很緊。分派一半的記憶體給YARN, 所以yarn.nodemanager.resource.memory-mb設成2048; 每個CPU有2個core, 所以mapreduce.map.memory.mb、mapreduce.reduce.memory.mb和yarn.scheduler.maximum-allocation-mb設成1024。yarn.nodemanager.vmem-pmem-ratio設高一點避免出現類似 “running beyond virtual memory limits. Killing container"之類的錯誤。
1 |
|
in hbase-env.sh
# export HBASE_HEAPSIZE=1000
export HBASE_MASTER_OPTS=“$HBASE_MASTER_OPTS $HBASE_JMX_BASE -Xmx192m -Xms192m -Xmn72m”
export HBASE_REGIONSERVER_OPTS=“$HBASE_REGIONSERVER_OPTS $HBASE_JMX_BASE -Xmx1024m -Xms1024m -verbose:gc -Xloggc:/mnt/hadoop-2.4.1/hbase/logs/hbaseRgc.log -XX:+PrintAdaptiveSizePolicy -XX:+PrintGC -XX:+PrintGCDetails -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/mnt/hadoop-2.4.1/hbase/logs/java_pid{$$}.hprof”
export HBASE_ZOOKEEPER_OPTS=“$HBASE_ZOOKEEPER_OPTS $HBASE_JMX_BASE -Xmx192m -Xms72m”
in hbase-site.xml
RegionServer發生out of memory閃退跟hbase.hregion.max.filesize、hbase.hregion.memstore.flush.size和hbase.hregion.memstore.block.multiplier有關。
hbase.hregion.max.filesize太小的缺點
- 每台ResrionServer的Regions會太多 (P.S. 每個region的每個ColumnFamily會占用2MB的MSLAB)
- 造成頻繁的split和compact
- 開啟的storefile數量太多 (P.S. Potential Number of Open Files = (StoreFiles per ColumnFamily) x (regions per RegionServer))
hbase.hregion.max.filesize太大的缺點
- 太少Region, 沒有Distributed Mode的效果了
- split和compact時的pause也會過久
write buffer在server-side memory-used是(hbase.client.write.buffer) * (hbase.regionserver.handler.count), 所以hbase.client.write.buffer和hbase.regionserver.handler.count太高會吃掉太多記憶體, 但是太少會增加RPC的數量。
hbase.zookeeper.property.tickTime和zookeeper.session.timeout太短會造成ZooKeeper SessionExpired。hbase.ipc.warn.response.time設長一點可以suppress responseTooSlow warning。
hbase.hregion.memstore.flush.size和hbase.hregion.memstore.block.multiplier也會影響split和compact的頻率。
1 |
|
Start Servers
- run hdfs namenode -format on pigpigpig-client6
- run start-dfs.sh on pigpigpig-client6
- run start-yarn.sh on pigpigpig-client2
- run start-yarn.sh on pigpigpig-client4
- run start-hbase.sh on pigpigpig-client6
- run java -Xmx1024m -Xms1024m -XX:+UseConcMarkSweepGC -jar start.jar in solr folder on pigpigpig-client2
- run hadoop fs -mkdir /user;hadoop fs -mkdir /user/pigpigpig;hadoop fs -put urls /user/pigpigpig in nutch folder on pigpigpig-client6
- run hadoop jar apache-nutch-2.4-SNAPSHOT.job org.apache.nutch.crawl.InjectorJob urls -crawlId webcrawl in nutch folder on pigpigpig-client6
- run hadoop jar apache-nutch-2.4-SNAPSHOT.job org.apache.nutch.crawl.GeneratorJob -crawlId webcrawl in nutch folder on pigpigpig-client6
- run hadoop jar apache-nutch-2.4-SNAPSHOT.job org.apache.nutch.fetcher.FetcherJob -all -crawlId webcrawl in nutch folder on pigpigpig-client6
- run hadoop jar apache-nutch-2.4-SNAPSHOT.job org.apache.nutch.parse.ParserJob -all -crawlId webcrawl in nutch folder on pigpigpig-client6
- run hadoop jar apache-nutch-2.4-SNAPSHOT.job org.apache.nutch.crawl.DbUpdaterJob -all -crawlId webcrawl in nutch folder on pigpigpig-client6
- run hadoop jar apache-nutch-2.4-SNAPSHOT.job org.apache.nutch.indexer.IndexingJob -D solr.server.url=http://pigpigpig-client2/solr/nutch/ -all -crawlId webcrawl in nutch folder on pigpigpig-client6
Stop Servers
- run stop-hbase.sh on pigpigpig-client6
- run stop-yarn.sh on pigpigpig-client2
- run stop-yarn.sh on pigpigpig-client4
- run stop-dfs.sh on pigpigpig-client6
Screenshots

Resources
- 完整Configuration files請到https://github.com/EugenePig/Experiment1下載
- https://github.com/EugenePig/Gora/tree/Gora-0.6.1-SNAPSHOT-Hadoop27-Solr5
- https://github.com/EugenePig/nutch/tree/2.4-SNAPSHOT-Hadoop27-Solr5
- https://github.com/EugenePig/ik-analyzer-solr5
How to Reuse Old PCs for Solr Search Platform?的更多相关文章
- Custom SOLR Search Components - 2 Dev Tricks
I've been building some custom search components for SOLR lately, so wanted to share a couple of thi ...
- solr search基础知识(控制符及其参数)
1.^ 控制符 (1)查询串上用^ 搜索: 天后王菲,如果希望将王菲的相关度加大,用^控制符. 天后 王菲^10.5 结果就会将含有王菲的document权重加大分数提高,排序靠前,10.5为权重 ...
- Spring Boot Reference Guide
Spring Boot Reference Guide Authors Phillip Webb, Dave Syer, Josh Long, Stéphane Nicoll, Rob Winch, ...
- 资源list:Github上关于大数据的开源项目、论文等合集
Awesome Big Data A curated list of awesome big data frameworks, resources and other awesomeness. Ins ...
- Awesome Big Data List
https://github.com/onurakpolat/awesome-bigdata A curated list of awesome big data frameworks, resour ...
- java框架之SpringBoot(1)-入门
简介 Spring Boot 用来简化 Spring 应用开发,约定大于配置,去繁从简,just run 就能创建一个独立的.产品级别的应用. 背景: J2EE 笨重的开发.繁多的配置.低下的开发效率 ...
- spring boot 项目搭建时,各个依赖的作用
项目搭建页面 https://start.spring.io/ 各个依赖的作用 List of dependencies for Spring Boot 2.1.5.RELEASE Core DevT ...
- 什么是Spring Boot简介
1.什么是spring boot 简单的说,spring boot就是整合了很多优秀的框架,不用我们自己手动的去写一堆xml配置然后进行配置. 从本质上来说,Spring Boot就是Spring,它 ...
- 搭建Spring Initializr服务器
前言 按照网上很多教程,出错特别多.首先是GitHub和maven仓库的网络环境比较差,踩了很多坑:其次是SpringInitializr更新迭代几个版本,0.7.0我也没能弄成功.索性就用了旧版本0 ...
随机推荐
- svn log笔记
背景: svn,版本 1.7.8 以下所有命令直接和svn服务器进行交互并没有checkout代码到本地 1.查询分支从拉出来到现在的变更: svn log branche_url --stop-on ...
- maven org.apache.tomcat.util.bcel.classfile.ClassFormatException: Invalid byte tag in constant pool: 60
maven org.apache.tomcat.util.bcel.classfile.ClassFormatException: Invalid byte tag in constant poo ...
- 像烟瘾一样的Adobe Flash,真的戒不掉吗?
近来对Adobe Flash来说真是段难过的日子.Hacking Team公司外泄的440GB电子邮件数据已成为黑客挖掘安全漏洞的宝藏. 光是Flash就被发现了三个不同的漏洞: l CVE-201 ...
- Linux 禁止用户或 IP通过 SSH 登录
一切都是为了安全,做到来着可知! 限制用户 SSH 登录 1.只允许指定用户进行登录(白名单): 在 /etc/ssh/sshd_config 配置文件中设置 AllowUsers ...
- 题目:vbs批量开通工具,实现vbs开通的ux设计和流程调度
题目:vbs批量开通工具,实现vbs开通的ux设计和流程调度 需求点:支持开通前检查(检查失败不允许开站),开通过程监控,开通后业务检验,失败后重新开通,支持部分站点开通(比如用户导入的模板中有10个 ...
- 执行Android项目时指定特定的AVD进行測试
一个Androidproject空间能够创建一个或多个AVD来对指定的Android项目进行測试,假设仅仅创建了一个AVD则执行Android项目时自然启动该AVD,但是假设创建了多个AVD那么我们该 ...
- 【QRcode二维码】:使用JS前端插件QRcode.js生成二维码
1.先简单说一下jquery-qrcode,这个开源的三方库(可以从https://github.com/jeromeetienne/jquery-qrcode 获取), qrcode.js 是实现二 ...
- NET的基本用法(摘)
摘自:http://baike.baidu.com/link?url=Knc-OicoX8CPcaMS0r3eU8z8ns9z1S6OsRaBTYUIT1raU0FsPWQ35xL-dlxKg9Oy# ...
- 机器学习中的 ground truth
维基百科关于 ground truth的解释: [Ground truth] 大致为: 在统计学和机器学习中:在机器学习中ground truth表示有监督学习的训练集的分类准确性,用于证明或者推翻某 ...
- JavaScript 设计模式之建造者模式
一.建造者模式概念解读 1.建造者模式概念文字解读 建造者模式可以将一个复杂对象的构建与其表示分离,使得同样的构建过程可以创建不同的表示.也就是说如果我们用了建造者模式,那么用户就需要指定需要建造的类 ...