
Python爬虫学习 - day2 - 站点登陆
利用Python完成简单的站点登陆
最近学习到了爬虫,瞬时觉得很高大上,想取什么就取什么,感觉要上天。这里分享一个简单的登陆抽屉新热榜的教程(因为它不需要验证码,目前还没有学会图像识别。哈哈),供大家学习。
需要的知识点储备
本次爬虫脚本依赖两个模块:requests模块,BeautifulSoup模块。其中requests模块完成url的请求,而BeautifulSoup模块负责解析Html标签。
主要的用法在上一讲已经列出,这里不再赘述。
思路
和爬取图片的思路是相同的,首先我们人工登陆一次,确认每次交互发送接受的数据。
打开首页查看交互信息
在浏览器里访问 http://dig.chouti.com/ 打开控制台,查看网络请求信息,发现在get请求的应答信息中包涵了cookies。
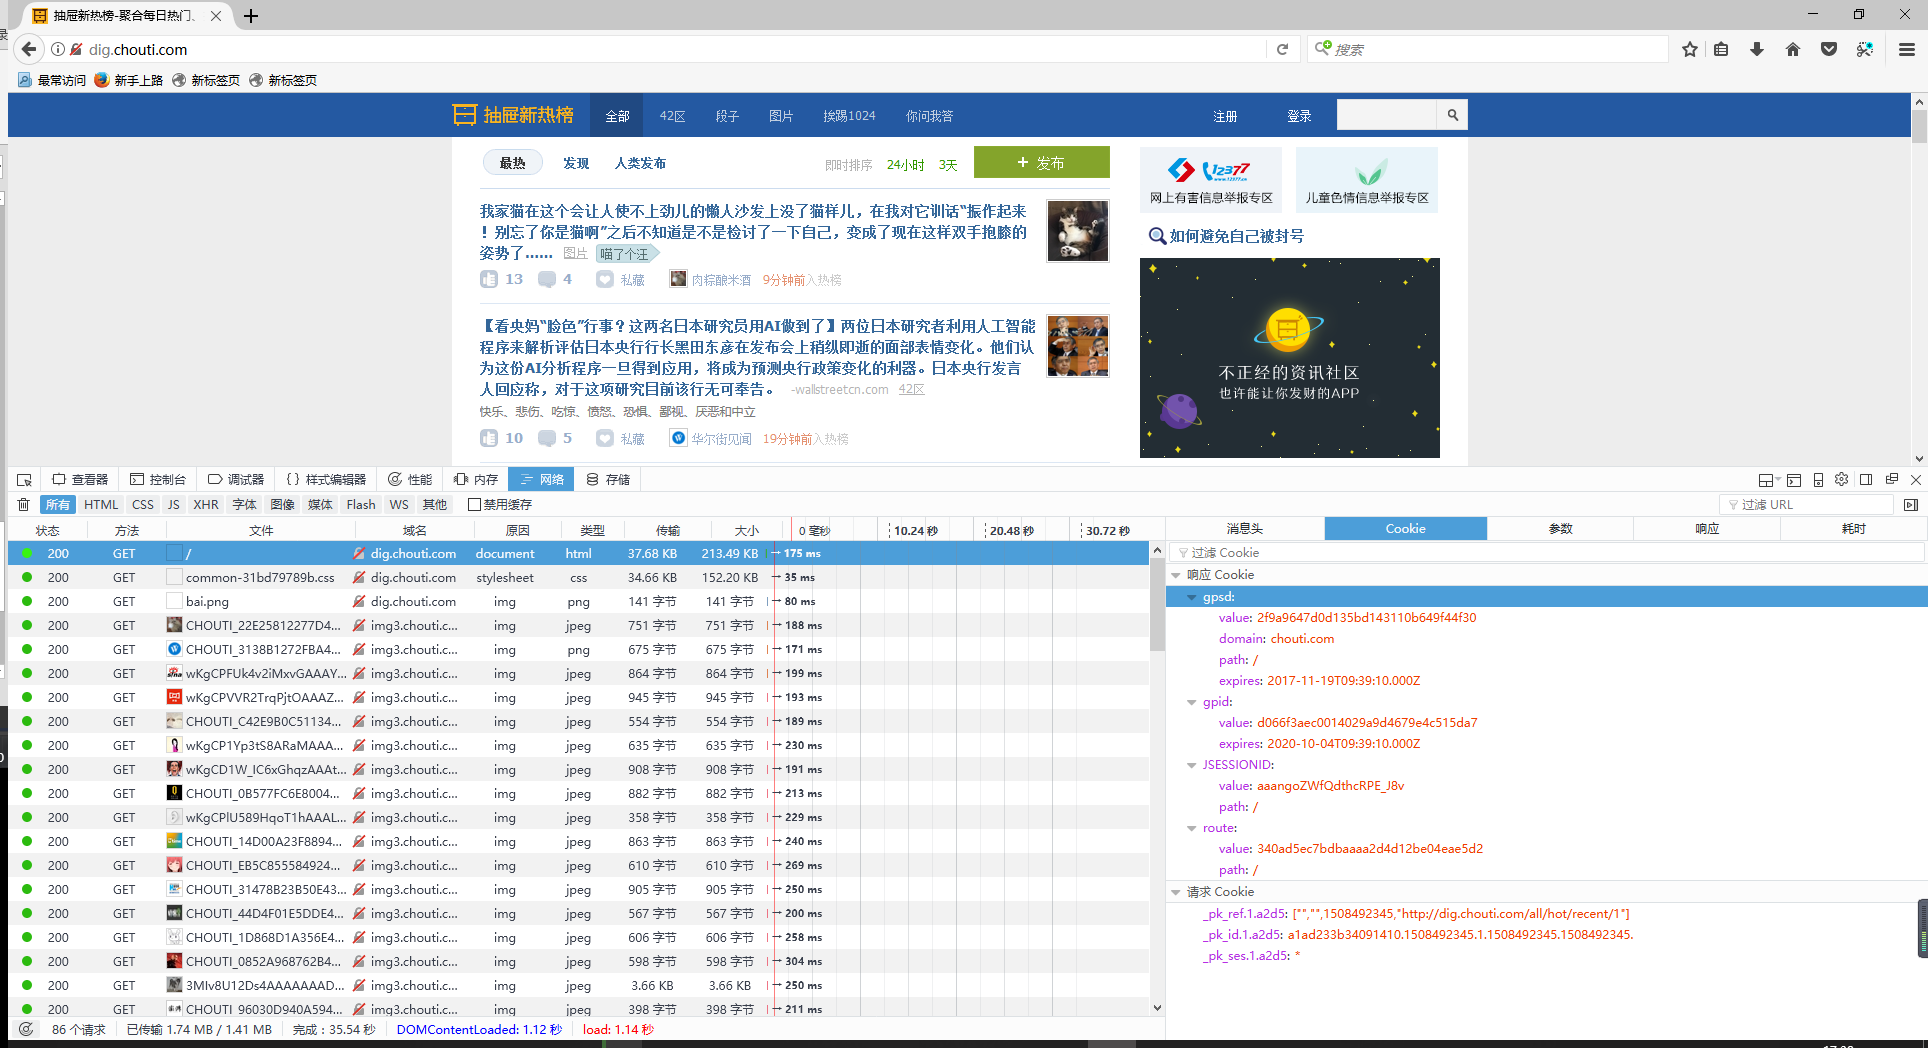
点击登陆后的交互信息
点击登陆后查看网络信息,发现只发送了用户名、密码、以及是否保存密码等参数。
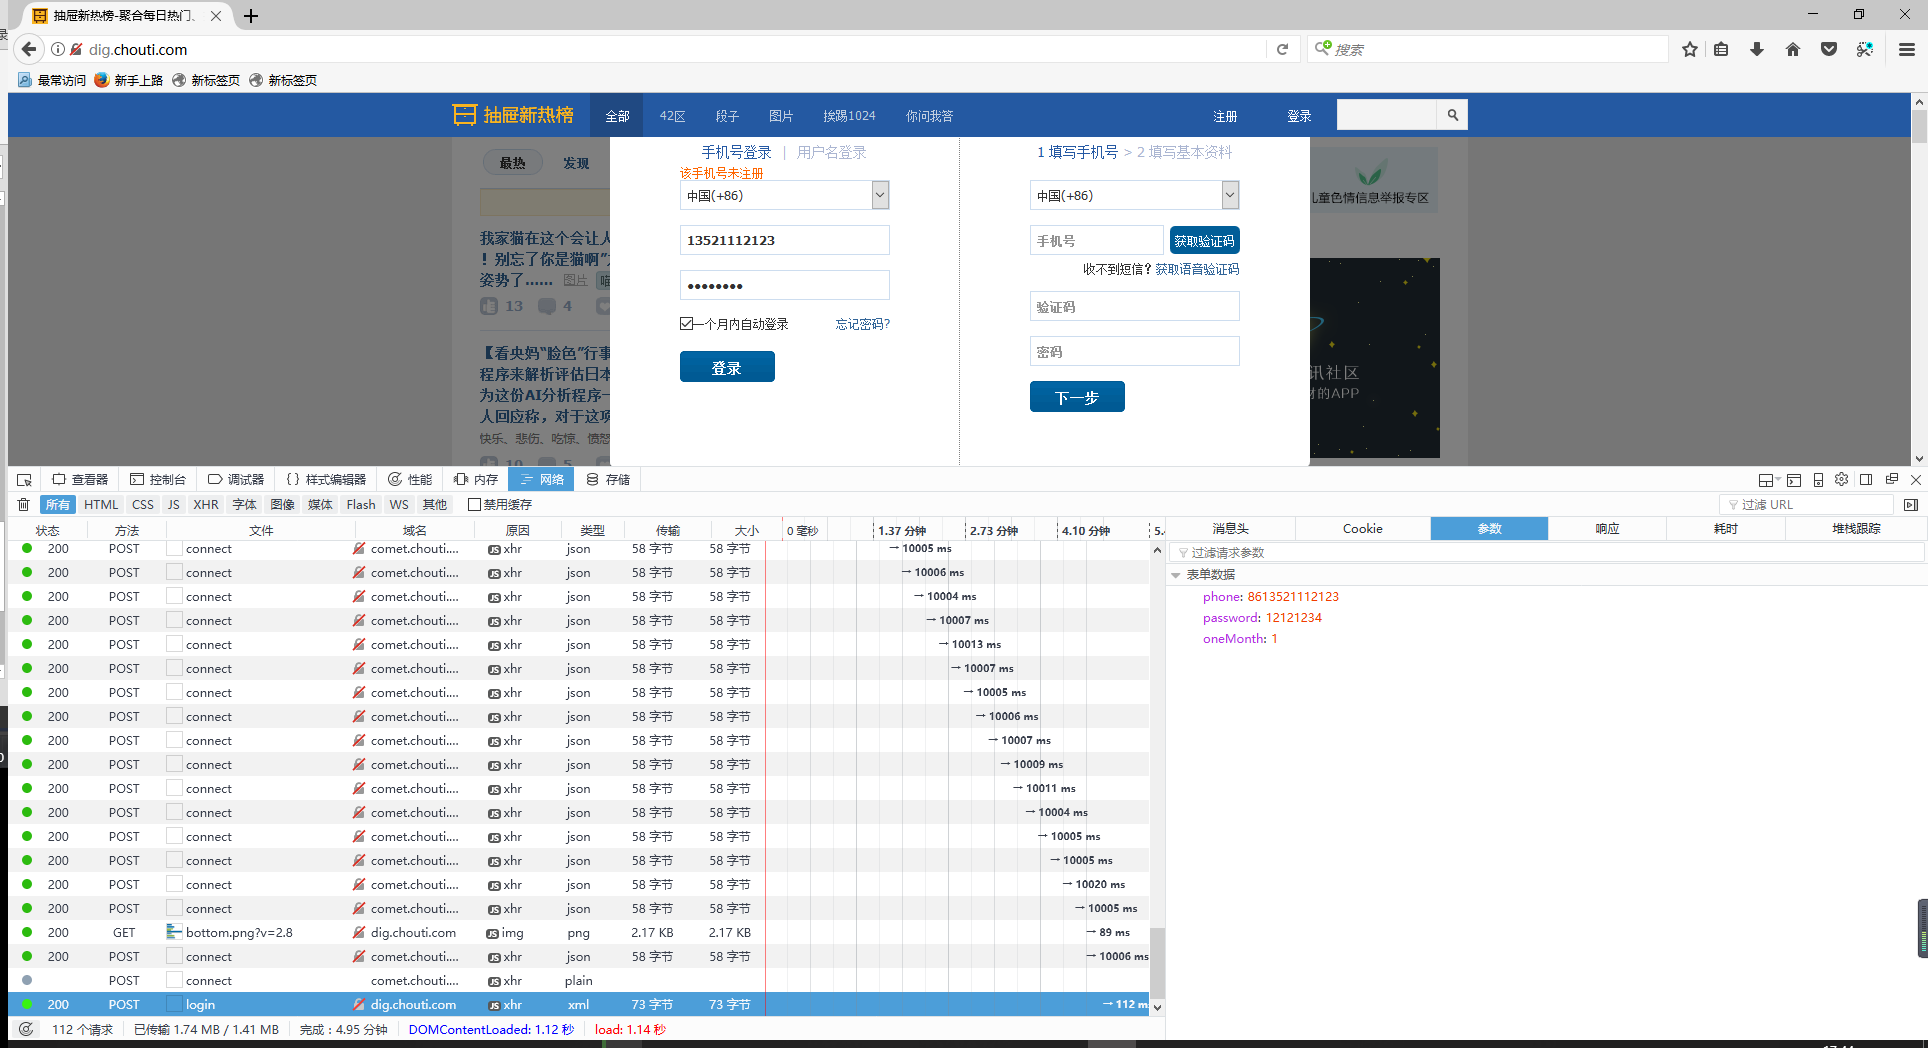
疑问:我们知道为了防止xss攻击,网站都会做一些基础的防护,比如csrf_token等,但是这里并没有看到携带什么token数据,难道是抽屉没有进行防护吗?其实不是的,目前大部分网站都采用的方式是,第一个get请求会发送未认证的cookie,当用户登陆时携带该cookies,服务端对cookies进行认证,如果登陆时没有携带cookies,服务端将会拒绝服务,所以我们要记录第一个get请求的cookies。
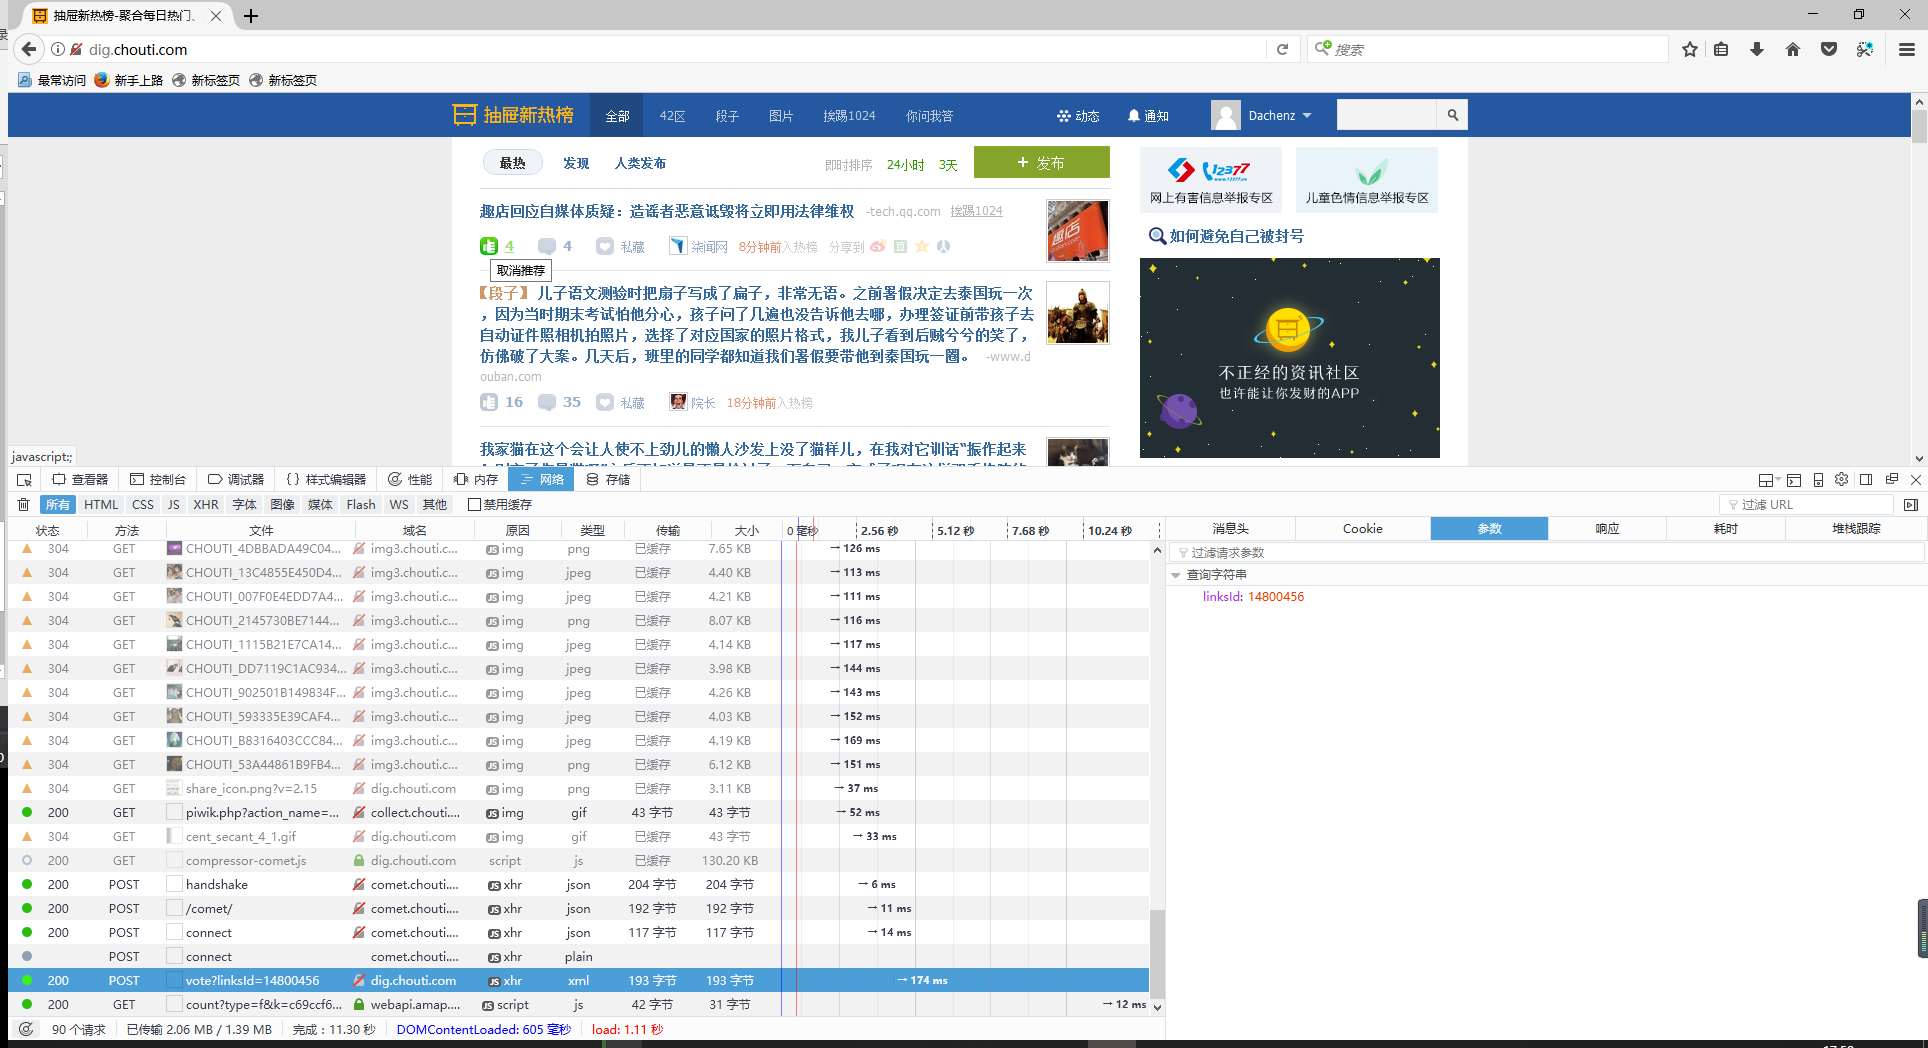
点赞后提交的信息
通过查看网络交互信息后发现,点赞后,只是向服务端发送了文章的ID。
流程
根据以上思路得出以下步骤:
- 发送get请求获取页面信息,储存cookies信息
- 向登陆页发送post请求,携带cookies信息
- 由于返回了两次cookies,保险起见,创建一个cookies字典,把多次返回的cookies,一一存储后整体提交。
- 登陆成功后,找到看到的所有文章标签,获取它的linksid
- 发送post请求携带linksid,进行点赞操作
完成的代码
import requests

from bs4 import BeautifulSoup

# get请求cookies

response = requests.get('http://dig.chouti.com/')

get_cookies = response.cookies

# post请求cookies

response = requests.post('http://dig.chouti.com/login',

                         data={

                             'phone':8613526773228,

                             'password': 'aini3845',

                             'oneMonth': '1',

                         },

                         cookies=get_cookies

                         )

login_cookies = response.cookies

# 组件cookies

all_cookies = {}

all_cookies.update(get_cookies)

all_cookies.update(login_cookies)

# 查询文章列表

response = requests.get('http://dig.chouti.com/',cookies=all_cookies)

soup = BeautifulSoup(response.text,'html.parser')

tag = soup.find(id="content-list")

# 点赞的前缀url

urls = 'http://dig.chouti.com/link/vote'

# 点赞操作

for item in tag.find_all(name='div',attrs={'class':'part2'}):

    if item.get('share-linkid'):

        link_id = item.get('share-linkid')

        response = requests.post(urls+'?linksId=%s' % link_id,cookies=all_cookies)

        print(response.text)
Python爬虫学习 - day2 - 站点登陆的更多相关文章
- Python爬虫学习笔记——豆瓣登陆(一)
#-*- coding:utf-8 -*- import requests from bs4 import BeautifulSoup import html5lib import re import ...
- Python爬虫学习笔记——豆瓣登陆(三)
之前是不会想到登陆一个豆瓣会需要写三次博客,修改三次代码的. 本来昨天上午之前的代码用的挺好的,下午时候,我重新注册了一个号,怕豆瓣大号被封,想用小号爬,然后就开始出问题了,发现无法模拟登陆豆瓣了,开 ...
- Python爬虫学习笔记——豆瓣登陆(二)
昨天能够登陆成功,但是不能使用cookies,今天试了一下requests库的Session(),发现可以保持会话了,代码只是稍作改动. #-*- coding:utf-8 -*- import re ...
- python爬虫学习 —— 总目录
开篇 作为一个C党,接触python之后学习了爬虫. 和AC算法题的快感类似,从网络上爬取各种数据也很有意思. 准备写一系列文章,整理一下学习历程,也给后来者提供一点便利. 我是目录 听说你叫爬虫 - ...
- python爬虫学习(1) —— 从urllib说起
0. 前言 如果你从来没有接触过爬虫,刚开始的时候可能会有些许吃力 因为我不会从头到尾把所有知识点都说一遍,很多文章主要是记录我自己写的一些爬虫 所以建议先学习一下cuiqingcai大神的 Pyth ...
- Python爬虫学习:三、爬虫的基本操作流程
本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:三.爬虫的基本操作与流程 一般我们使用Python爬虫都是希望实现一套完整的功能,如下: 1.爬虫目标数据.信息: 2.将 ...
- Python爬虫学习:四、headers和data的获取
之前在学习爬虫时,偶尔会遇到一些问题是有些网站需要登录后才能爬取内容,有的网站会识别是否是由浏览器发出的请求. 一.headers的获取 就以博客园的首页为例:http://www.cnblogs.c ...
- Python爬虫学习:二、爬虫的初步尝试
我使用的编辑器是IDLE,版本为Python2.7.11,Windows平台. 本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:二.爬虫的初步尝试 1.尝试抓取指定网页 ...
- 《Python爬虫学习系列教程》学习笔记
http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多.学习过程中我把一些学习的笔记总结下来,还记录了一些自己 ...
随机推荐
- 6.0 实现app登录
1.0.0:学习ui自动化准备工作 待测app,我这里有准备两个apk,这两个都是我曾经做过的项目,后续的文章都是基于这两个app! 链接:https://pan.baidu.com/s/1I0vR9 ...
- const char and static const char
部分内容摘自:https://blog.csdn.net/ranhui_xia/article/details/32696669 The version with const char * will ...
- Spring 学习笔记(八)—— 注解使用整合
@Autowired —— 自动装配 需先在配置文件中,配置一个org.springframework.beans.factory.annotation. AutowiredAnnotationBe ...
- hash function比较
http://blog.csdn.net/kingstar158/article/details/8028635 由于工作需要,针对千万级别的数据,使用stl::map着实存在着效率问题,最后使用bo ...
- Java基础——集合
java的集合类是一个工具类,存放在java.util包中.它不仅可以存储对象,也可以实现常用数据结构,如栈.队列等.严格的说,集合类存放的是对象的引用,而不是对象本身. java集合主要由这两个接口 ...
- C++关于堆的函数
建立堆 make_heap(_First, _Last, _Comp) 默认是建立最大堆的.对int类型,可以在第三个参数传入greater<int>()得到最小堆. 在堆中添加数据 ...
- 背景图片移动插件MyFloatingBg(浮动背景图效果,可让背景随着页面的滚动而滚动)
MyFloatingBg这插件可以帮助你在网页上加入可移动背景Background.你可以用于整个文件的背景,或是某几个banner的背景. 它可支持简单的animation效果,你不用去做一个fla ...
- 【算法】高斯消元&线性代数
寒假作业~就把文章和题解3道题的代码扔在这里啦——链接: https://pan.baidu.com/s/1kWkGnxd 密码: bhh9 1.HNOI2013游走 #include <bit ...
- [Leetcode] climbing stairs 爬楼梯
You are climbing a stair case. It takes n steps to reach to the top. Each time you can either climb ...
- [SDOI2010]星际竞速——费用流
类似于最短路的网络流,而且还要保证每个点经过一次,拆点就比较方便了. 连边怎么连?要保证最大流是n(每个点经过一次)还要能从直接跳转 将每个点拆点.源点向每个点的入点连一条容量为1费用为0的边.源点向 ...