
NMI计算
NMI计算
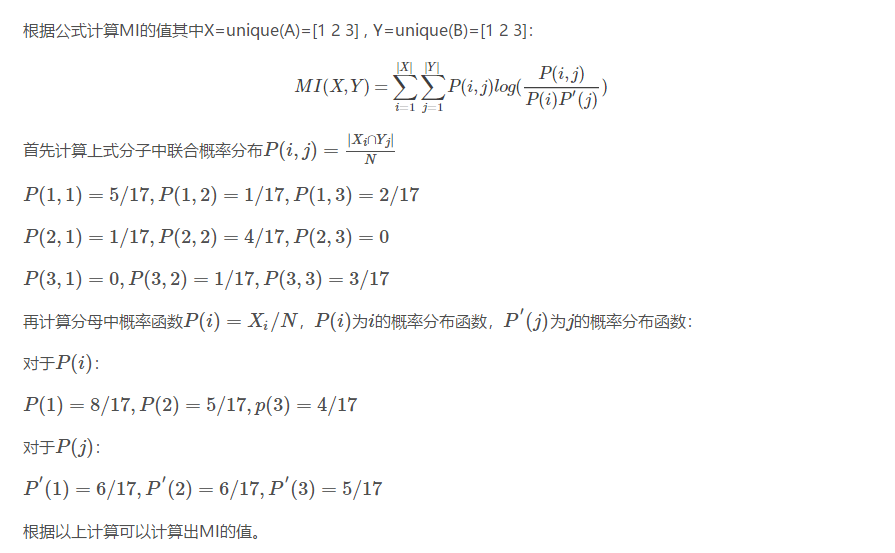
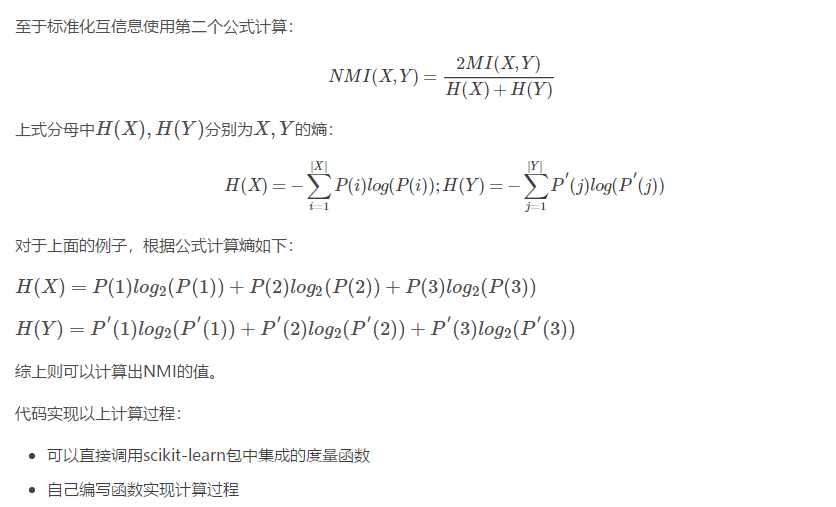
NMI(Normalized Mutual Information)标准化互信息,常用在聚类中,度量两个聚类结果的相近程度。是社区发现(community detection)的重要衡量指标,基本可以比较客观地评价出一个社区划分与标准划分之间相比的准确度。NMI的值域是0到1,越高代表划分得越准。
# -*- coding:utf-8 -*-

'''

Created on 2017年10月28日

@summary: 利用Python实现NMI计算

@author: dreamhome

'''

import math

import numpy as np

from sklearn import metrics

def NMI(A,B):

    #样本点数

    total = len(A)

    A_ids = set(A)

    B_ids = set(B)

    #互信息计算

    MI = 0

    eps = 1.4e-45

    for idA in A_ids:

        for idB in B_ids:

            idAOccur = np.where(A==idA)

            idBOccur = np.where(B==idB)

            idABOccur = np.intersect1d(idAOccur,idBOccur)

            px = 1.0*len(idAOccur[0])/total

            py = 1.0*len(idBOccur[0])/total

            pxy = 1.0*len(idABOccur)/total

            MI = MI + pxy*math.log(pxy/(px*py)+eps,2)

    # 标准化互信息

    Hx = 0

    for idA in A_ids:

        idAOccurCount = 1.0*len(np.where(A==idA)[0])

        Hx = Hx - (idAOccurCount/total)*math.log(idAOccurCount/total+eps,2)

    Hy = 0

    for idB in B_ids:

        idBOccurCount = 1.0*len(np.where(B==idB)[0])

        Hy = Hy - (idBOccurCount/total)*math.log(idBOccurCount/total+eps,2)

    MIhat = 2.0*MI/(Hx+Hy)

    return MIhat

if __name__ == '__main__':

    A = np.array([1,1,1,1,1,1,2,2,2,2,2,2,3,3,3,3,3])

    B = np.array([1,2,1,1,1,1,1,2,2,2,2,3,1,1,3,3,3])

    print NMI(A,B)

    print metrics.normalized_mutual_info_score(A,B)

原文:https://blog.csdn.net/DreamHome_S/article/details/78379635
# coding=utf-8

import numpy as np

import math

def NMI(A,B):

    # len(A) should be equal to len(B)

    total = len(A)

    A_ids = set(A)

    B_ids = set(B)

    #Mutual information

    MI = 0

    eps = 1.4e-45

    for idA in A_ids:

        for idB in B_ids:

            idAOccur = np.where(A==idA)

            idBOccur = np.where(B==idB)

            idABOccur = np.intersect1d(idAOccur,idBOccur)

            px = 1.0*len(idAOccur[0])/total

            py = 1.0*len(idBOccur[0])/total

            pxy = 1.0*len(idABOccur)/total

            MI = MI + pxy*math.log(pxy/(px*py)+eps,2)

    # Normalized Mutual information

    Hx = 0

    for idA in A_ids:

        idAOccurCount = 1.0*len(np.where(A==idA)[0])

        Hx = Hx - (idAOccurCount/total)*math.log(idAOccurCount/total+eps,2)

    Hy = 0

    for idB in B_ids:

        idBOccurCount = 1.0*len(np.where(B==idB)[0])

        Hy = Hy - (idBOccurCount/total)*math.log(idBOccurCount/total+eps,2)

    MIhat = 2.0*MI/(Hx+Hy)

    return MIhat

if __name__ == '__main__':

    A = np.array([1,1,1,1,1,1,2,2,2,2,2,2,3,3,3,3,3])

    B = np.array([1,2,1,1,1,1,1,2,2,2,2,3,1,1,3,3,3])

    print (NMI(A,B))
网上找到的代码
结果:0.36456
自己编写了一个,同时做了排序处理
# coding=utf-8

import numpy as np

import math

import operator

def NMI(A,B):

    # len(A) should be equal to len(B)

    total = len(A)

    A_ids = set(A)

    B_ids = set(B)

    #Mutual information

    MI = 0

    eps = 1.4e-45

    for idA in A_ids:

        for idB in B_ids:

            idAOccur = np.where(A==idA)

            idBOccur = np.where(B==idB)

            idABOccur = np.intersect1d(idAOccur,idBOccur)

            px = 1.0*len(idAOccur[0])/total

            py = 1.0*len(idBOccur[0])/total

            pxy = 1.0*len(idABOccur)/total

            MI = MI + pxy*math.log(pxy/(px*py)+eps,2)

    # Normalized Mutual information

    Hx = 0

    for idA in A_ids:

        idAOccurCount = 1.0*len(np.where(A==idA)[0])

        Hx = Hx - (idAOccurCount/total)*math.log(idAOccurCount/total+eps,2)

    Hy = 0

    for idB in B_ids:

        idBOccurCount = 1.0*len(np.where(B==idB)[0])

        Hy = Hy - (idBOccurCount/total)*math.log(idBOccurCount/total+eps,2)

    MIhat = 2.0*MI/(Hx+Hy)

    return MIhat

if __name__ == '__main__':

    A = np.array([1,1,1])

    B = np.array([2,3,4])

    C = np.array([1,1,6])

    print(NMI(A,B))

    m=[]#包含了位置的互信息

    n=[]#只有互信息

    dic={}

    q=1

    m.append(NMI(A,B))

    m.append(NMI(B,C))

    m.append(NMI(A,C))

    for i in m:

        dic['第{}个互信息'.format(q)]='{}'.format(i)

        q=q+1

    print(dic)

    rankdata=sorted(dic.items(),key=operator.itemgetter(1),reverse=True)

    print(rankdata)
实验结果如图

NMI计算的更多相关文章
- 前端极易被误导的css选择器权重计算及css内联样式的妙用技巧
记得大学时候,专业课的网页设计书籍里面讲过css选择器权重的计算:id是100,class是10,html标签是5等等,然后全部加起来的和进行比较... 我只想说:真是误人子弟,害人不浅! 最近,在前 ...
- 分享一个SQLSERVER脚本(计算数据库中各个表的数据量和每行记录所占用空间)
分享一个SQLSERVER脚本(计算数据库中各个表的数据量和每行记录所占用空间) 很多时候我们都需要计算数据库中各个表的数据量和每行记录所占用空间 这里共享一个脚本 CREATE TABLE #tab ...
- C语言 · 薪水计算
问题描述 编写一个程序,计算员工的周薪.薪水的计算是以小时为单位,如果在一周的时间内,员工工作的时间不超过40 个小时,那么他/她的总收入等于工作时间乘以每小时的薪水.如果员工工作的时间在40 到50 ...
- C语言 · 阶乘计算 · 基础练习
问题描述 输入一个正整数n,输出n!的值. 其中n!=1*2*3*-*n. 算法描述 n!可能很大,而计算机能表示的整数范围有限,需要使用高精度计算的方法.使用一个数组A来表示一个大整数a,A[0]表 ...
- C语言 · 最大值与最小值计算
输入11个整数,计算它们的最大值和最小值. 样例输入 0 1 2 3 4 5 6 7 8 9 10 样例输出 10 0 #include<stdio.h> int main(){ ]; ...
- 无法向会话状态服务器发出会话状态请求。请确保 ASP.NET State Service (ASP.NET 状态服务)已启动,并且客户端端口与服务器端口相同。如果服务器位于远程计算机上,请检查。。。
异常处理汇总-服 务 器 http://www.cnblogs.com/dunitian/p/4522983.html 无法向会话状态服务器发出会话状态请求.请确保 ASP.NET State Ser ...
- SQL Server-聚焦计算列或计算列持久化查询性能(二十二)
前言 上一节我们详细讲解了计算列以及计算列持久化的问题,本节我们依然如前面讲解来看看二者查询性能问题,简短的内容,深入的理解,Always to review the basics. 持久化计算列比非 ...
- SQL Server-聚焦计算列持久化(二十一)
前言 上一节我们结束了Hash Match Aggregate和Stream Aggregate的讲解,本系列我们来讲讲关于SQL Server中的计算列问题,简短的内容,深入的理解,Always t ...
- javascript:逆波兰式表示法计算表达式结果
逆波兰式表示法,是由栈做基础的表达式,举个例子: 5 1 2 + 4 * + 3 - 等价于 5 + ((1 + 2) * 4) - 3 原理:依次将5 1 2 压入栈中, 这时遇到了运算符 + ...
随机推荐
- java 泛型的上限与下限
设置泛型对象的上限使用extends,表示参数类型只能是该类型或该类型的子类: 声明对象:类名<? extends 类> 对象名 定义类:类名<泛型标签 extends 类>{ ...
- Linux 内核总线方法
有几个给 bus_type 结构定义的方法; 它们允许总线代码作为一个设备核心和单独驱动之 间的中介. 在 2.6.10 内核中定义的方法是: int (*match)(struct device * ...
- XSS攻击及防范
1.什么是XSS攻击 跨站脚本攻击(Cross Site Scripting),攻击者往Web页面里插入恶意Script代码,当用户浏览该页之时,嵌入其中Web里面的Script代码会被执行,从而达到 ...
- openwrt上wifi探针的实现----mt7620a+rt2860v2
openwrt上wifi探针的实现----mt7620a+rt2860v2 [摘要:甚么是wifi探针 看到探针,感到很矮小上的模样,实在便是经过wifi汇集经由那个AP局限的脚机的mac地点,出有甚 ...
- 解决win10台式机插入耳机没有声音或者音量不大
没有声音 如果是插入机箱的前面板,尝试切换到后面板,因为有些组装机箱的前面板是不能用的 有声音,单音量不大(注意:并不一定适用于所有情况,但是可以尝试一下) 原因:缺少驱动,可以确定下控制面板是否有这 ...
- C++,Windows/MFC_中L和_T()之区别
字符串前面加L表示该字符串是Unicode字符串._T是一个宏,如果项目使用了Unicode字符集(定义了UNICODE宏),则自动在字符串前面加上L,否则字符串不变.因此,Visual C++里边定 ...
- 非GUI-Qt程序运行后显示Console(简单好用:在pro文件中加入: CONFIG += console)
----我的生活,我的点点滴滴!! 有很多时候,我们在程序中添加了好Debug信息,方便程序在运行期间打印出一些我们需要的信息或者,想用他来显示一些必要信息时, 那么console就太重要了,曾几何时 ...
- 老板让阿粉学习 flink 中的 Watermark,现在他出教程了
1 前言 在时间 Time 那一篇中,介绍了三种时间概念 Event.Ingestin 和 Process, 其中还简单介绍了乱序 Event Time 事件和它的解决方案 Watermark 水位线 ...
- SpringDataJpa多条件查询代码封装
package com.pantech.cloud.mlogistics.util; import com.mysql.jdbc.StringUtils; import org.springframe ...
- PrototypePattern(原型模式)-----Java/.Net
原型模式(Prototype Pattern)是用于创建重复的对象,同时又能保证性能.这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式.