
爬虫初体验:Python+Requests+BeautifulSoup抓取广播剧
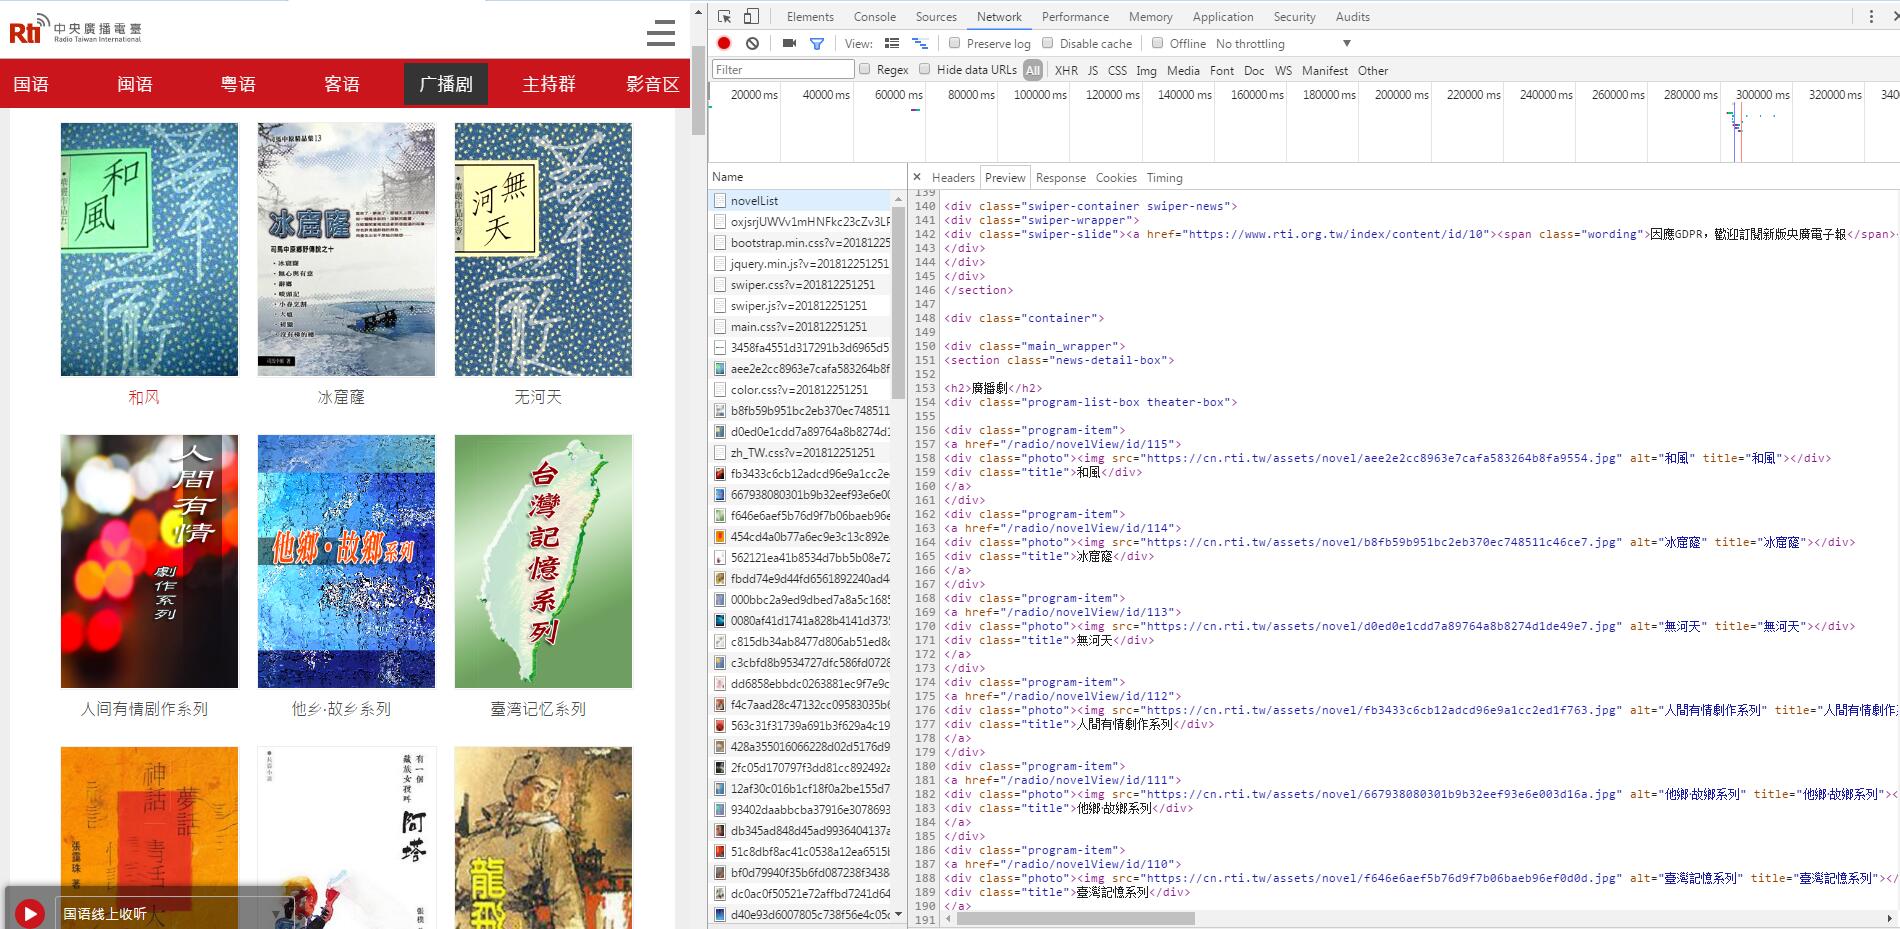
可以看到一个DIV下放一个广播剧的信息,包括名称和地址,第一步我们先收集所有广播剧的收听地址:
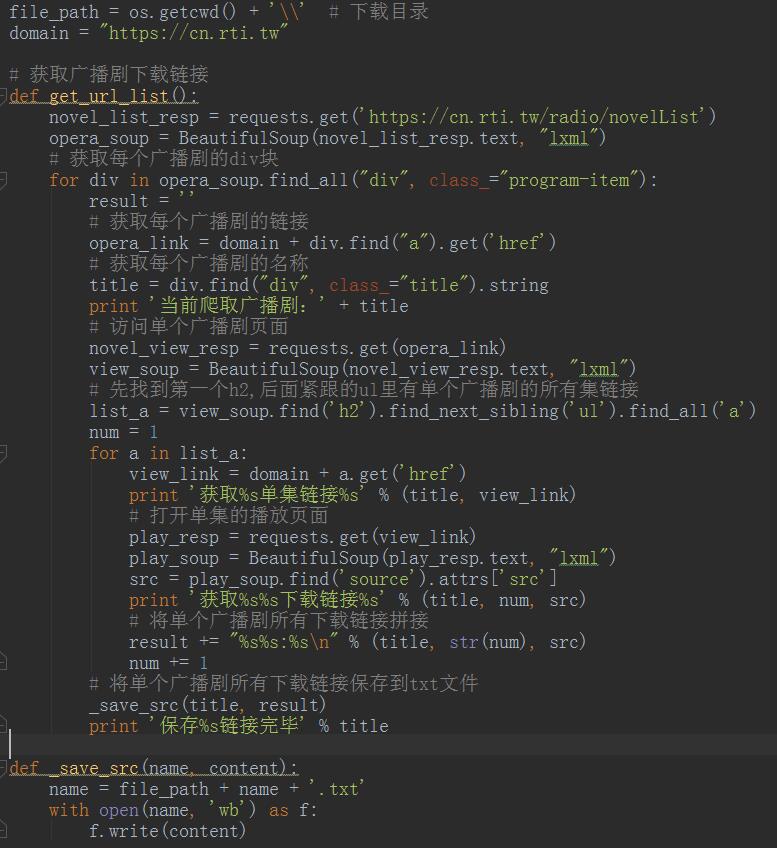
# 用requests的get方法访问
novel_list_resp = requests.get("这里放URL的地址")
# 利用上一步访问返回的结果生成一个BeautifulSoup对象
opera_soup = BeautifulSoup(novel_list_resp.text, "lxml")
# 获取所有class="program-item"的div
opera_soup.find_all("div", class_="program-item")
接着我们遍历这些div,获取每个广播剧的链接和名称:
# 找到div中的a标签,获取每个广播剧的链接
opera_link = domain + div.find("a").get('href')
# 获取每个广播剧的名称
title = div.find("div", class_="title").string
我们点击一个广播剧进去,在HTML中可以看到在ul中,每个li里都有一集的播放链接,并且是按顺序的。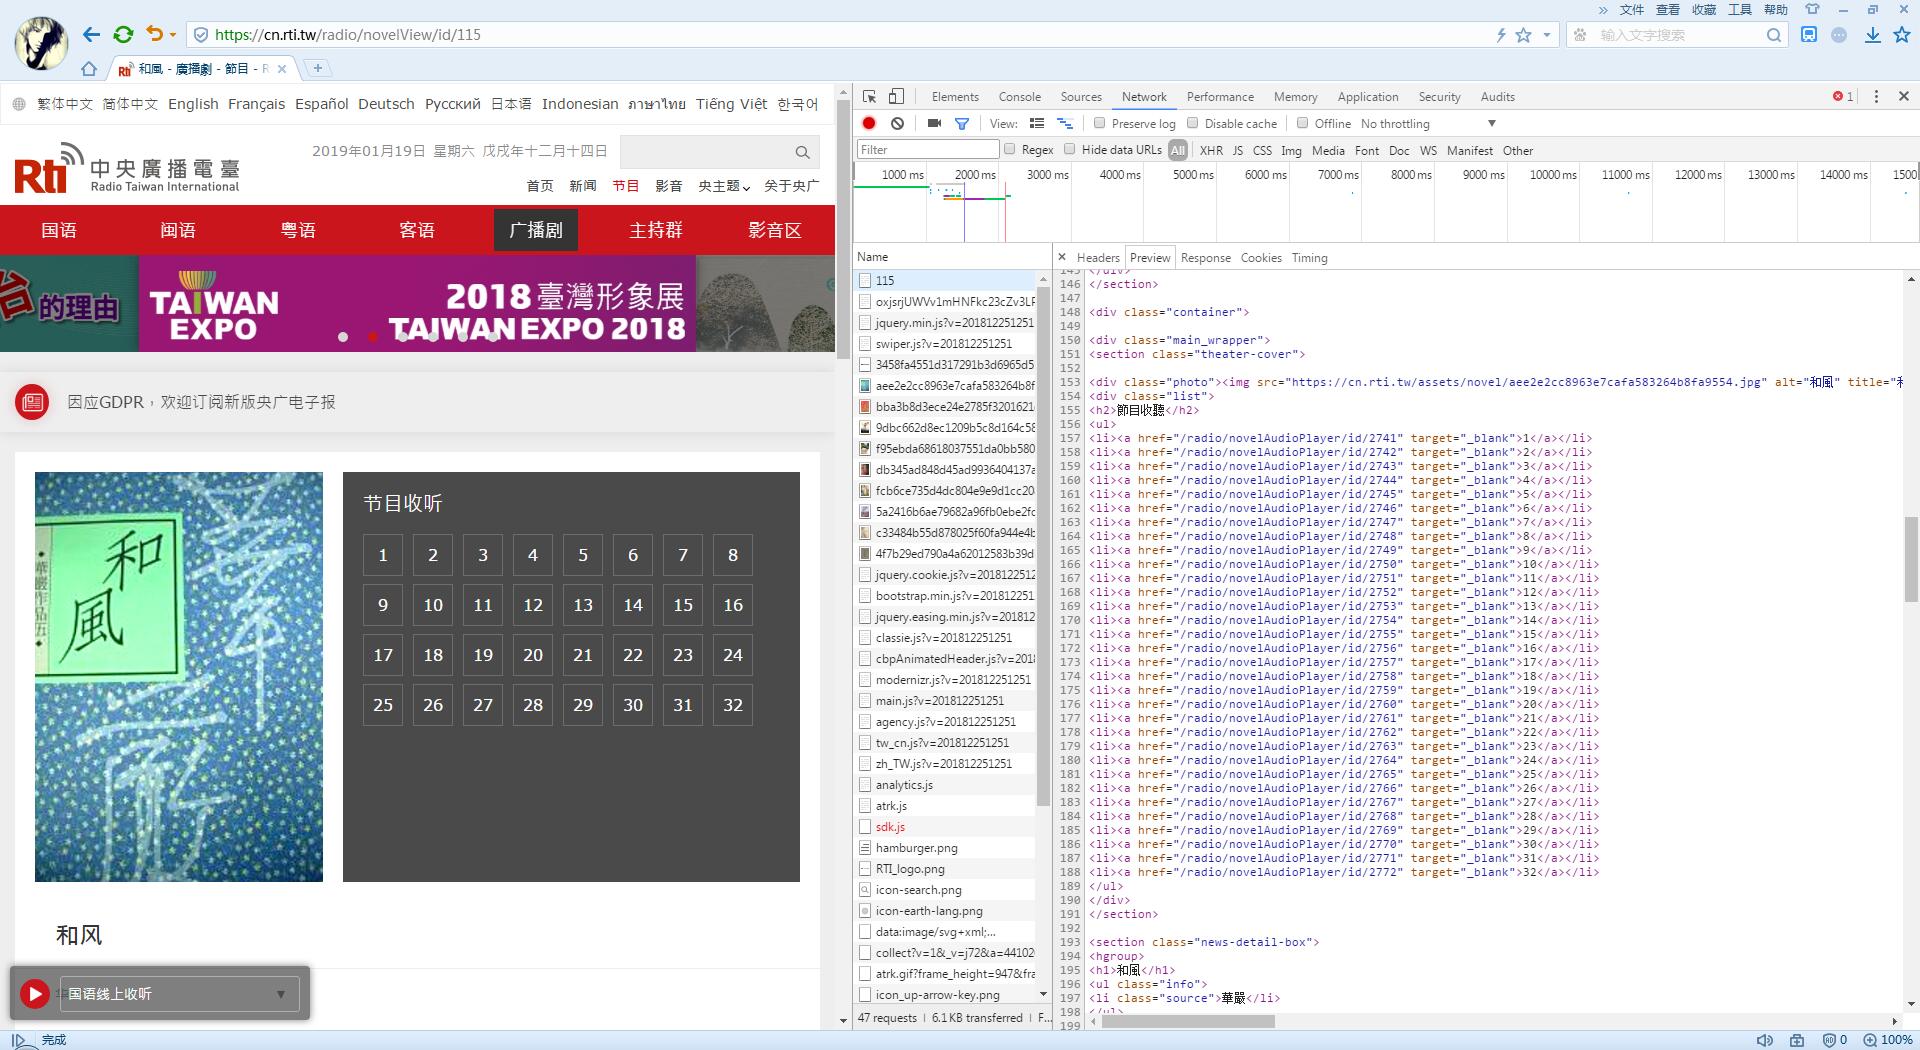
代码中我们继续用之前的方法访问单个广播剧地址,来获取剧集的list:
# 访问单个广播剧页面
novel_view_resp = requests.get(opera_link)
# 利用上一步访问返回的结果生成一个BeautifulSoup对象
view_soup = BeautifulSoup(novel_view_resp.text, "lxml")
# 首先定位h2标签,然后获取h2的下一个ul标签(直接找ul的话会找到其他的ul),然后获取所有a标签
list_a = view_soup.find('h2').find_next_sibling('ul').find_all('a')
# 接着遍历a标签,把每集的地址取出来
view_link = domain + a.get('href')
我们继续看一个单集的播放的HTML,source标签里就是最终的资源地址了,一个MP4文件: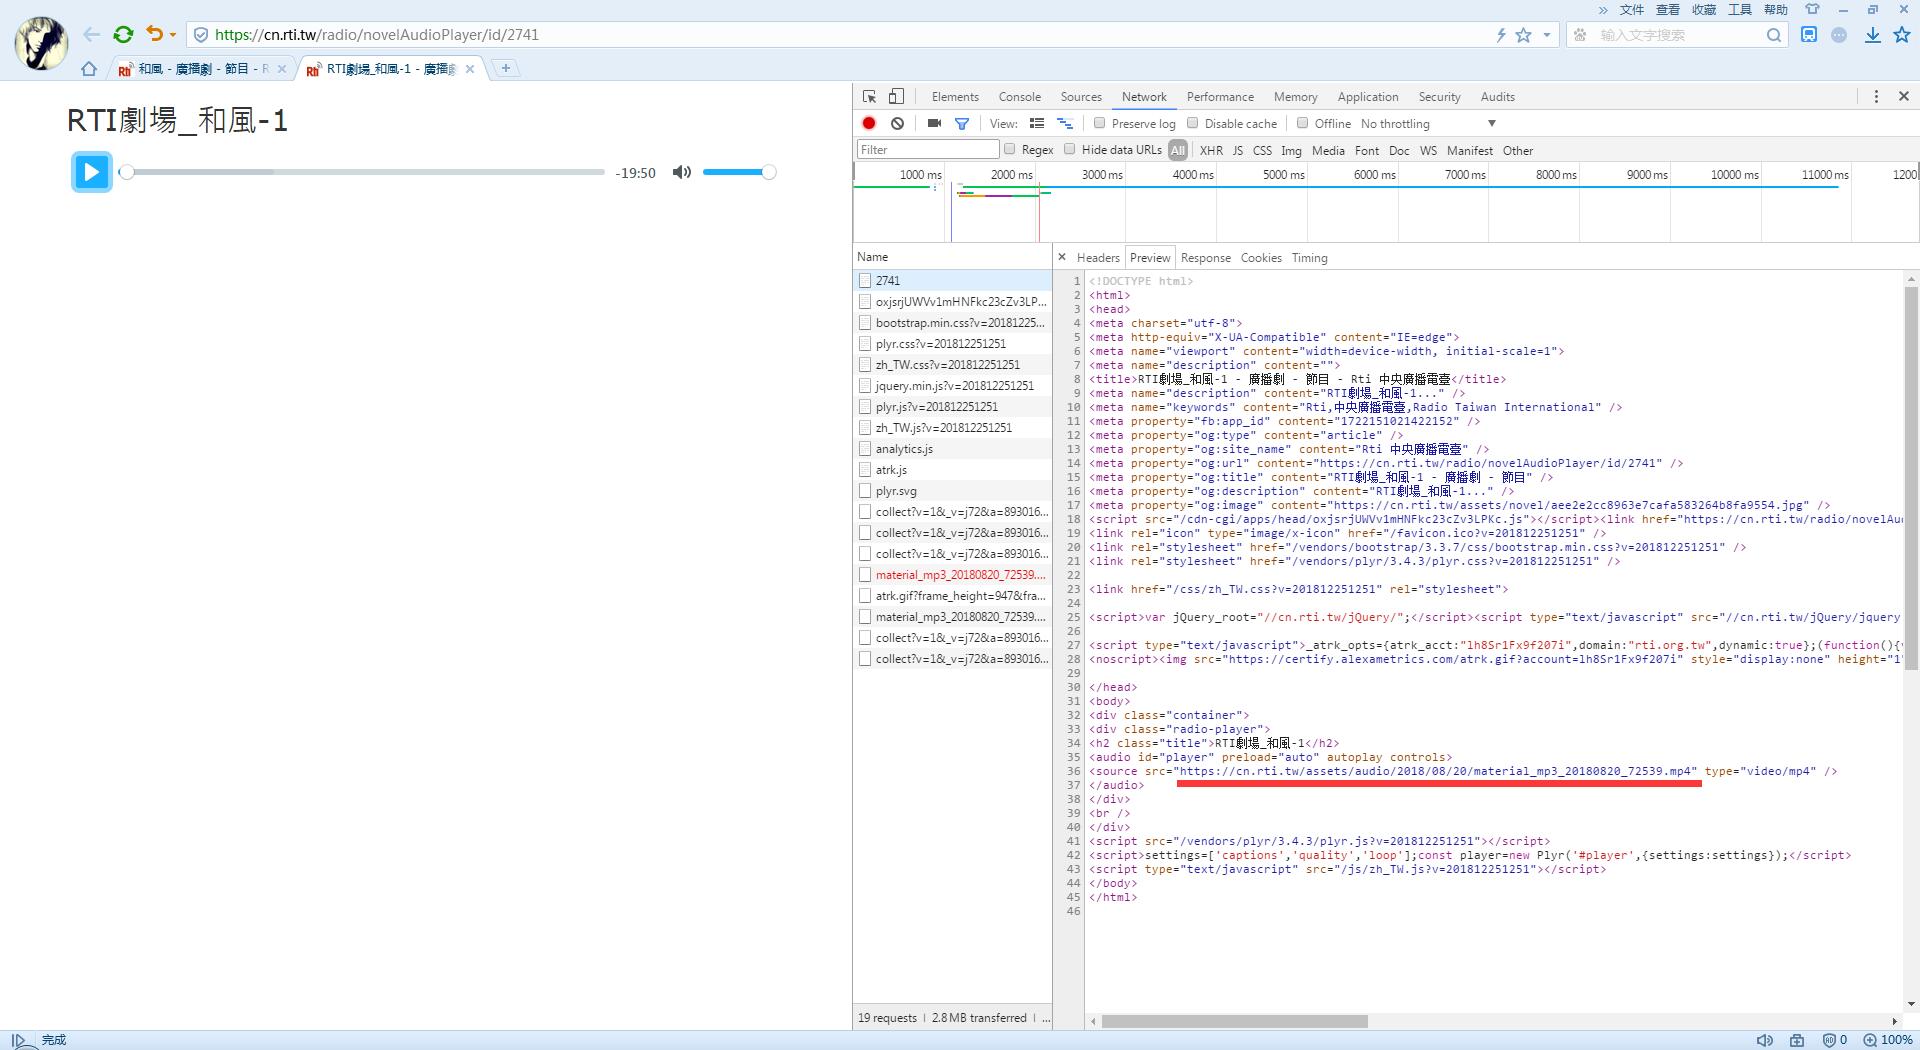
# 打开单集的播放页面
play_resp = requests.get(view_link)
play_soup = BeautifulSoup(play_resp.text, "lxml")
# 获取资源下载地址
src = play_soup.find('source').attrs['src']
现在我还不想下载,我希望先试听确认喜欢后再下载,所以我把下载地址存到一个txt里,一个广播剧存一个txt:
name = file_path + name + '.txt'
with open(name, 'wb') as f:
f.write(content)
由于编码问题,在文件最上加上以下代码:
import sys
reload(sys)
sys.setdefaultencoding('utf-8')
运行效果: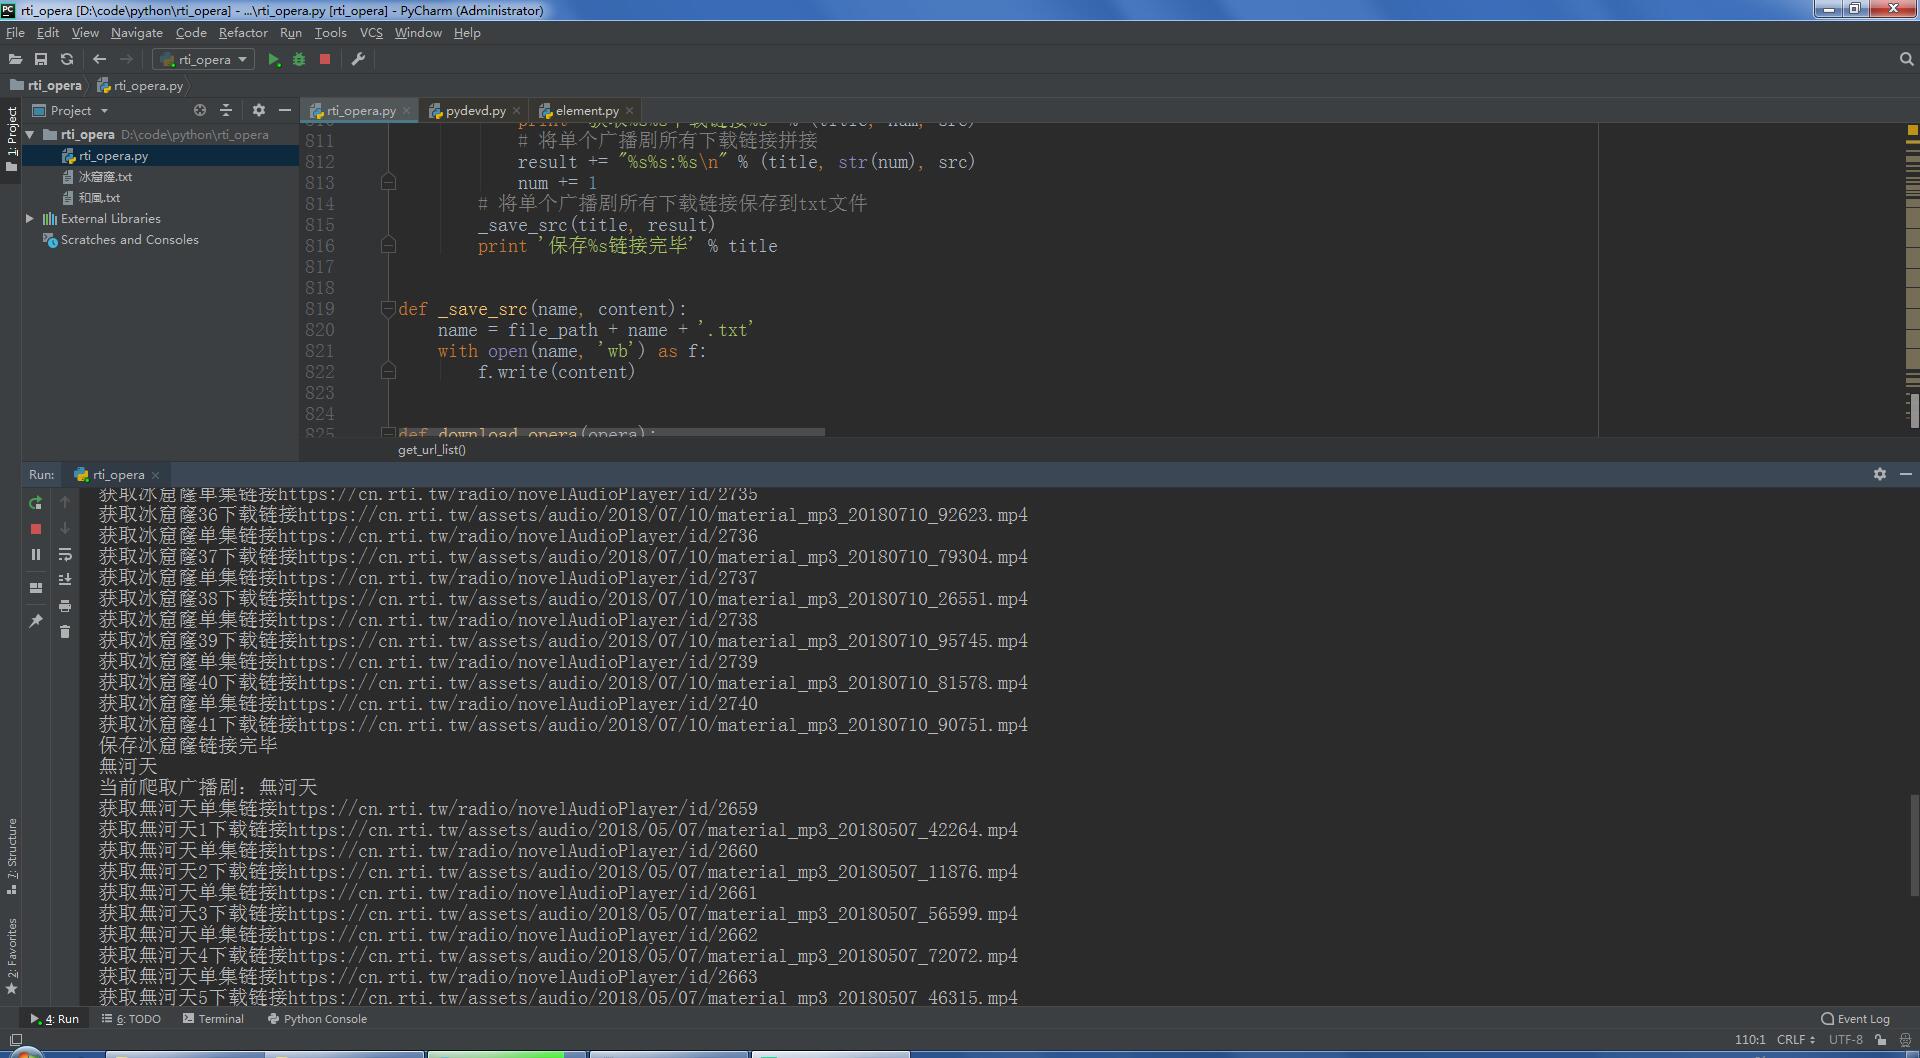
下载的MP4的代码:
# 使用requests的get方法访问下载链接
r = requests.get(url)
# 将访问返回二进制数据内容保存为MP4文件
with open(name, 'wb') as f:
f.write(r.content)
最终的运行结果:
源码地址:https://github.com/songzhenhua/rti_opera/blob/master/rti_opera.py
BeautifulSoup参考地址:
https://www.crummy.com/software/BeautifulSoup/bs4/doc/index.zh.html#attributes
http://www.cnblogs.com/zhaof/p/6930955.html
爬虫初体验:Python+Requests+BeautifulSoup抓取广播剧的更多相关文章
- python 爬虫(一) requests+BeautifulSoup 爬取简单网页代码示例
以前搞偷偷摸摸的事,不对,是搞爬虫都是用urllib,不过真的是很麻烦,下面就使用requests + BeautifulSoup 爬爬简单的网页. 详细介绍都在代码中注释了,大家可以参阅. # -* ...
- Python requests 多线程抓取 出现HTTPConnectionPool Max retires exceeded异常
https://segmentfault.com/q/1010000000517234 -- ::, - oracle - ERROR - data format error:HTTPConnecti ...
- Python爬虫之requests+正则表达式抓取猫眼电影top100以及瓜子二手网二手车信息(四)
requests+正则表达式抓取猫眼电影top100 一.首先我们先分析下网页结构 可以看到第一页的URL和第二页的URL的区别在于offset的值,第一页为0,第二页为10,以此类推. 二.< ...
- Python爬虫实战八之利用Selenium抓取淘宝匿名旺旺
更新 其实本文的初衷是为了获取淘宝的非匿名旺旺,在淘宝详情页的最下方有相关评论,含有非匿名旺旺号,快一年了淘宝都没有修复这个. 可就在今天,淘宝把所有的账号设置成了匿名显示,SO,获取非匿名旺旺号已经 ...
- 用python实现的抓取腾讯视频所有电影的爬虫
1. [代码]用python实现的抓取腾讯视频所有电影的爬虫 # -*- coding: utf-8 -*-# by awakenjoys. my site: www.dianying.atim ...
- python2.7 爬虫初体验爬取新浪国内新闻_20161130
python2.7 爬虫初学习 模块:BeautifulSoup requests 1.获取新浪国内新闻标题 2.获取新闻url 3.还没想好,想法是把第2步的url 获取到下载网页源代码 再去分析源 ...
- Python爬虫工程师必学——App数据抓取实战 ✌✌
Python爬虫工程师必学——App数据抓取实战 (一个人学习或许会很枯燥,但是寻找更多志同道合的朋友一起,学习将会变得更加有意义✌✌) 爬虫分为几大方向,WEB网页数据抓取.APP数据抓取.软件系统 ...
- Python爬虫工程师必学APP数据抓取实战✍✍✍
Python爬虫工程师必学APP数据抓取实战 整个课程都看完了,这个课程的分享可以往下看,下面有链接,之前做java开发也做了一些年头,也分享下自己看这个视频的感受,单论单个知识点课程本身没问题,大 ...
- Python爬虫工程师必学——App数据抓取实战
Python爬虫工程师必学 App数据抓取实战 整个课程都看完了,这个课程的分享可以往下看,下面有链接,之前做java开发也做了一些年头,也分享下自己看这个视频的感受,单论单个知识点课程本身没问题,大 ...
随机推荐
- 9.spring:事务管理(下):声明式事务管理
声明式事务管理 sprin的声明式事务是管理AOP技术实现的事务管理,其本质是是对方法前后进行拦截,然后 在目标方法开始之前创建或者加入一个事务,在执行完成目标方法之后根据执行情况提交或者回滚事务. ...
- Win32线程——优先权
<Win32多线程程序设计>–Jim Beveridge & Robert Wiener Win32 优先权是以数值表现的,并以进程的“优先权类别(priority class)” ...
- mysql5.7.22tar包安装
mysql5.7.22tar包安装 #卸载系统自带的Mariadb [root@ ~]# rpm -qa|grep mariadb mariadb-libs-5.5.44-2.el7.centos.x ...
- git上传下载代码操作
提交代码实质上都要走这样的操作 " 本地代码 --> 本地服务器" "本地服务器 --> 远程服务器" 其实小伙伴就记住两个词就好了. Commi ...
- 十六、详述 IntelliJ IDEA 创建 Maven 项目及设置 java 源目录的方法
Maven 是一个优秀的项目管理工具,它为我们提供了一个构建完整的生命周期框架.现在,就让我们一起看看如何利用 IntelliJ IDEA 快速的创建 Maven 项目吧! 如上图所示,点击Creat ...
- Python 学习笔记(十二)Python文件和迭代(一)
文件 文件和文件夹 文件:文本文件.二进制文件 文件夹:(windows) G:\pythonWorkspace\python\study (linux/mac) /home/workspace/py ...
- 由Oracle 11g SYSAUX 和 SYSTEM 表空间回收引发的联想
0x00--目的 整理一下以前一个SYSTEM表空间和SYSAUX表空间使用率达到99%上限的处理思路和相关知识点,好记性不如烂笔头 0x01--表空间使用率现状 通过查询可得知目前表空间使用情况如下 ...
- Colored Boots题解
题目来自Codeforce 1141Dhttp://codeforces.com/problemset/problem/1141/D 因为是全英文题面,就先简单的阐述一下题面. 首先输入一个数n,然后 ...
- 在SQL Server中批量修改有规律列的定义
)=N'要修改的表名'; --修改所有以sl结尾的列名的小数位数为4位 select syscolumns.name into #t1 from syscolumns,systypes where s ...
- vue 引入 mint-ui 简单使用
一 npm 方式 1,安装依赖 (已有项目) 如果想简单体验:基于vue-cli /* npm install vue -g npm install vue-cli -g // -g 是否全局 ...