
Python爬虫实例(二)使用selenium抓取斗鱼直播平台数据
程序说明:抓取斗鱼直播平台的直播房间号及其观众人数,最后统计出某一时刻的总直播人数和总观众人数。
过程分析:
一、进入斗鱼首页http://www.douyu.com/directory/all
进入平台首页,来到页面底部点击下一页,发现url地址没有发生变化,这样的话再使用urllib2发送请求将获取不到完整数据,这时我们可以使用selenium和PhantomJS来模拟浏览器点击下一页,这样就可以获取完整响应数据了。
首先检查下一页元素,如下:
<a href="#" class="shark-pager-next">下一页</a>
使用selenium和PhantomJS模拟点击,代码如下:
from selenium import webdriver

# 使用PhantomJS浏览器创建浏览器对象

driver = webdriver.PhantomJS()

# 使用get方法加载页面

driver.get("https://www.douyu.com/directory/all")

# class="shark-pager-next"是下一页按钮,click() 是模拟点击

driver.find_element_by_class_name("shark-pager-next").click()

# 打印页面页面查看

print driver.page_source
这样就可以通过设置一个循环条件,一直点击下去,直到页面加载完。循环终止的条件为最后一页,进入最后一页,检查下一页元素:
<a href="#" class="shark-pager-next shark-pager-disable shark-pager-disable-next">下一页</a>
对比发现:当出现"shark-pager-disable-next",下一页无法点击,这就是循环停止的条件。
# 如果在页面源码里没有找到"shark-pager-disable-next",其返回值为-1,可依次作为判断条件

driver.page_source.find("shark-pager-disable-next")
二,对要提取的内容进行分析
查看直播房间名称的元素,得到如下结果:
<span class="dy-name ellipsis fl">AI冬Ming</span>
使用BeatuifulSoup获取元素,代码如下:
# 房间名

names = soup.find_all("span", {"class" : "dy-name ellipsis fl"})
查看观看人数的元素,得到如下结果:
<span class="dy-num fr">75.6万</span>
使用BeatuifulSoup获取元素,代码如下:
# 观众人数

numbers = soup.find_all("span", {"class" :"dy-num fr"})
具体过程大概如此,下面是完整代码:
#!/usr/bin/env python

# -*- coding:utf-8 -*-

from selenium import webdriver

from bs4 import BeautifulSoup as bs

import sys

reload(sys)

sys.setdefaultencoding("utf-8")

class Douyu():

    def __init__(self):

        self.driver = webdriver.PhantomJS()

        self.num = 0

        self.count = 0

    def douyuSpider(self):

        self.driver.get("https://www.douyu.com/directory/all")

        while True:

            soup = bs(self.driver.page_source, "lxml")

            # 房间名, 返回列表

            names = soup.find_all("span", {"class" : "dy-name ellipsis fl"})

            # 观众人数, 返回列表

            numbers = soup.find_all("span", {"class" :"dy-num fr"})

            for name, number in zip(names, numbers):

                print u"观众人数: -" + number.get_text().strip() + u"-\t房间名: " + name.get_text().strip()

                self.num += 1

                count = number.get_text().strip()

                if count[-1]=="万":

                    countNum = float(count[:-1])*10000

                else:

                    countNum = float(count)

                self.count += countNum

            # 一直点击下一页

            self.driver.find_element_by_class_name("shark-pager-next").click()

            # 如果在页面源码里找到"下一页"为隐藏的标签,就退出循环

            if self.driver.page_source.find("shark-pager-disable-next") != -1:

                    break

        print "当前网站直播人数:%s" % self.num

        print "当前网站观众人数:%s" % self.count

if __name__ == "__main__":

    d = Douyu()

    d.douyuSpider()
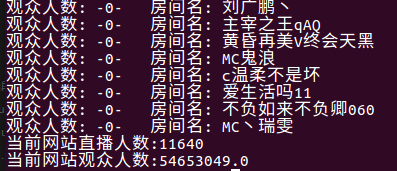
运行结果(部分展示):
Python爬虫实例(二)使用selenium抓取斗鱼直播平台数据的更多相关文章
- Python爬虫实战:使用Selenium抓取QQ空间好友说说
前面我们接触到的,都是使用requests+BeautifulSoup组合对静态网页进行请求和数据解析,若是JS生成的内容,也介绍了通过寻找API借口来获取数据. 但是有的时候,网页数据由JS生成,A ...
- python爬虫之分析Ajax请求抓取抓取今日头条街拍美图(七)
python爬虫之分析Ajax请求抓取抓取今日头条街拍美图 一.分析网站 1.进入浏览器,搜索今日头条,在搜索栏搜索街拍,然后选择图集这一栏. 2.按F12打开开发者工具,刷新网页,这时网页回弹到综合 ...
- python爬虫构建代理ip池抓取数据库的示例代码
爬虫的小伙伴,肯定经常遇到ip被封的情况,而现在网络上的代理ip免费的已经很难找了,那么现在就用python的requests库从爬取代理ip,创建一个ip代理池,以备使用. 本代码包括ip的爬取,检 ...
- Python爬虫入门教程 46-100 Charles抓取手机收音机-手机APP爬虫部分
1. 手机收音机-爬前叨叨 今天选了一下,咱盘哪个APP呢,原计划是弄荔枝APP,结果发现竟然没有抓到数据,很遗憾,只能找个没那么圆润的了.搜了一下,找到一个手机收音机 下载量也是不错的. 2. 爬虫 ...
- Python爬虫入门教程 45-100 Charles抓取兔儿故事-下载小猪佩奇故事-手机APP爬虫部分
1. Charles抓取兔儿故事背景介绍 之前已经安装了Charles,接下来我将用两篇博客简单写一下关于Charles的使用,今天抓取一下兔儿故事里面关于小猪佩奇的故事. 爬虫编写起来核心的重点是分 ...
- Python 爬虫实例(8)—— 爬取 动态页面
今天使用python 和selenium爬取动态数据,主要是通过不停的更新页面,实现数据的爬取,要爬取的数据如下图 源代码: #-*-coding:utf-8-*- import time from ...
- PYTHON 爬虫笔记十:利用selenium+PyQuery实现淘宝美食数据搜集并保存至MongeDB(实战项目三)
利用selenium+PyQuery实现淘宝美食数据搜集并保存至MongeDB 目标站点分析 淘宝页面信息很复杂的,含有各种请求参数和加密参数,如果直接请求或者分析Ajax请求的话会很繁琐.所以我们可 ...
- 使用Selenium模拟浏览器抓取斗鱼直播间信息
获取斗鱼直播间每个房间的名称.观看人数.tag.主播名字 代码: import time from multiprocessing import Pool from selenium import w ...
- Python 爬虫实例(15) 爬取 汽车之家(汽车授权经销商)
有人给我吹牛逼,说汽车之家反爬很厉害,我不服气,所以就爬取了一下这个网址. 本片博客的目的是重点的分析定向爬虫的过程,希望读者能学会爬虫的分析流程. 一:爬虫的目标: 打开汽车之家的链接:https: ...
随机推荐
- Mac里面如何设置自启动服务
Mac OS x 启动项设置 Mac OS X的启动原理: 1,mac固件激活,初始化硬件,加载BootX引导器. 2,BootX加载内核与内核扩展(kext). 3,内核启动launchd进程. 4 ...
- yii2中的事件和行为
Event 事件 事件是为了解耦... 注册事件 使用"on add"添加属性,注册事件 使用on方法注册事件. 第三个参数$data是监听函数使用的参数, 第四个$append参 ...
- shell学习笔记之命令(四)
命令的类型:1>.外部命令:在命令提示符中执行的普通命令.2>.内置命令:内置命令是在shell内部实现的. 1.break命令 #!/bin/sh rm -rf fred* echo & ...
- 服务器端cs文件
服务器端向mysql数据库写数据 using System; using Newtonsoft.Json; using Newtonsoft.Json.Linq; using System.Colle ...
- JS学习笔记(5)--一道返回整数数组的面试题(经验之谈)
说明: 1. 微信文章里看到的,作者是马超 网易高级前端技术经理,原文在网上搜不到,微信里可以搜“为什么你的前端工作经验不值钱?”,里面写着“转载自网易实践者社区”.(妈蛋,第二天网上就有了http: ...
- 微博excel数据清洗(Java版)
微博数据清洗(Java版) 原创 2013年12月10日 10:58:24 2979 大数据公益大学提供的一份数据,义务处理一下,原始数据是Excel,含有html标签,如下: 要求清洗掉html ...
- php代码检查
最近写php,几个同事都是没写过c的,经常写的变量没有定义,而php没有编译,错误无法发现. 我们现在用的是NetBeans,好在其提供了语法检测,如下图,让编辑器强制显示我错误
- Android——Activity生命周期(转)
Activity生命周期 子曰:溫故而知新,可以為師矣.<論語> 学习技术也一样,对于技术文档或者经典的技术书籍来说,指望看一遍就完全掌握,那基本不大可能,所以我们需要经常回过头再仔细 ...
- PHP——0127加登录页面,加查询,加方法,加提示框
数据库mydb 表格info,nation,login 效果 <!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN ...
- java----序列化与反序列化中及java序列化本质就是存储一个对象,然后在其他地方在调用它
Java 序列化Serializable详解(附详细例子) 1.什么是序列化和反序列化Serialization(序列化)是一种将对象以一连串的字节描述的过程:反序列化deserialization是 ...