
Beautiful Soup解析网页
使用前步骤:
1.Beautiful Soup目前已经被移植到bs4,所以导入Beautiful Soup时先安装bs4库。
2.安装lxml库:如果不使用此库,就会使用Python默认的解析器,而lxml具有功能更加强大、速度更快的特点。
爬取:http://www.cntour.cn/
#!/usr/bin/env python

# -*- coding:utf-8 -*-

# Author:XXC

import requests

from bs4 import BeautifulSoup

import re

url="http://www.cntour.cn/"  #需要爬取的网址

strhtml = requests.get(url);    #使用GET方式,获取网页数据

soup = BeautifulSoup(strhtml.text,'lxml') #HTML文档将被转换成Unicode

# 编码格式,然后BeautifulSoup选择最适合的解析器来解析文档,此处指定

# lxml解析器,解析后转换成属性结构,每个节点都是Python对象,保存在变量soup中

data = soup.select('#main > div > div.mtop.firstMod.clearfix > div.centerBox > ul.newsList > li > a') #采用select选择器定位数据

for item in data: #数据清洗和组织数据

    result = {

        'title':item.get_text(), #获得a标签的文本内内容

        'link':item.get('href'), #获得a标签的href属性

        'ID':re.findall('\d+',item.get('href')) #使用正则匹配其中的数字,\d匹配数字,+匹配一个字符一次或多次

    }

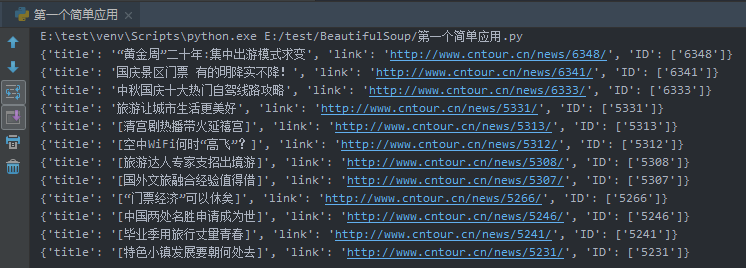
    print(result)
结果:
Beautiful Soup解析网页的更多相关文章
- Python Beautiful Soup 解析库的使用
Beautiful Soup 借助网页的结构和属性等特性来解析网页,这样就可以省去复杂的正则表达式的编写. Beautiful Soup是Python的一个HTML或XML的解析库. 1.解析器 解析 ...
- 爬虫5_python2_使用 Beautiful Soup 解析数据
使用 Beautiful Soup 解析数据(感谢东哥) 有的小伙伴们对写正则表达式的写法用得不熟练,没关系,我们还有一个更强大的工具,叫Beautiful Soup,有了它我们可以很方便地提取出HT ...
- Beautiful Soup解析库的安装和使用
Beautiful Soup是Python的一个HTML或XML的解析库,我们可以用它来方便地从网页中提取数据.它拥有强大的API和多样的解析方式.官方文档:https://www.crummy.co ...
- Python爬虫之Beautiful Soup解析库的使用(五)
Python爬虫之Beautiful Soup解析库的使用 Beautiful Soup-介绍 Python第三方库,用于从HTML或XML中提取数据官方:http://www.crummv.com/ ...
- 用Beautiful Soup解析html源码
#xiaodeng #python3 #用Beautiful Soup解析html源码 html_doc = """ <html> <head> ...
- Python爬虫系列(四):Beautiful Soup解析HTML之把HTML转成Python对象
在前几篇文章,我们学会了如何获取html文档内容,就是从url下载网页.今天开始,我们将讨论如何将html转成python对象,用python代码对文档进行分析. (牛小妹在学校折腾了好几天,也没把h ...
- 爬虫(五)—— 解析库(二)beautiful soup解析库
目录 解析库--beautiful soup 一.BeautifulSoup简介 二.安装模块 三.Beautiful Soup的基本使用 四.Beautiful Soup查找元素 1.查找文本.属性 ...
- Beautiful Soup 解析html表格
from bs4 import BeautifulSoup import urllib.request doc = urllib.request.urlopen('http://www.bkzy.or ...
- Python3编写网络爬虫06-基本解析库Beautiful Soup的使用
二.Beautiful Soup 简介 就是python的一个HTML或XML的解析库 可以用它来很方便的从网页中提取数据 0.1 提供一些简单的 python式的函数来处理导航,搜索,修改分析树等功 ...
随机推荐
- word 标题序号
设置标题的序号. 1>设置二级标题的序号 步骤一: 步骤二: 步骤三: 步骤四: 2>设置三级标题的序号 程序员的基础教程:菜鸟程序员
- RotbotFrameWork接口测试
一.添加接口测试Library 二.参数说明 三.关键字使用说明 Set Varibae: 参数化接口地址 Connect To Databse Using Custom Param: 连接数据库(需 ...
- strtotime()
date('Y-m-d H:i:s',time()) //24小时 date('Y-m-d h:i:s',time()) //12小时
- [SoapUI] 比较两个不同环境下XML格式的Response, 结果不同时设置Test Step的执行状态为失败
import org.custommonkey.xmlunit.* def responseTP=context.expand( '${Intraday Table_TP#Response}' ) d ...
- MQTT协议实现Eclipse Paho学习总结
MQTT协议实现Eclipse Paho学习总结 摘自:https://www.cnblogs.com/yfliufei/p/4383852.html 2015-04-01 14:57 by 辣椒酱, ...
- chrome crx下载路径
chrome crx下载后会被删除,可在检查时粘贴出来,下载路径在: %localappdata%\Google\Chrome\User Data\Webstore Downloads 参考:http ...
- Maven常用配置
运行mvn install时跳过Test 方法一: <project> [...] <build> <plugins> <plugin> <gro ...
- C#序列化效率对比
原文出处:https://www.cnblogs.com/landeanfen/p/4627383.html 从使用序列化到现在,用到的无非下面几种方式:(1)JavaScriptSerializer ...
- 自己(转)JAVA中toString方法的作用
JAVA中toString方法的作用 因为它是Object里面已经有了的方法,而所有类都是继承Object,所以“所有对象都有这个方法”. 它通常只是为了方便输出,比如System.out.print ...
- System.Timers.Timer用法
System.Timers.Timer t = new System.Timers.Timer(5000); //设置时间间隔为5秒 private void Form1_Load(object se ...