
爬虫5_python2_使用 Beautiful Soup 解析数据
使用 Beautiful Soup 解析数据(感谢东哥)
有的小伙伴们对写正则表达式的写法用得不熟练,没关系,我们还有一个更强大的工具,叫Beautiful Soup,有了它我们可以很方便地提取出HTML或XML标签中的内容,实在是方便,这一节就让我们一起来感受一下Beautiful Soup的魅力
1. Beautiful Soup的简介
简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据。官方解释如下:
Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。 Beautiful Soup自动将输入文档转换为Unicode编码,输出文档转换为utf-8编码。你不需要考虑编码方式,除非文档没有指定一个编码方式,这时,Beautiful Soup就不能自动识别编码方式了。然后,你仅仅需要说明一下原始编码方式就可以了。 Beautiful Soup已成为和lxml、html6lib一样出色的python解释器,为用户灵活地提供不同的解析策略或强劲的速度。
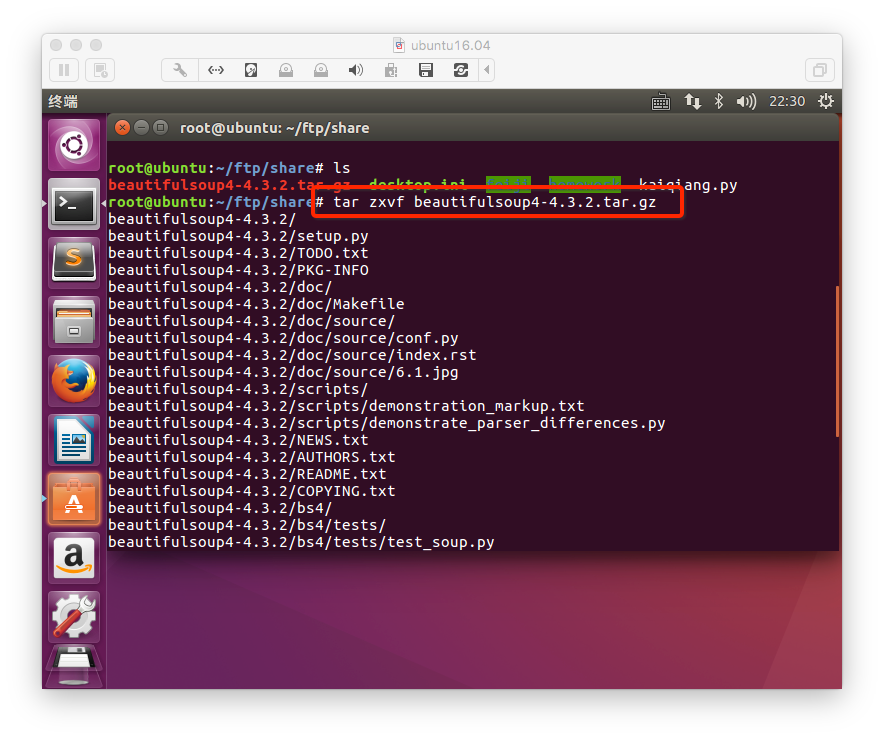
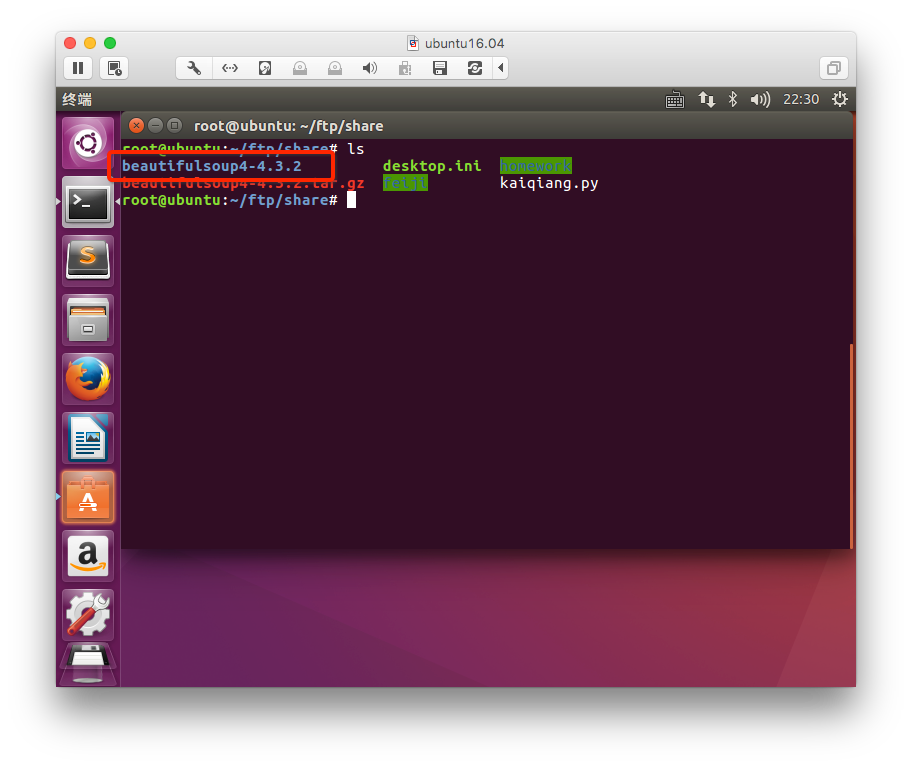
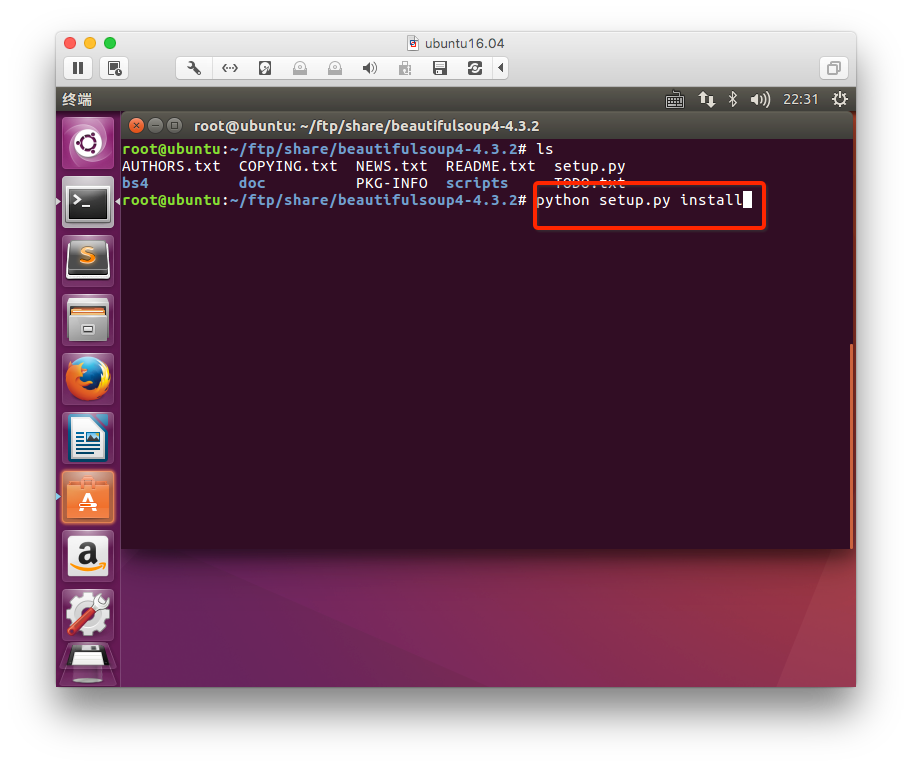
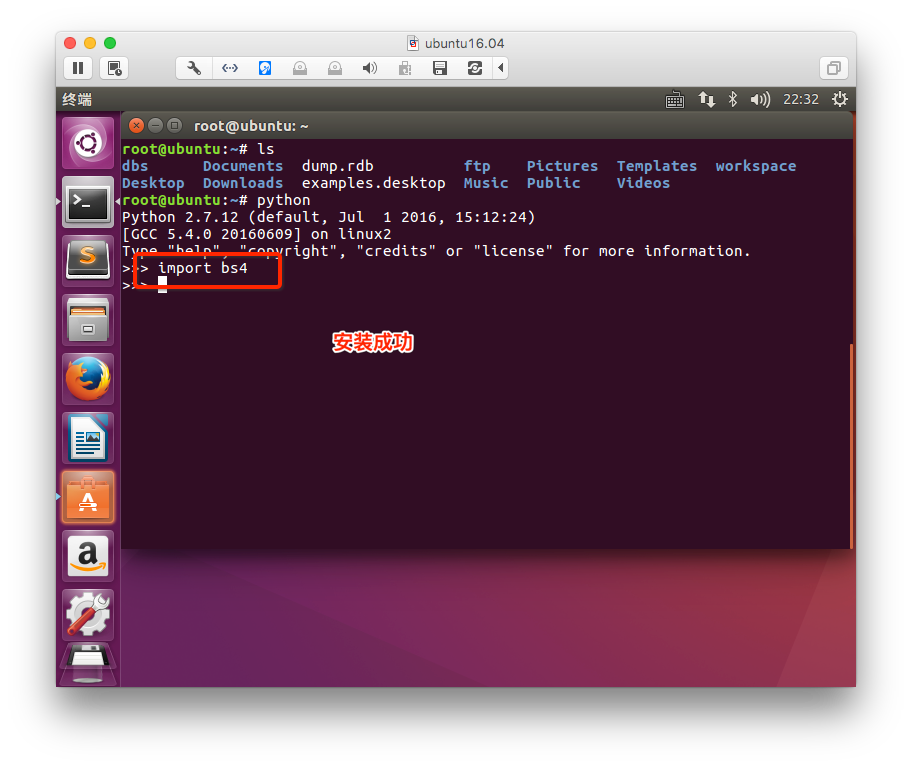
2. 安装
下载地址:https://pypi.python.org/pypi/beautifulsoup4/4.3.2
官方文档:http://beautifulsoup.readthedocs.org/zh_CN/latest
3. 使用
from bs4 import BeautifulSoup
我们创建一个字符串,后面的例子我们便会用它来演示
 html = """<html><head><title>The Dormouse's story</title></head>

    <body>

    <p class="title" name="dromouse"><b>The Dormouse's story</b></p>

    <p class="story">Once upon a time there were three little sisters; and their names were

    <a href="http://example.com/elsie" class="sister" id="link1"><!-- Elsie --></a>,

    <a href="http://example.com/lacie" class="sister" id="link2">Lacie</a> and

    <a href="http://example.com/tillie" class="sister" id="link3">Tillie</a>;

    and they lived at the bottom of a well.</p>

    <p class="story">...</p>

    """
创建 beautifulsoup 对象
soup = BeautifulSoup(html)
下面我们来打印一下 soup 对象的内容,格式化输出
print soup.prettify()
3.1 找标签
直接打印标签
print soup.title

#<title>The Dormouse's story</title>

print soup.head

#<head><title>The Dormouse's story</title></head>

print soup.a

#<a class="sister" href="http://example.com/elsie" id="link1"><!-- Elsie --></a>

print soup.p

#<p class="title" name="dromouse"><b>The Dormouse's story</b></p>
我们可以利用 soup加标签名轻松地获取这些标签的内容,是不是感觉比正则表达式方便多了?不过有一点是,它查找的是在所有内容中的第一个符合要求的标签
对于标签,它有两个重要的属性,是 name 和 attrs,下面我们分别来感受一下
print soup.name

print soup.head.name

#[document]

#head
soup 对象本身比较特殊,它的 name 即为 [document],对于其他内部标签,输出的值便为标签本身的名称
print soup.p.attrs

#{'class': ['title'], 'name': 'dromouse'}
在这里,我们把 p 标签的所有属性打印输出了出来,得到的类型是一个字典。
如果我们想要单独获取某个属性,可以这样,例如我们获取它的 class 叫什么
print soup.p['class']

#['title']
3.2 获取文字
既然我们已经得到了标签的内容,那么问题来了,我们要想获取标签内部的文字怎么办呢?很简单,用 .string 即可,例
print soup.p.string

#The Dormouse's story
3.3 CSS选择器
在CSS中,标签名不加任何修饰,类名前加点,id名前加 #,在这里我们也可以利用类似的方法来筛选元素,用到的方法是 soup.select(),返回类型是 list
3.3.1 通过标签名查找
print soup.select('title')

#[<title>The Dormouse's story</title>]
3.3.2 通过类名查找
print soup.select('.sister')

#[<a class="sister" href="http://example.com/elsie" id="link1"><!-- Elsie --></a>, <a class="sister" href="http://example.com/lacie" id="link2">Lacie</a>, <a class="sister" href="http://example.com/tillie" id="link3">Tillie</a>]
3.3.3 通过 id 名查找
print soup.select('#link1')

#[<a class="sister" href="http://example.com/elsie" id="link1"><!-- Elsie --></a>]
3.3.4 组合查找
组合查找即和写 class 文件时,标签名与类名、id名进行的组合原理是一样的,例如查找 p 标签中,id 等于 link1的内容,二者需要用空格分开
print soup.select('p #link1')

#[<a class="sister" href="http://example.com/elsie" id="link1"><!-- Elsie --></a>]
3.3.5 直接子标签查找
print soup.select("head > title")

#[<title>The Dormouse's story</title>]
3.3.6 属性查找
查找时还可以加入属性元素,属性需要用中括号括起来,注意属性和标签属于同一节点,所以中间不能加空格,否则会无法匹配到
print soup.select('a[class="sister"]')

#[<a class="sister" href="http://example.com/elsie" id="link1"><!-- Elsie --></a>, <a class="sister" href="http://example.com/lacie" id="link2">Lacie</a>, <a class="sister" href="http://example.com/tillie" id="link3">Tillie</a>]

print soup.select('a[href="http://example.com/elsie"]')

#[<a class="sister" href="http://example.com/elsie" id="link1"><!-- Elsie --></a>]
同样,属性仍然可以与上述查找方式组合,不在同一节点的空格隔开,同一节点的不加空格
print soup.select('p a[href="http://example.com/elsie"]')

#[<a class="sister" href="http://example.com/elsie" id="link1"><!-- Elsie --></a>]
爬虫5_python2_使用 Beautiful Soup 解析数据的更多相关文章
- Python爬虫之Beautiful Soup解析库的使用(五)
Python爬虫之Beautiful Soup解析库的使用 Beautiful Soup-介绍 Python第三方库,用于从HTML或XML中提取数据官方:http://www.crummv.com/ ...
- Beautiful Soup解析库的安装和使用
Beautiful Soup是Python的一个HTML或XML的解析库,我们可以用它来方便地从网页中提取数据.它拥有强大的API和多样的解析方式.官方文档:https://www.crummy.co ...
- 用Beautiful Soup解析html源码
#xiaodeng #python3 #用Beautiful Soup解析html源码 html_doc = """ <html> <head> ...
- 爬虫(五)—— 解析库(二)beautiful soup解析库
目录 解析库--beautiful soup 一.BeautifulSoup简介 二.安装模块 三.Beautiful Soup的基本使用 四.Beautiful Soup查找元素 1.查找文本.属性 ...
- Python爬虫系列(四):Beautiful Soup解析HTML之把HTML转成Python对象
在前几篇文章,我们学会了如何获取html文档内容,就是从url下载网页.今天开始,我们将讨论如何将html转成python对象,用python代码对文档进行分析. (牛小妹在学校折腾了好几天,也没把h ...
- Python爬虫利器:Beautiful Soup
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.使用它来处理HTML页面就像JavaScript代码操作HTML DOM树一样方便.官方中文文档地址 1. 安 ...
- Beautiful Soup解析网页
使用前步骤: 1.Beautiful Soup目前已经被移植到bs4,所以导入Beautiful Soup时先安装bs4库. 2.安装lxml库:如果不使用此库,就会使用Python默认的解析器,而l ...
- Python Beautiful Soup 解析库的使用
Beautiful Soup 借助网页的结构和属性等特性来解析网页,这样就可以省去复杂的正则表达式的编写. Beautiful Soup是Python的一个HTML或XML的解析库. 1.解析器 解析 ...
- 爬虫系列二(数据清洗--->xpath解析数据)
一 xpath介绍 XPath 是一门在 XML 文档中查找信息的语言.XPath 用于在 XML 文档中通过元素和属性进行导航. XPath 使用路径表达式在 XML 文档中进行导航 XPath 包 ...
随机推荐
- webpack内置模块ProvidePlugin
webpack配置ProvidePlugin后,在使用时将不再需要import和require进行引入,直接使用即可. 使用方法: 在webpack.dev.conf.js和webpack.prod. ...
- 洛谷 - P2281 - 多项式的加法和乘法 - 大模拟
题目链接:https://www.luogu.org/problemnew/show/P2281 题目的意思很简单,输入两个系数.指数都是整数,变量都是大写字母的多项式,求他们的加法结果和乘法结果. ...
- 洛谷 - P1020 - 导弹拦截 - 最长上升子序列
https://www.luogu.org/problemnew/show/P1020 终于搞明白了.根据某定理,最少需要的防御系统的数量就是最长上升子序列的数量. 呵呵手写二分果然功能很多,想清楚自 ...
- 两种好用的清除浮动的小技巧(clearfix hack)
方法一:使用内容生成的方式清除浮动 这种方法不能解决margin在垂直边界上的叠加问题,如果不涉及margin的边界叠加问题使用这种方法清除浮动就行了 . /* :after 选择器向选定的元素之后插 ...
- Codeforces691A【读题-水】
妈蛋wa了两次.. 时尚的定义是length大于1的要破个洞,一定要破个洞.. According to rules of the Berland fashion, a jacket should b ...
- unity模型法线反转问题
fbx模型导入unity正常 但只要绑了骨骼,在3dmax中正常,进入unity就法线反转 原因是3dmax中模型用到复制和镜像的导出需要多一步处理 1重置变换 2反转法线 按顺序进行这两个,在绑定模 ...
- perl C/C++ 扩展(二)
第二讲perl 加载c/c++的库 先通过h2xs 创建一个新的工程 h2xs -A -n two_test 进入目录 cd two_test 创建一个mylib文件夹,存放静态库 mkdir myl ...
- H - F(x)
#include <iostream> #include <algorithm> #include <cstring> #include <cstdio> ...
- Vuex目录结构推荐
目录结构如下: - src - store // 在src目录下 新建一个store文件夹 - mutations.js // mutations - mutaions_types.js // mut ...
- PHP面向对象static关键字
1.静态属性用于保存类的公有数据 2.静态方法里面只能访问静态属性 3.静态成员不需要实例化就可以访问 4.类的内部可以通过self或者static关键字访问自身的静态成员 5.可以通过parent关 ...