
cart中回归树的原理和实现
前面说了那么多,一直围绕着分类问题讨论,下面我们开始学习回归树吧,
cart生成有两个关键点
- 如何评价最优二分结果
- 什么时候停止和如何确定叶子节点的值
cart分类树采用gini系数来对二分结果进行评价,叶子节点的值使用多数表决,那么回归树呢?我们直接看之前的一个数据集(天气与是否出去玩,是否出去玩改成出去玩的时间)
sunny    hot    high    FALSE    25

sunny    hot    high    TRUE    30

overcast    hot    high    FALSE    46

rainy    mild    high    FALSE    45

rainy    cool    normal    FALSE    52

rainy    cool    normal    TRUE    23

overcast    cool    normal    TRUE    43

sunny    mild    high    FALSE    35

sunny    cool    normal    FALSE    38

rainy    mild    normal    FALSE    46

sunny    mild    normal    TRUE    48

overcast    mild    high    TRUE    52

overcast    hot    normal    FALSE    44

rainy    mild    high    TRUE    30
如果用分类树来做,结果就是这样的,一个结果值一个节点
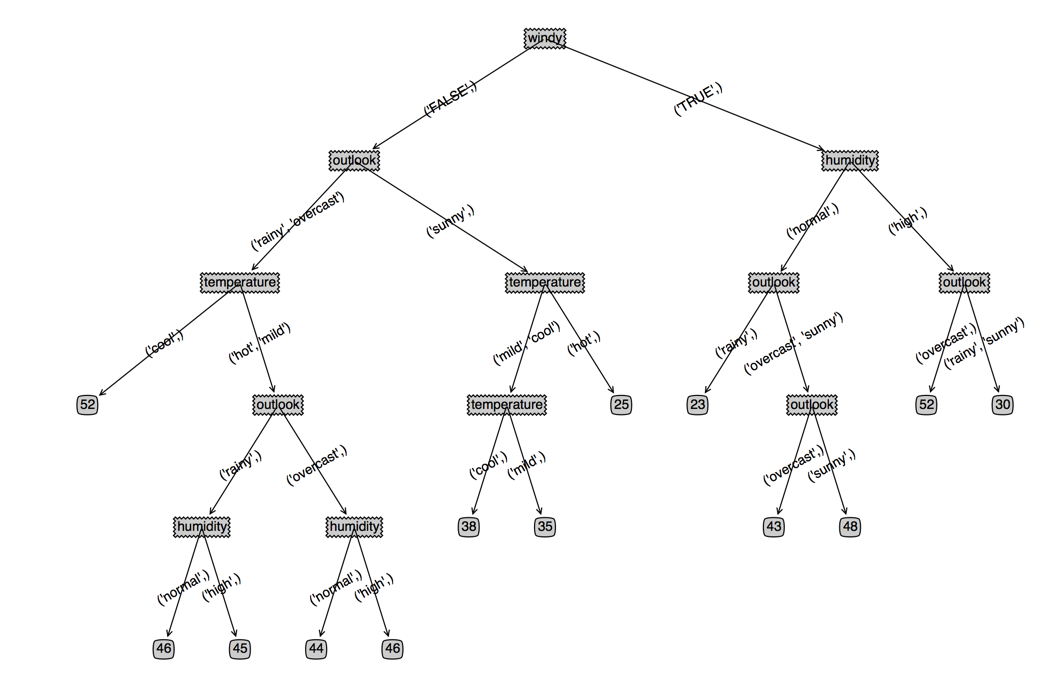
回归树切分数据集和分类树是一样的,那么我们如何评价一个数据集划分的好坏呢?分类树是用gini系数衡量数据集的类别的混乱程度,同样,我们也可以衡量数据集的回归值的混乱程度,比较经典的是方差和标准差,由于我们需要得到和回归值接近的值作为叶子节点的值,我们这里使用标准差吧
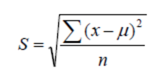 n是回归值的个数,u是平均值,x是每个回归值,S是标准差(standard deviation)
第二个问题:什么时候停止和如何确定叶子节点的值?
分类树是特征用完或者类别都一样;对于回归问题回归值都一样的概率比较小,由于我们过程中不减少特征,所以最后肯定是一个样本一个分支。
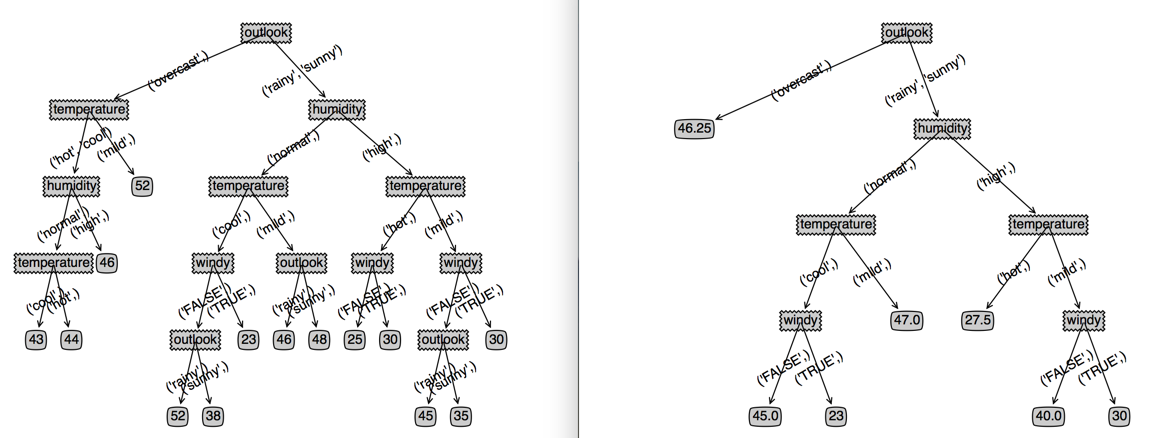
有人说当分支的S小于总体的5%,分支就可以结束,然后节点的值取平均值
我们看下这样有效果不?左边是没有停止原始的回归树,右边是加上结束条件的回归树,感觉效果还可以,这样回归树就完成了
对比回归树和分类树的实现,发现基本是就仅仅是一个函数的区别,到这里明白为什么叫分类回归树了吗?
就是同样的代码,只需要改变一个函数,就可以实现分类或者回归的功能的了。
下面附上回归树的完整代码
# regression_tree.py

# coding:utf8

from itertools import *

from numpy import *

import operator,math

def calStDev(dataSet):

    classList = [float(example[-1]) for example in dataSet]

    n=len(classList)

    u=sum(classList)/n

    total=0

    for x in classList:

        total+=(x-u)*(x-u)

    S = math.sqrt(total)

    return S,u

def splitDataSet(dataSet, axis, values):

    retDataSet = []

    if len(values) < 2:

        for featVec in dataSet:

            if featVec[axis] == values[0]:#如果特征值只有一个,不抽取当选特征

                reducedFeatVec = featVec[:axis]

                reducedFeatVec.extend(featVec[axis+1:])

                retDataSet.append(reducedFeatVec)

    else:

        for featVec in dataSet:

            for value in values:

                if featVec[axis] == value:#如果特征值多于一个,选取当前特征

                    retDataSet.append(featVec)

    return retDataSet

# 传入的是一个特征值的列表,返回特征值二分的结果

def featuresplit(features):

    count = len(features)#特征值的个数

    if count < 2:

        # print features

        # print "please check sample's features,only one feature value"

        return ((features[0],),)

    # 由于需要返回二分结果,所以每个分支至少需要一个特征值,所以要从所有的特征组合中选取1个以上的组合

    # itertools的combinations 函数可以返回一个列表选多少个元素的组合结果,例如combinations(list,2)返回的列表元素选2个的组合

    # 我们需要选择1-(count-1)的组合

    featureIndex = range(count)

    featureIndex.pop(0)

    combinationsList = []

    resList=[]

    # 遍历所有的组合

    for i in featureIndex:

        temp_combination = list(combinations(features, len(features[0:i])))

        combinationsList.extend(temp_combination)

        combiLen = len(combinationsList)

    # 每次组合的顺序都是一致的,并且也是对称的,所以我们取首尾组合集合

    # zip函数提供了两个列表对应位置组合的功能

    resList = zip(combinationsList[0:combiLen/2], combinationsList[combiLen-1:combiLen/2-1:-1])

    return resList

# 返回最好的特征以及二分特征值

def chooseBestFeatureToSplit(dataSet):

    numFeatures = len(dataSet[0]) - 1      #

    bestStDev = inf; bestFeature = -1;bestBinarySplit=()

    for i in range(numFeatures):        #遍历特征

        featList = [example[i] for example in dataSet]#得到特征列

        uniqueVals = list(set(featList))       #从特征列获取该特征的特征值的set集合

        # 三个特征值的二分结果:

        # [(('young',), ('old', 'middle')), (('old',), ('young', 'middle')), (('middle',), ('young', 'old'))]

        for split in featuresplit(uniqueVals):

            StDev = 0.0

            if len(split)==1:

                continue

            (left,right)=split

            # print split,

            # 对于每一个可能的二分结果计算gini增益

            # 左增益

            left_subDataSet = splitDataSet(dataSet, i, left)

            left_prob = len(left_subDataSet)/float(len(dataSet))

            S,u = calStDev(left_subDataSet)

            StDev += left_prob * S

            # 右增益

            right_subDataSet = splitDataSet(dataSet, i, right)

            right_prob = len(right_subDataSet)/float(len(dataSet))

            S,u = calStDev(right_subDataSet)

            StDev += right_prob * S

            # print StDev

            if (StDev < bestStDev):       #比较是否是最好的结果

                bestStDev = StDev         #记录最好的结果和最好的特征

                bestFeature = i

                bestBinarySplit=(left,right)

    return bestFeature,bestBinarySplit,bestStDev

def majorityCnt(classList):

    classCount={}

    for vote in classList:

        if vote not in classCount.keys(): classCount[vote] = 0

        classCount[vote] += 1

    sortedClassCount = sorted(classCount.iteritems(), key=operator.itemgetter(1), reverse=True)

    return sortedClassCount[0][0]

def createTree(dataSet,labels,originalS):

    classList = [example[-1] for example in dataSet]

    # print dataSet

    if classList.count(classList[0]) == len(classList):

        return classList[0]#所有的类别都一样,就不用再划分了

    if len(dataSet) == 1: #如果没有继续可以划分的特征,就多数表决决定分支的类别

        return majorityCnt(classList)

    bestFeat,bestBinarySplit,bestStDev = chooseBestFeatureToSplit(dataSet)

    if bestStDev < 0.05*originalS:

        return 1.0*sum(classList)/len(classList)

    # print bestFeat,bestBinarySplit,labels

    bestFeatLabel = labels[bestFeat]

    if bestFeat==-1:

        return majorityCnt(classList)

    myTree = {bestFeatLabel:{}}

    featValues = [example[bestFeat] for example in dataSet]

    uniqueVals = list(set(featValues))

    for value in bestBinarySplit:

        subLabels = labels[:]       # #拷贝防止其他地方修改

        if len(value)<2:

            del(subLabels[bestFeat])

        myTree[bestFeatLabel][value] = createTree(splitDataSet(dataSet, bestFeat, value),subLabels,originalS)

    return myTree

filename="regression_sample"

dataSet=[];labels=[];

with open(filename) as f:

    for line in f:

        fields=line.strip("\n").split("\t")

        t=fields[0:-1]

        t.append(int(fields[-1]))

        dataSet.append(t)

labels=["outlook","temperature","humidity","windy"]

# print dataSet

originalS,u=calStDev(dataSet)

# print originalS,u

tree= createTree(dataSet,labels,originalS)

print tree
cart中回归树的原理和实现的更多相关文章
- 回归树的原理及Python实现
大名鼎鼎的 GBDT 算法就是用回归树组合而成的.本文就回归树的基本原理进行讲解,并手把手.肩并肩地带您实现这一算法. 1. 原理篇 1.1 最简单的模型 如果预测某个连续变量的大小,最简单的模型之一 ...
- 连续值的CART(分类回归树)原理和实现
上一篇我们学习和实现了CART(分类回归树),不过主要是针对离散值的分类实现,下面我们来看下连续值的cart分类树如何实现 思考连续值和离散值的不同之处: 二分子树的时候不同:离散值需要求出最优的两个 ...
- 机器学习技法-决策树和CART分类回归树构建算法
课程地址:https://class.coursera.org/ntumltwo-002/lecture 重要!重要!重要~ 一.决策树(Decision Tree).口袋(Bagging),自适应增 ...
- CART(分类回归树)原理和实现
前面我们了解了决策树和adaboost的决策树墩的原理和实现,在adaboost我们看到,用简单的决策树墩的效果也很不错,但是对于更多特征的样本来说,可能需要很多数量的决策树墩 或许我们可以考虑使用更 ...
- CART分类与回归树与GBDT(Gradient Boost Decision Tree)
一.CART分类与回归树 资料转载: http://dataunion.org/5771.html Classification And Regression Tree(CART)是决策 ...
- 决策树的剪枝,分类回归树CART
决策树的剪枝 决策树为什么要剪枝?原因就是避免决策树“过拟合”样本.前面的算法生成的决策树非常的详细而庞大,每个属性都被详细地加以考虑,决策树的树叶节点所覆盖的训练样本都是“纯”的.因此用这个决策树来 ...
- 机器学习之分类回归树(python实现CART)
之前有文章介绍过决策树(ID3).简单回顾一下:ID3每次选取最佳特征来分割数据,这个最佳特征的判断原则是通过信息增益来实现的.按照某种特征切分数据后,该特征在以后切分数据集时就不再使用,因此存在切分 ...
- 分类-回归树模型(CART)在R语言中的实现
分类-回归树模型(CART)在R语言中的实现 CART模型 ,即Classification And Regression Trees.它和一般回归分析类似,是用来对变量进行解释和预测的工具,也是数据 ...
- CART(分类回归树)
1.简单介绍 线性回归方法可以有效的拟合所有样本点(局部加权线性回归除外).当数据拥有众多特征并且特征之间关系十分复杂时,构建全局模型的想法一个是困难一个是笨拙.此外,实际中很多问题为非线性的,例如常 ...
随机推荐
- Android Studio 快捷键 for mac
Action Mac OS Win/Linux 打开文件 Cmd + shift + O 打开Class文件 Cmd + O 覆写方法 Ctrl + O 生成方法(重写构造.setter ...
- C# 遍历DLL导出函数
C#如何去遍历一个由C++或E语言编写的本地DLL导出函数呢 不过在这里我建议对PE一无所知的人 你或许应先补补这方面的知识,我不知道为什么PE方面的 应用在C#中怎么这么少,我查阅过相关 C#的知识 ...
- 转:Android开发之旅:环境搭建及HelloWorld
http://www.cnblogs.com/skynet/archive/2010/04/12/1709892.html 引言 本系列适合0基础的人员,因为我就是从0开始的,此系列记录我步入Andr ...
- Jenkins 安装或更新插件失败
试试这个插件网址是否可以在网页中打开 http://mirror.xmission.com/jenkins/updates/current/update-center.json 如可以,把这个网址 ...
- VS2012文本编辑器鼠标不能滚动
- 编写并发程序 Inversion
做完了 scala parallel 课程作业后,觉得 scala 写并发程序的便捷性是 java 永远都追不上的.scala 的Future 和 Promise,java 里 Future 和 Co ...
- nginx server_name
在我的机子了nginx的 server_name要配制成127.0.0.1才能用,否则就报错,刚试用nginx还不知道为什么,先记下来
- WCF中因序列化问题引起的异常和错误。
尝试对参数 http://tempuri.org/ 进行序列化时出错: parameters.InnerException 消息是“不应为数据协定名称为“DBNull:http://schemas.d ...
- 【学】SoapExtension 学习
http://msdn.microsoft.com/zh-cn/library/System.Web.Services.Protocols.SoapExtension_methods(v=vs.80) ...
- C#连接mysql数据库插入数据后获取自增长主键ID值
From: http://blog.csdn.net/zbc496218/article/details/51082983 MySqlConnection conn = new MySqlConnec ...