
010 Spark中的监控----日志聚合的配置,以及REST Api
一:History日志聚合的配置
1.介绍
Spark的日志聚合功能不是standalone模式独享的,是所有运行模式下都会存在的情况
默认情况下历史日志是保存到tmp文件夹中的
2.参考官网的知识点位置

3.修改spark-defaults.conf

4.修改env.sh

5.在HDFS上新建/spark-history
bin/hdfs dfs -mkdir /spark-history
6.启动历史服务
sbin/start-history-server.sh

7.测试
webUI: http://192.168.187.146:18080/
local模式:bin/spark-shell
standalone模式:bin/spark-shell --master spark://linux-hadoop3.ibeifeng.com:7070
8.local模式的测试
bin/spark-shell
然后输入程序。
在

9.standalone模式
bin/spark-shell --master spark://linux-hadoop3.ibeifeng.com:7070
输入程序
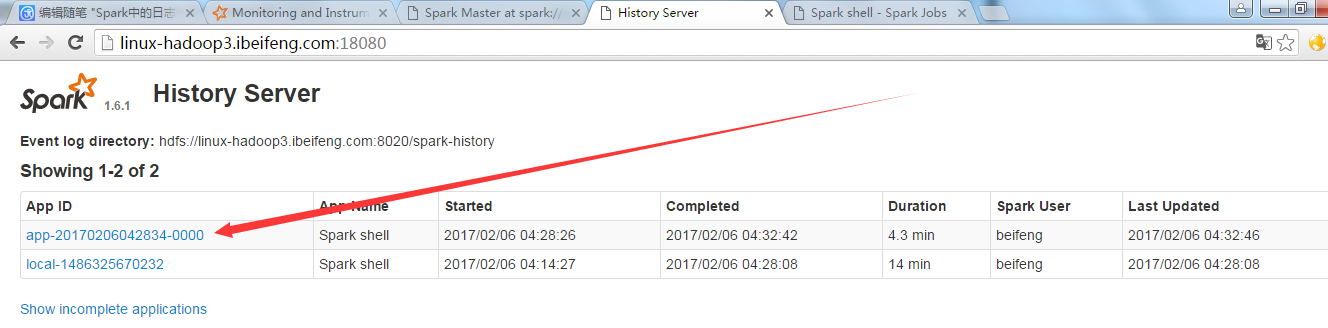
二:RestApi
返回应用程序的执行结果。
1.关于RestApi的官网
也是属于monitor的部分

2.介绍
专门用于获取历史应用的执行结果
用法: http://<server-url>:18080/api/v1
3.使用
http://linux-hadoop3.ibeifeng.com:18080/api/v1/applications

4.进一步使用
http://linux-hadoop3.ibeifeng.com:18080/api/v1/applications/app-20170206042834-0000/jobs

010 Spark中的监控----日志聚合的配置,以及REST Api的更多相关文章
- Spark进阶之路-日志服务器的配置
Spark进阶之路-日志服务器的配置 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 如果你还在纠结如果配置Spark独立模式(Standalone)集群,可以参考我之前分享的笔记: ...
- 024 关于spark中日志分析案例
1.四个需求 需求一:求contentsize的平均值.最小值.最大值 需求二:请各个不同返回值的出现的数据 ===> wordCount程序 需求三:获取访问次数超过N次的IP地址 需求四:获 ...
- SQL Server中的事务日志管理(9/9):监控事务日志
当一切正常时,没有必要特别留意什么是事务日志,它是如何工作的.你只要确保每个数据库都有正确的备份.当出现问题时,事务日志的理解对于采取修正操作是重要的,尤其在需要紧急恢复数据库到指定点时.这系列文章会 ...
- Spark中的编程模型
1. Spark中的基本概念 Application:基于Spark的用户程序,包含了一个driver program和集群中多个executor. Driver Program:运行Applicat ...
- 苏宁基于Spark Streaming的实时日志分析系统实践 Spark Streaming 在数据平台日志解析功能的应用
https://mp.weixin.qq.com/s/KPTM02-ICt72_7ZdRZIHBA 苏宁基于Spark Streaming的实时日志分析系统实践 原创: AI+落地实践 AI前线 20 ...
- SQL Server中的事务日志管理(8/9):优化日志吞吐量
当一切正常时,没有必要特别留意什么是事务日志,它是如何工作的.你只要确保每个数据库都有正确的备份.当出现问题时,事务日志的理解对于采取修正操作是重要的,尤其在需要紧急恢复数据库到指定点时.这系列文章会 ...
- 关于Spark中RDD的设计的一些分析
RDD, Resilient Distributed Dataset,弹性分布式数据集, 是Spark的核心概念. 对于RDD的原理性的知识,可以参阅Resilient Distributed Dat ...
- Spark中的键值对操作-scala
1.PairRDD介绍 Spark为包含键值对类型的RDD提供了一些专有的操作.这些RDD被称为PairRDD.PairRDD提供了并行操作各个键或跨节点重新进行数据分组的操作接口.例如,Pa ...
- Spark中的键值对操作
1.PairRDD介绍 Spark为包含键值对类型的RDD提供了一些专有的操作.这些RDD被称为PairRDD.PairRDD提供了并行操作各个键或跨节点重新进行数据分组的操作接口.例如,Pa ...
随机推荐
- [C++]指针/指针数组/数组指针/多维指针/单值指针/多值指针
int main(){ //单值指针(指向单个值得指针,类同普通变量) int *px = new int; *px = 100; printf("%d",*px); delete ...
- JavaScript之12306自动刷新车票[待完善]
function refresh(){ var search_btn = document.getElementById("query_ticket"); var result_t ...
- mysql 5.7 ~ 新特性
mysql 5.7特性 简介:mysql 5.7内存和线程性能方面的优化一 细节优化 参数: 1 innodb_buffer_pool 改进 innodb_buffer_pool可以动态扩大, ...
- linux下比较两个文本文件的不同——diff命令
1>Diff命令的功能Linux中Diff命令的功能为逐行比较两个文本文件,列出其不同之处.它对给出的文件进行系统的检查,并显示出两个文件中所有不同的行,不要求事先对文件进行排序. 2>语 ...
- 配置使用OpenCV静态链接库
配置opencv静态链接库需要用到:staticlib 在配置链接器->附加库目录时应该为staticlib的路径.同理若是利用动态链接库则只需要lib的路径: 动态链接库则使用lib,然而在使 ...
- 六、regularized logisitic regssion练习(转载)
转载链接:http://www.cnblogs.com/tornadomeet/archive/2013/03/17/2964858.html 在上一讲Deep learning:五(regulari ...
- [转]Linux下的链接脚本基础
[转]http://linux.chinaunix.net/techdoc/beginner/2009/08/12/1129972.shtml 1. 前言 (1)每一个链接过程都由链接脚本(linke ...
- oracle 回退表空间清理
1.查看已有表空间,找到回退表空间 SELECT * FROM DBA_TABLESPACES WHERE CONTENTS='UNDO' 2.创建新的回退表空间 create undo tables ...
- 反向代理负载均衡之APACHE
反向代理负载均衡之APACHE 一.反向代理1.1 介绍反响代理 反向代理(Reverse Proxy)方式是指以代理服务器来接受internet上的连接请求,然后将请求转发给内部网络上的服务器,并将 ...
- 源码编译安装mysql5.5.33
源码编译安装mysql5.5.33 一.安装cmake编译工具 跨平台编译器 # yum install -y gcc* # yum install -y cmake 解决依赖关系 # yum ins ...