
spark shuffle的写操作之准备工作
前言
在前三篇文章中,spark 源码分析之十九 -- DAG的生成和Stage的划分 剖析了DAG的构建和Stage的划分,spark 源码分析之二十 -- Stage的提交 剖析了TaskSet任务的提交,以及spark 源码分析之二十一 -- Task的执行细节剖析了Task执行的整个流程。在第三篇文章中侧重剖析了Task的整个执行的流程是如何的,对于Task本身是如何执行的 ResultTask 和 ShuffleMapTask两部分并没有做过多详细的剖析。本篇文章我们针对Task执行的细节展开,包括Task、ResultTask、ShuffleMapTask的深入剖析以及Spark底层的shuffle的实现机制等等。
Spark的任务划分为ResultTask和ShuffleMapTask两种任务。
其中ResultTask相对来说比较简单,只是读取上一个Stage的执行结果或者是从数据源读取任务,最终将结果返回给driver。
ShuffleMapTask相对复杂一些,中间涉及了shuffle过程。
紧接上篇
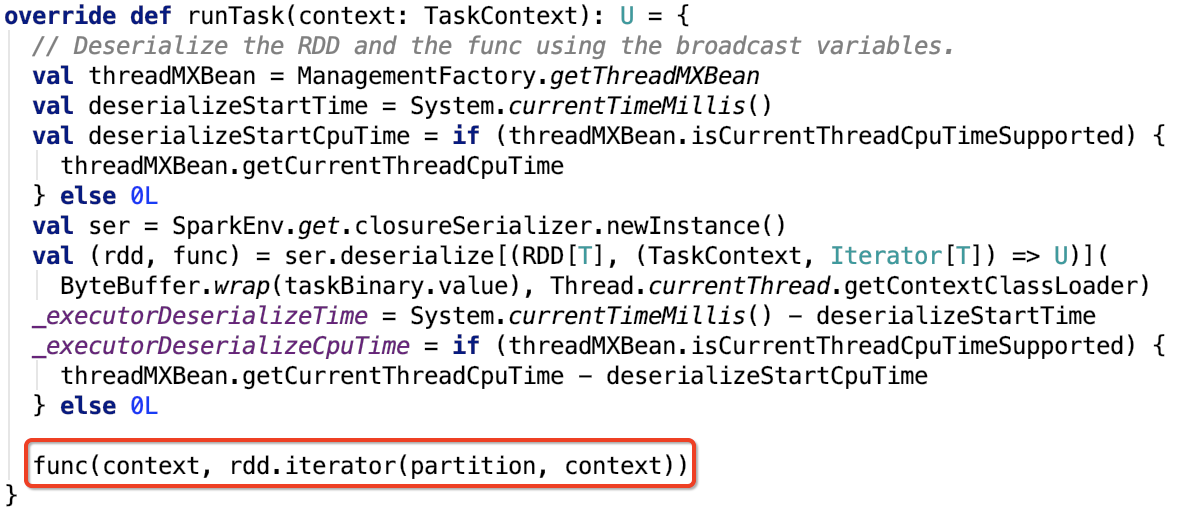
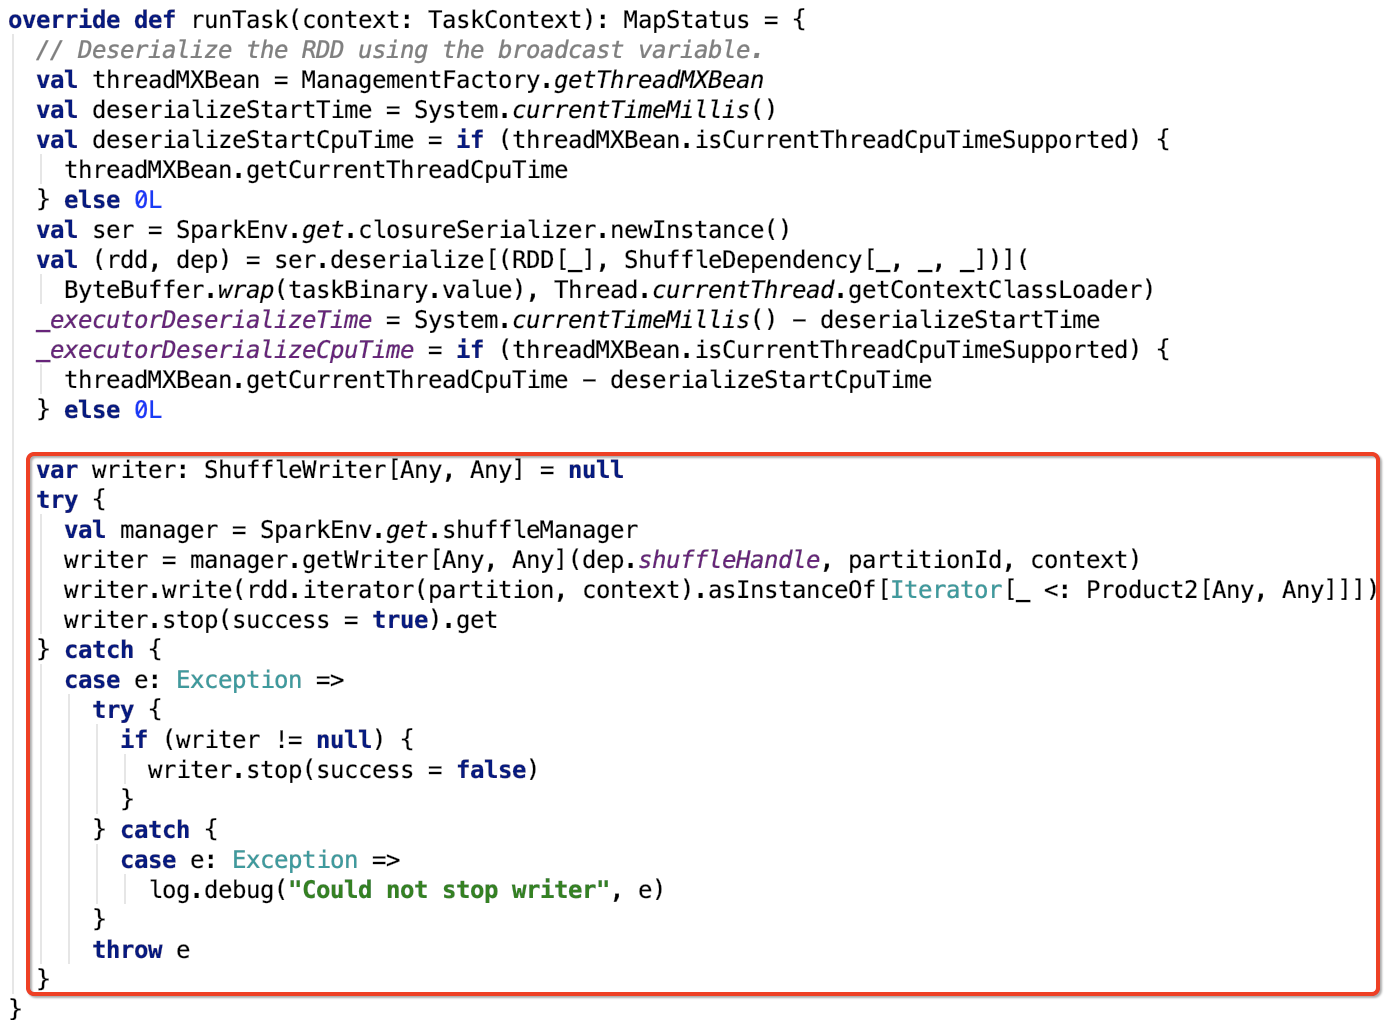
我们再来看一下,ResultTask和ShuffleMapTask的runTask方法。现在只关注数据处理逻辑,下面的两张图都做了标注。
ResultTask
类名:org.apache.spark.scheduler.ResultTask
其runTask方法如下:
ShuffleMapTask
类名:org.apache.spark.scheduler.ShuffleMapTask
其runTask方法如下:
两种Task执行的相同和差异
相同点
- 这两种Task都是在RDD的分区上执行的。
- 两种Task都需要调用父RDD的iterator方法来获取父RDD对应分区的数据。
- 这些数据可以直接来自于数据源,也可以直接来自于上一个ShuffleMapTask执行的结果。
- 当一个Stage中所有分区的Task都执行完毕,这个Stage才算执行完毕。
差异点
- ResultTask获取父RDD分区数据之后,把分区数据作为参数输入到action函数中,最终计算出特定的结果返回给driver。
- ShuffleMapTask获取父RDD分区数据之后,把分区数据作为参数传入分区函数,最终形成新的RDD中的分区数据,保存在各个Executor节点中,并将分区数据信息MapStatus返回给driver。
总结关注点
由两种Task执行的相同和差异点可以总结出,要想对这两种类型的任务执行有非常深刻的理解,必须搞明白shuffle 数据的读写。这也是spark 计算的核心的关注点 -- Shuffle的写操作、Shuffle的读操作。
shuffle数据分类
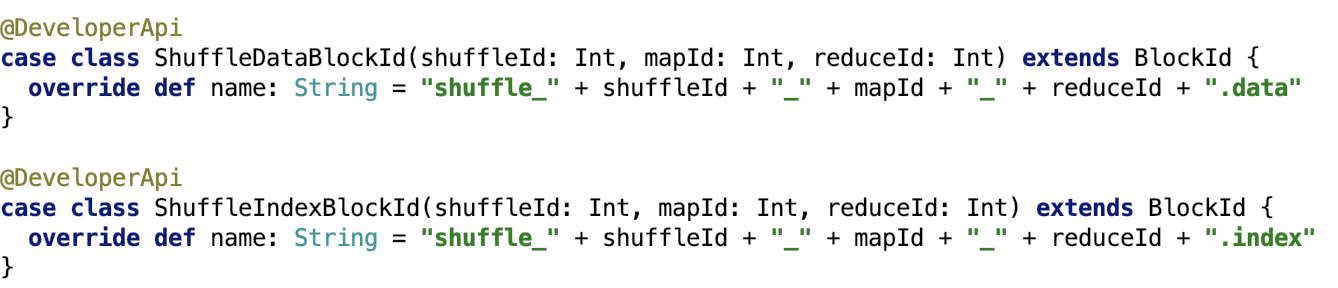
shuffle过程中写入Spark存储系统的数据分为两种,一种是shuffle数据,一种是shuffle索引数据,如下:
shuffle数据的管理类--IndexShuffleBlockResolver
下面说一下 IndexShuffleBlockResolver 类。这个类负责shuffle数据的获取和删除,以及shuffle索引数据的更新和删除。
IndexShuffleBlockResolver继承关系如下:
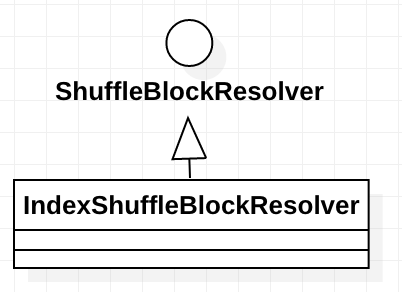
我们先来看父类ShuffleBlockResolver。
ShuffleBlockResolver
主要是负责根据逻辑的shuffle的标识(比如mapId、reduceId或shuffleId)来获取shuffle的block。shuffle数据一般都被File或FileSegment包装。
其接口定义如下:
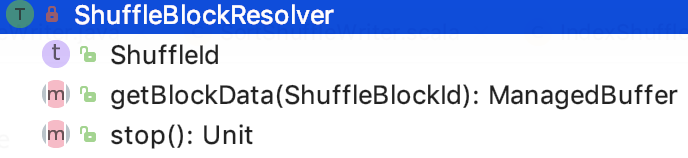
其中,getBlockData根据shuffleId获取shuffle数据。
下面来看 IndexShuffleBlockResolver的实现。
IndexShuffleBlockResolver
这个类负责shuffle数据的获取和删除,以及shuffle索引数据的更新和删除。
类结构如下:
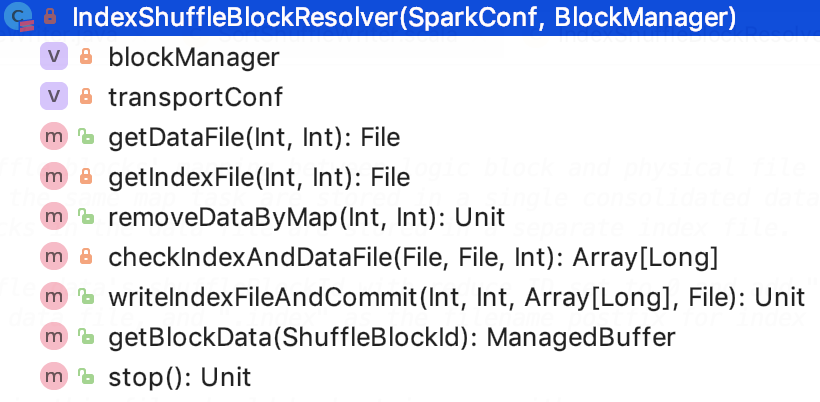
blockManager是executor上的BlockManager类。
transportCpnf主要是包含了关于shuffle的一些参数配置。
NOOP_REDUCE_ID是0,因为此时还不知道reduce的id。
核心方法如下:
1. 获取shuffle数据文件,源码如下,思路:根据blockManager的DiskBlockManager获取shuffle的blockId对应的物理文件。

2. 获取shuffle索引文件,源码如下,思路:根据blockManager的DiskBlockManager获取shuffle索引的blockId对应的物理文件。

3.根据mapId将shuffle数据移除,源码如下,思路:根据shuffleId和mapId删除shuffle数据和索引文件
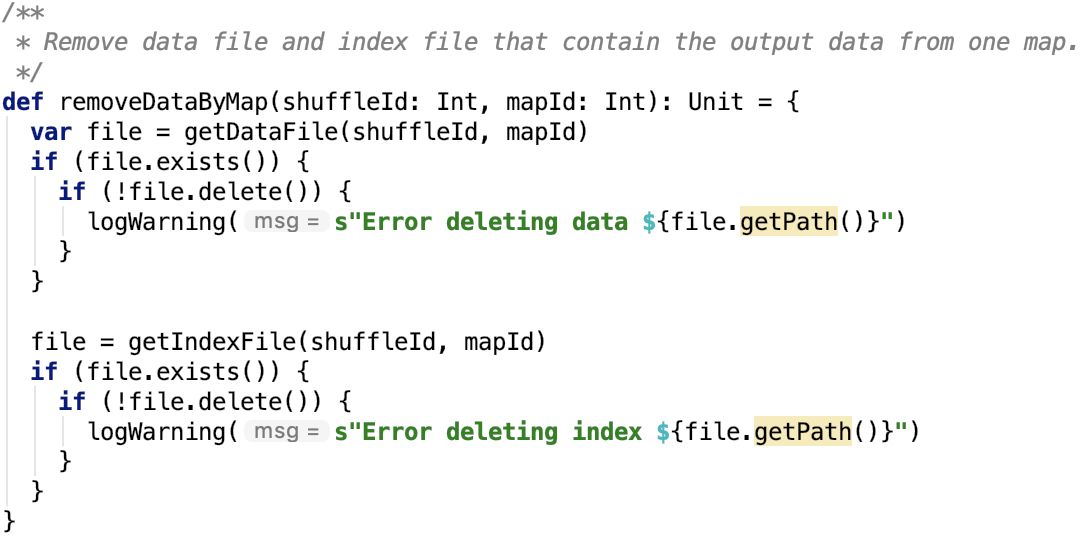
4.校验shuffle索引和数据,源码如下。
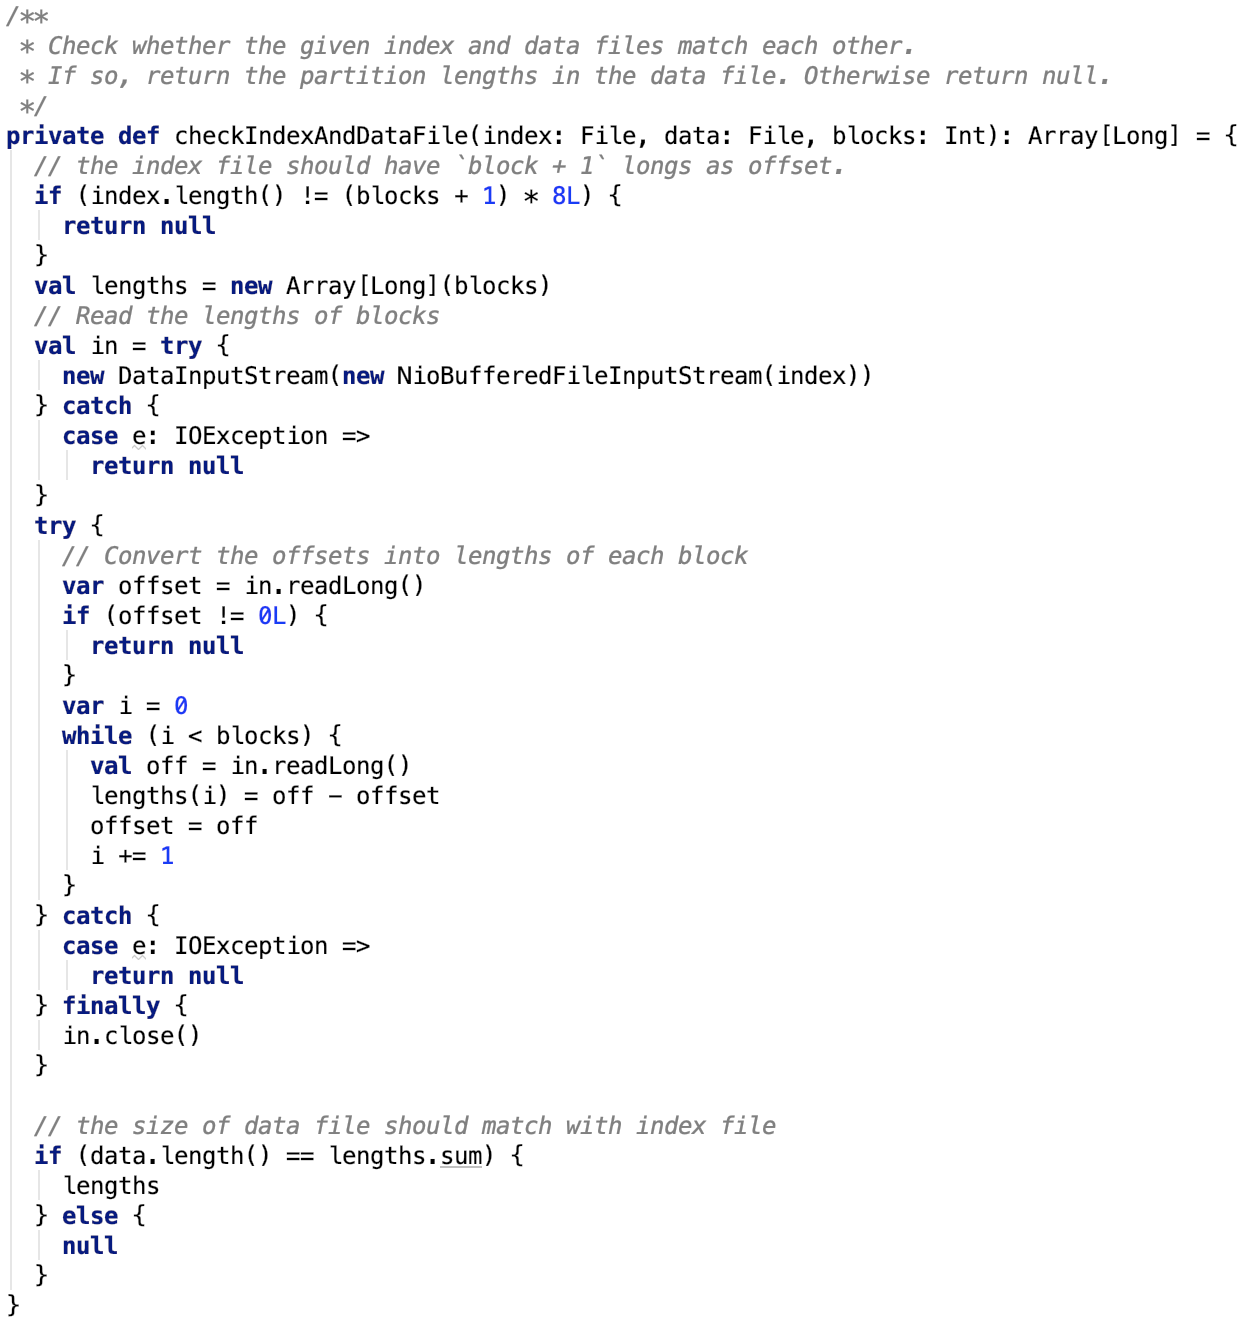
从上面可以看出,文件里第一个long型数是占位符,必为0.
后面的保存的数据是每一个block的大小,可以看出来,每次读的long型数,是前面所有block的大小总和。
所以,当前block的大小=这次读取到的offset - 上次读取到的offset
这种索引的设计非常巧妙。每一个block大小合起来就是整个文件的大小。每一个block的在整个文件中的offset也都记录在索引文件中。
5. 写索引文件,源码如下。

思路:首先先获取shuffle的数据文件并创建索引的临时文件。
获取索引文件的每一个block 的大小。如果索引存在,则更新新的索引数组,删除临时数据文件,返回。
若索引不存在,将新的数据的索引数据写入临时索引文件,最终删除历史数据文件和历史索引文件,然后临时数据文件和临时数据索引文件重命名为新的数据和索引文件。
这样的设计,确保了数据索引随着数据的更新而更新。
6. 根据shuffleId获取block数据,源码如下。
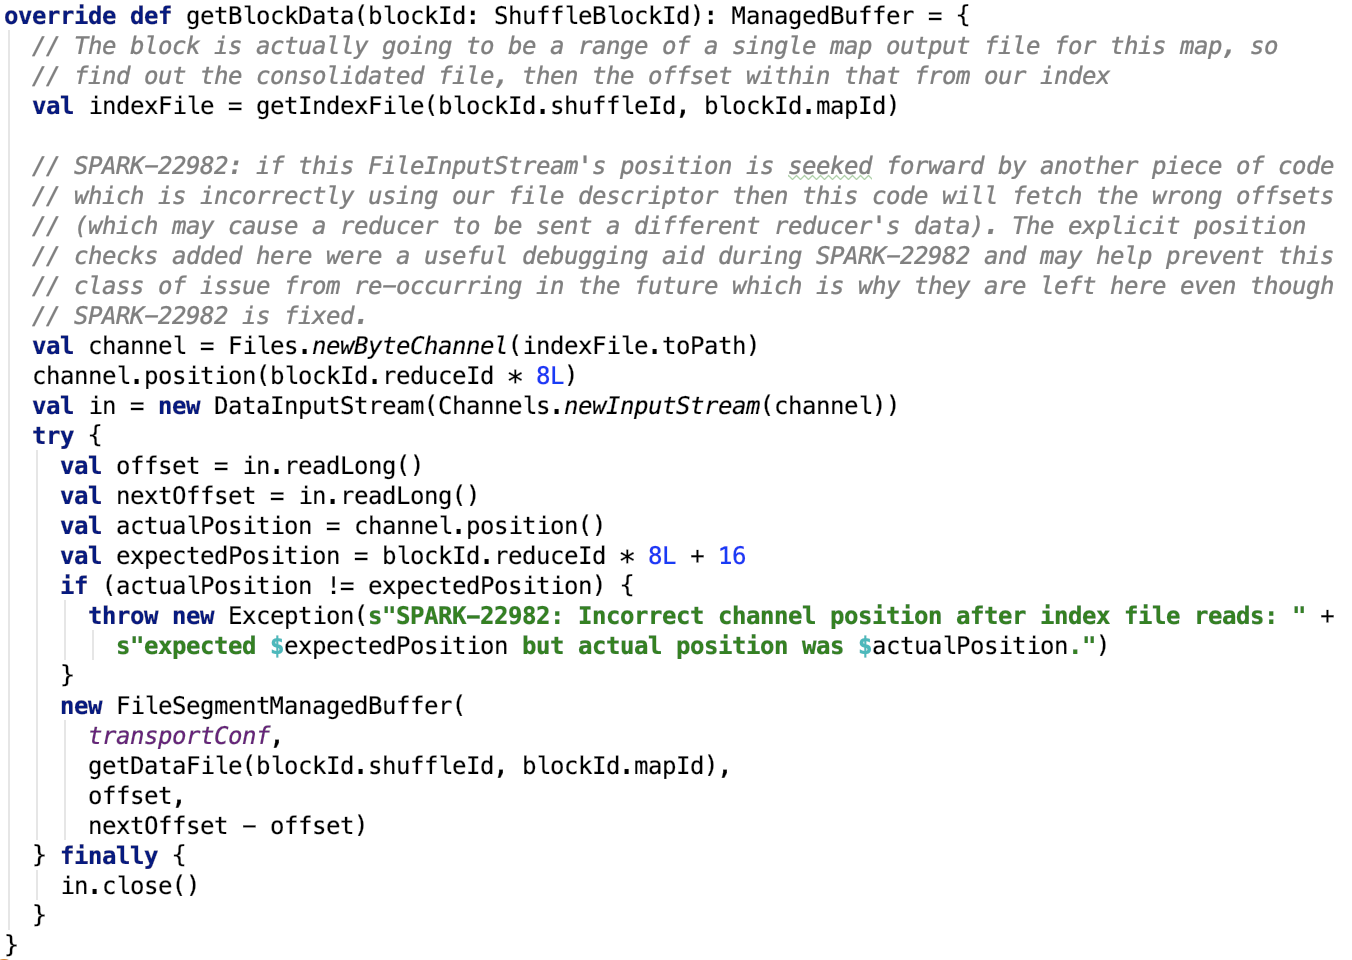
思路:
先获取shuffle数据的索引数据,然后调用position位上,获取block 的大小,然后初始化FileSegmentManagedBuffer,读取文件的对应segment的数据。
可以看出 reduceId就是block物理文件中的小的block(segment)的索引。
7. 停止blockResolver,空实现。
总结,在这个类中,可以学习到spark shuffle索引的设计思路,在工作中需要设计File和FileSegment的索引文件,这也是一种参考思路。
Shuffle的写数据前的准备工作
直接来看 org.apache.spark.scheduler.ShuffleMapTask 的runTask的关键代码如下:
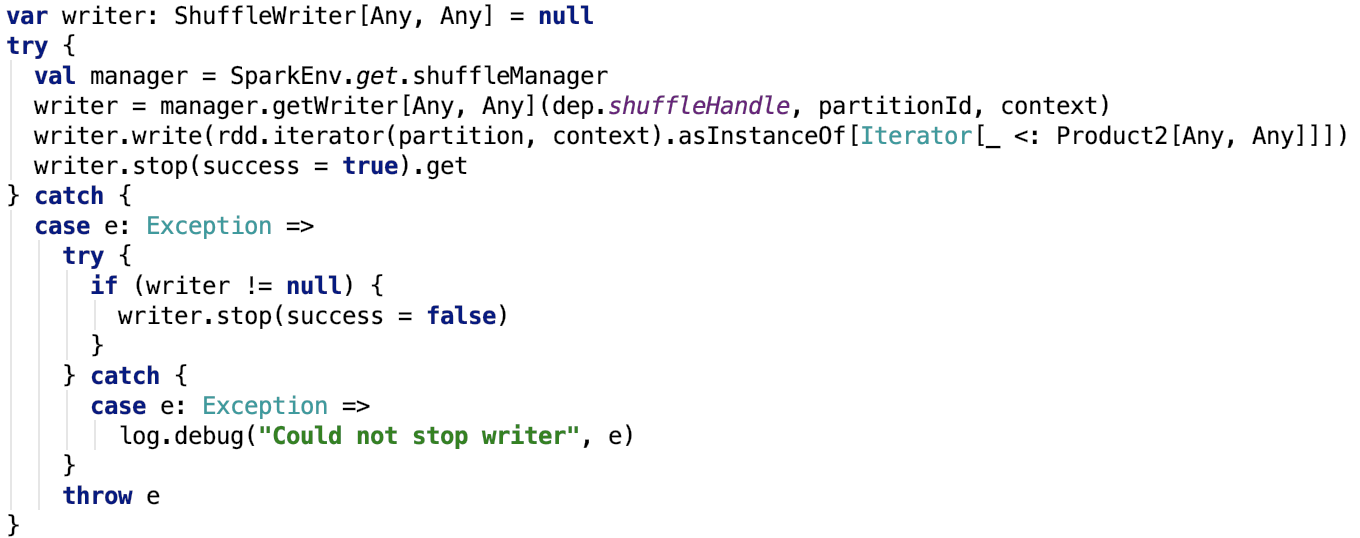
这里的manager是SortShuffleManager,是ShuffleManager的唯一实现。
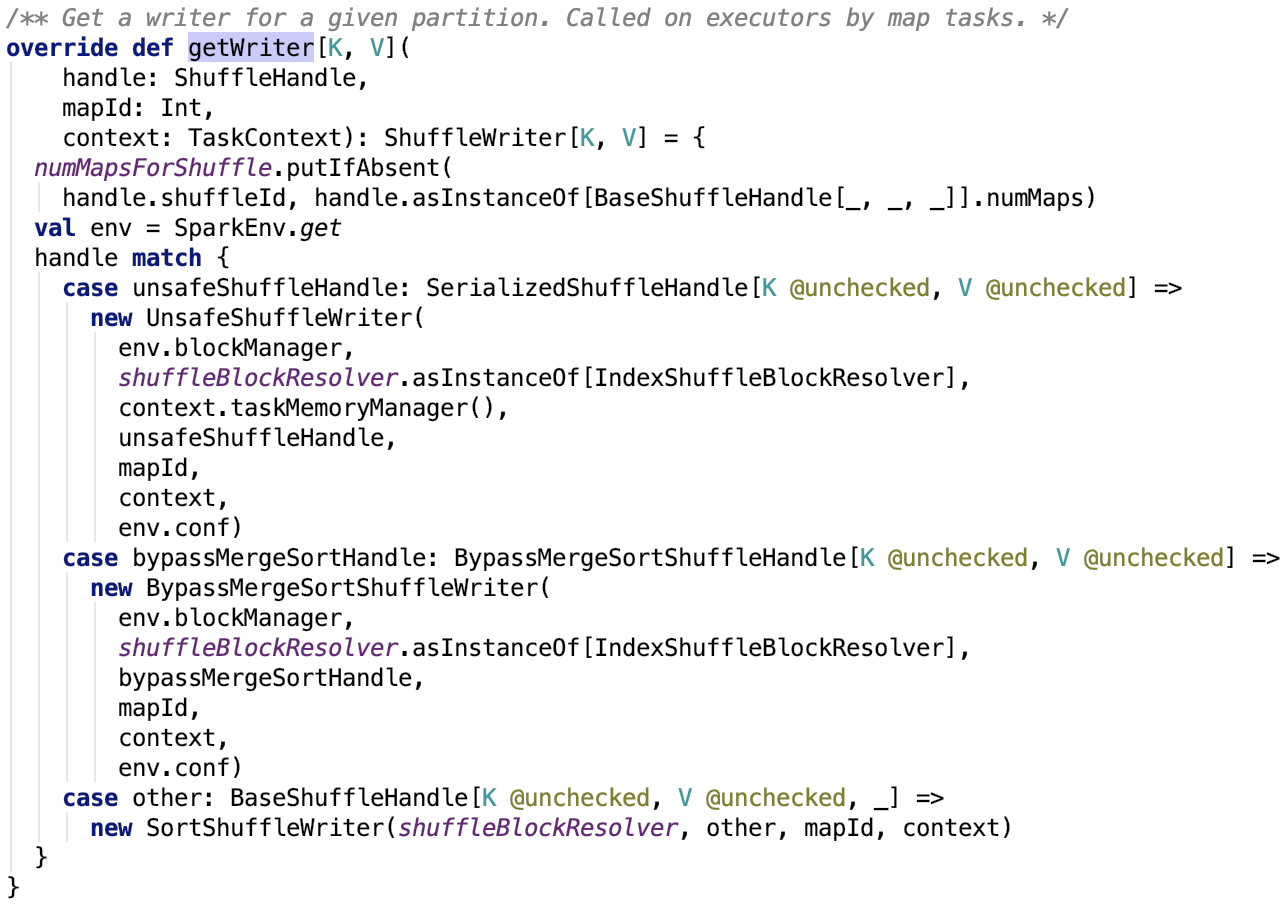
org.apache.spark.shuffle.sort.SortShuffleManager#getWriter 源码如下:
其中,numMapsForShuffle 定义如下:
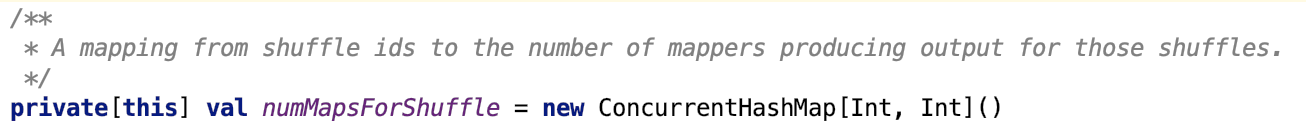
它保存了shuffleID和mapper数量的映射关系。
获取ShuffleHandle
首先,先来了解一下ShuffleHandle类。
ShuffleHandle
下面大致了解一下ShuffleHandle的相关内容。
类说明:
这个类是Spark内部使用的一个类,包含了关于Shuffle的一些信息,主要给ShuffleManage 使用。本质上来说,它是一个标志位,除了包含一些用于shuffle的一些属性之外,没有其他额外的方法,用case class来实现更好一点。
类源码如下:

继承关系如下:
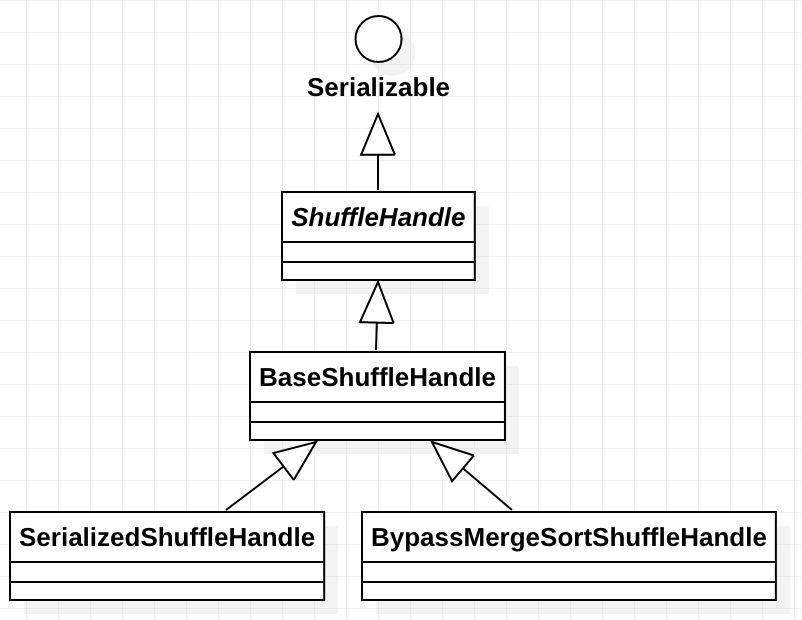
BaseShuffleHandle
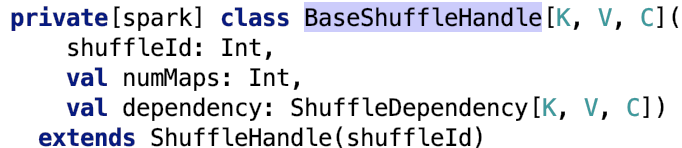
全称:org.apache.spark.shuffle.BaseShuffleHandle
类说明:
它是ShuffleHandle的基础实现。
类源码如下:
下面来看一下它的两个子类实现。
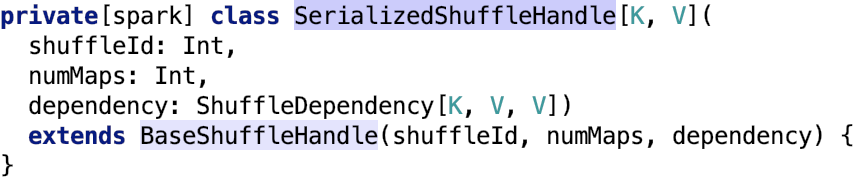
BypassMergeSortShuffleHandle
全称:org.apache.spark.shuffle.sort.BypassMergeSortShuffleHandle
类说明:
如果想用于序列化的shuffle实现,可以使用这个标志类。其源码如下:
SerializedShuffleHandle
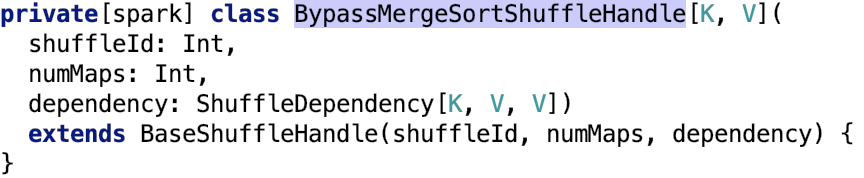
全称:org.apache.spark.shuffle.sort.SerializedShuffleHandle
类说明:
used to identify when we've chosen to use the bypass merge sort shuffle path.
类源码如下:
获取ShuffleHandle
在org.apache.spark.ShuffleDependency中有如下定义:
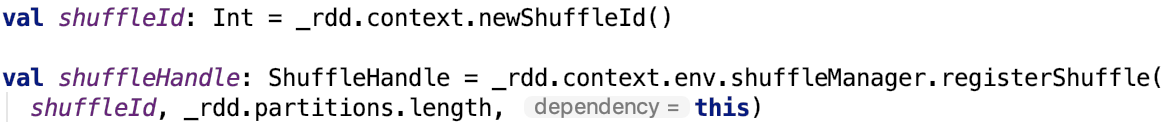
shuffleId是SparkContext生成的唯一全局id。
org.apache.spark.shuffle.sort.SortShuffleManager#registerShuffle 源码如下:
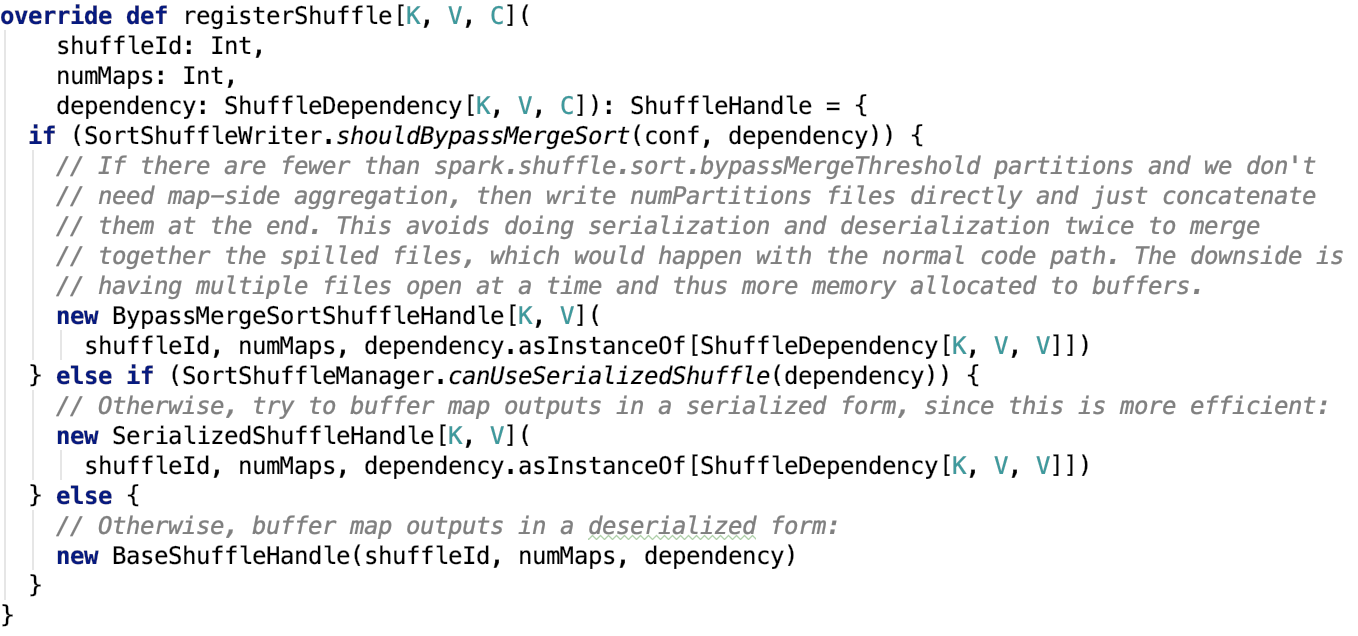
可以看出,mapper的数量等于父RDD的分区的数量。
下面,看一下使用bypassMergeSort的条件,即org.apache.spark.shuffle.sort.SortShuffleWriter#shouldBypassMergeSort 源码如下:
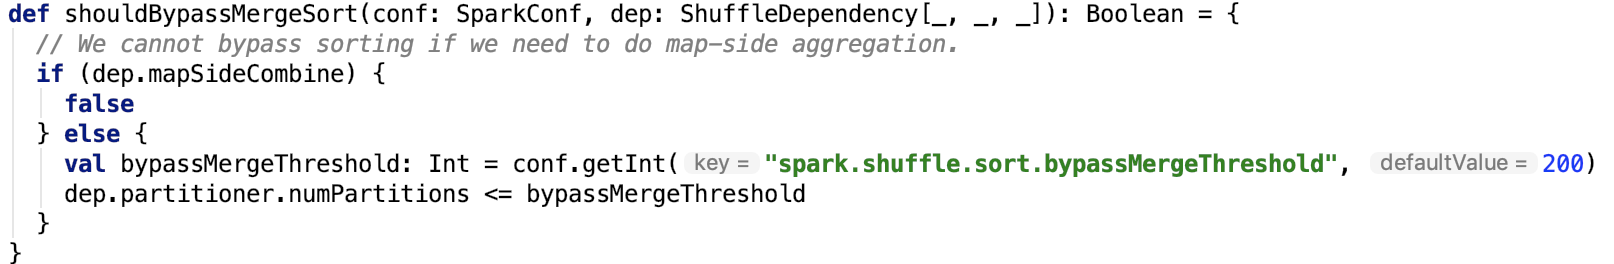
思路:首先如果父RDD没有启用mapSideCombine并且父RDD的结果分区数量小于bypassMergeSort阀值,则使用 bypassMergeSort。其中bypassMergeSort阀值 默认是200,可以通过 spark.shuffle.sort.bypassMergeThreshold 参数设定。
使用serializedShuffle的条件,即org.apache.spark.shuffle.sort.SortShuffleManager#canUseSerializedShuffle 源码如下:

思路:序列化类支持支持序列化对象的迁移,并且不使用mapSideCombine操作以及父RDD的分区数不大于 (1 << 24) 即可使用该模式的shuffle。
根据ShuffleHandle获取ShuffleWriter
首先先对ShuffleWriter做一下简单说明。
ShuffleWriter
类说明:它负责将map任务的输出写入到shuffle系统。其继承关系如下,对应着ShuffleHandle的三种shuffle实现标志。
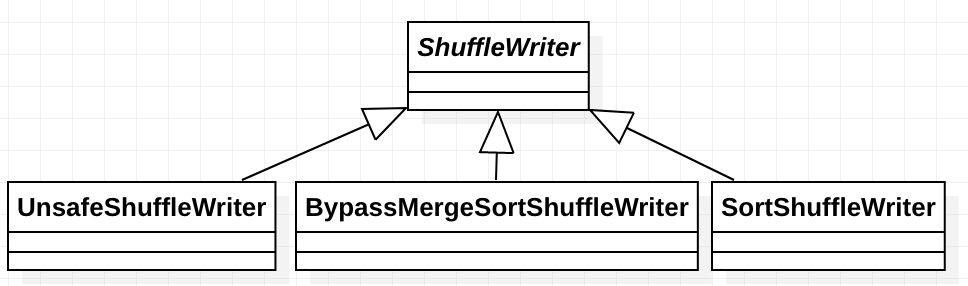
获取ShuffleWriter
org.apache.spark.shuffle.sort.SortShuffleManager#getWriter源码如下:
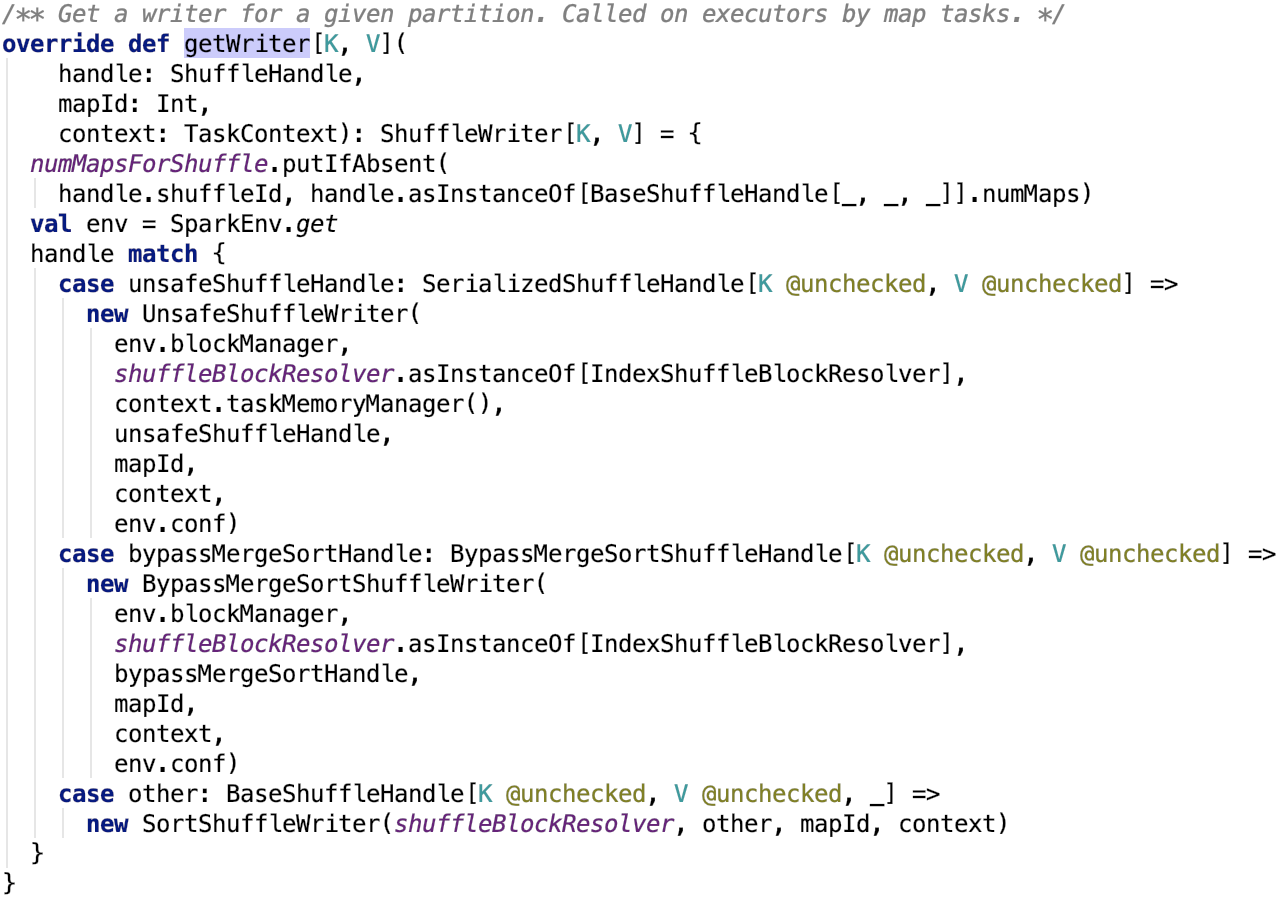
一个mapper对应一个writer,一个writer往一个分区上的写数据。
总结
本篇文章主要从Task 的差异和相同点出发,引出spark shuffle的重要性,接着对Spark shuffle数据的类型以及spark shuffle的管理类做了剖析。最后介绍了三种shuffle类型的标志位以及如何确定使用哪种类型的数据的。
接下来,正式进入mapper写数据部分。spark内部有三种实现,每一种写方式会有一篇文章专门剖析,我们逐一来看其实现机制。
spark shuffle的写操作之准备工作的更多相关文章
- spark shuffle写操作三部曲之UnsafeShuffleWriter
前言 在前两篇文章 spark shuffle的写操作之准备工作 中引出了spark shuffle的三种实现,spark shuffle写操作三部曲之BypassMergeSortShuffleWr ...
- spark shuffle写操作三部曲之BypassMergeSortShuffleWriter
前言 再上一篇文章 spark shuffle的写操作之准备工作 中,主要介绍了 spark shuffle的准备工作,本篇文章主要介绍spark shuffle使用BypassMergeSortSh ...
- spark shuffle读操作
提出问题 1. shuffle过程的数据是如何传输过来的,是按文件来传输,还是只传输该reduce对应在文件中的那部分数据? 2. shuffle读过程是否有溢出操作?是如何处理的? 3. shuff ...
- spark shuffle写操作之SortShuffleWriter
提出问题 1. spark shuffle的预聚合操作是如何做的,其中底层的数据结构是什么?在数据写入到内存中有预聚合,在读溢出文件合并到最终的文件时是否也有预聚合操作? 2. shuffle数据的排 ...
- Spark Shuffle原理、Shuffle操作问题解决和参数调优
摘要: 1 shuffle原理 1.1 mapreduce的shuffle原理 1.1.1 map task端操作 1.1.2 reduce task端操作 1.2 spark现在的SortShuff ...
- Spark Shuffle(一)ShuffleWrite:Executor如何将Shuffle的结果进行归并写到数据文件中去(转载)
转载自:https://blog.csdn.net/raintungli/article/details/70807376 当Executor进行reduce运算的时候,生成运算结果的临时Shuffl ...
- Spark-读写HBase,SparkStreaming操作,Spark的HBase相关操作
Spark-读写HBase,SparkStreaming操作,Spark的HBase相关操作 1.sparkstreaming实时写入Hbase(saveAsNewAPIHadoopDataset方法 ...
- Spark shuffle详细过程
有许多场景下,我们需要进行跨服务器的数据整合,比如两个表之间,通过Id进行join操作,你必须确保所有具有相同id的数据整合到相同的块文件中.那么我们先说一下mapreduce的shuffle过程. ...
- MapReduce Shuffle原理 与 Spark Shuffle原理
MapReduce的Shuffle过程介绍 Shuffle的本义是洗牌.混洗,把一组有一定规则的数据尽量转换成一组无规则的数据,越随机越好.MapReduce中的Shuffle更像是洗牌的逆过程,把一 ...
随机推荐
- PCA(主成分分析)算法
设有\(m\)个指标,\(n\)个样本的原始数据 将原始数据按列组成矩阵 \(X _ { n \times m }\) 将\(X\) 的每一列进行中心化 求\(X\)的协方差矩阵\(\Sigma _ ...
- Requests方法 -- cookie绕过验证码登录操作
前言有些登录的接口会有验证码:短信验证码,图形验证码等,这种登录的话验证码参数可以从后台获取的(或者查数据库最直接).获取不到也没关系,可以通过添加 cookie 的方式绕过验证码. 1.这里以登录博 ...
- 关于重写equals()和hashCode()的思考
最近这几天一直对equals()和hashCode()的事搞不清楚,云里雾里的. 为什么重写equals(),我知道. 但是为什么要两个都要重写呢,我就有点迷糊了,所以趁现在思考清楚后记录一下. 起因 ...
- 并发编程-concurrent指南-原子操作类-AtomicBoolean
类AtomicBoolean
- Codeforces 758D:Ability To Convert(思维+模拟)
http://codeforces.com/problemset/problem/758/D 题意:给出一个进制数n,还有一个数k表示在n进制下的值,求将这个数转为十进制最小可以是多少. 思路:模拟着 ...
- 小代学Spring Boot之开篇
想要获取更多文章可以访问我的博客 - 代码无止境. 前情提要 小代是一名入职不久的程序员,公司同事都亲切的称他小代.有一天小代的老大陈BOSS和小代说,公司后端最近准备换技术框架了. 小代: 换成啥? ...
- 简书全站爬取 mysql异步保存
# 简书网 # 数据保存在mysql中; 将selenium+chromedriver集成到scrapy; 整个网站数据爬取 # 抓取ajax数据 #爬虫文件 # -*- coding: utf-8 ...
- LinkedHashMap如何保证顺序性
一. 前言 先看一个例子,我们想在页面展示一周内的消费变化情况,用echarts面积图进行展示.如下: 我们在后台将数据构造完成 HashMap<String, Integer> map ...
- Redis 使用C#程序操作Redis
一.安装操作所需Nuget包 二.写入 redis只是按Key值设置过期时间,不是对value内部的某些值设过期 2.1 string类型 /// <summary> /// 向Redis ...
- JAVA基础-基础类型
学习JAVA的同学都知道,数据类型是基础中的基础,而JAVA本身是强类型语言,他对变量的类型有这魔一般的执著,所以学好JAVA的重心就是要学好数据类型.既然有强类型语言,就会有弱类型语言如PHP.Ja ...