
Multi-Agent Reinforcement Learning Based Frame Sampling for Effective Untrimmed Video Recognition
Multi-Agent Reinforcement Learning Based Frame Sampling for Effective Untrimmed Video Recognition
ICCV 2019 (oral)
2019-08-01 15:08:19
Paper:https://arxiv.org/abs/1907.13369
1. Backgroud and Motivation:
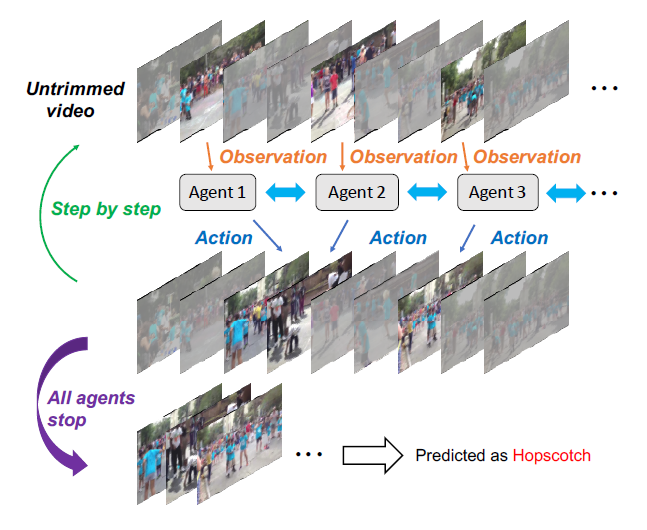
本文提出一种基于多智能体强化学习的未裁剪视频识别模型,来自适应的从未裁剪视频中,截取出样本视频帧进行行为识别。具体的示意图如下所示:
2. Architecture
2.1 Context-aware Observation Network:
这个 context-aware observation network 是一个基础的观测网络,随后是 context network。这个基础的观测网络是用于编码 选中的视频帧的视频信息,输出为 feature vector,作为 context network 的输入。与 single-agent 系统不同的是,multi-agent 的系统,每一个智能体的选择不仅依赖于 local environment state,而且受到 context information 的影响。所以,我们设计了一个 context-aware module,来维持一个 joint internal state of agents,用一个 RNN 网络将 history context information 进行总结。为了能够使之更加有效的工作,每一个智能体 only accesses context information from its 2M neighboring agents but not from all agents. 正式的来说,所有的时间步骤 t,智能体 a 观测到一个组合的状态 $s_t^a$ 及其 之前的 hidden state $h_{t-1}^a$ 作为 context module 的输入,然后产生其当前的 hidden states:
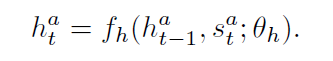
2.2 Policy Network:
作者采用 fc + softmax function 作为 policy network。在每一个时间步骤 t,每一个智能体 a,根据策略网络产生的概率分布, 选择一个动作 $u_t^a$ 来执行。动作集合是一个离散的空间 {moving ahead, moving back and staying}。并且设置一定的步幅。当所有的智能体都选择 staying 的时候,意味着该停止了。
2.3 Classification Network:
就是将选中的视频帧进行 action 的分类。
3. Objectives
本文将同时进行 奖励最大化的优化 以及 分类网络的优化。
3.1 MARL Objective:
Reward function: 奖励函数反应了 agents 选择动作的好坏。当所有的智能体都选择动作时,每一个时刻 t,每一个智能体基于分类的概率 $p_t^a$ 得到了其各自的奖励 $r_t^a$ 。给予 agent 奖励可以促使其知道更加具有信息量的 frame,从而一步一步的改善正确预测的概率。所以,作者设计了一个简单的奖励函数,鼓励模型增加其 confidence。特定的,对于第 t 个时间步骤来说,agent a 接收的奖励按照如下的方式进行计算:
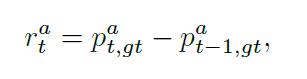
其中,$p_{t,c}^a$ 代表了智能体 a 在时刻 t 模型将其预测为 class c 的概率,gt 是视频的 ground truth label。所有的智能体共享同一个 reward function。考虑到序列决策的场景,考虑累积折扣回报是更加合适的,即:将来的奖励对当前的步骤贡献更小一些。特别的,在时刻 t,对于智能体 a 来说,折扣的回报可以计算如下:
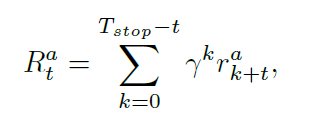
Policy Gradient: 服从 REINFORCE 算法,作者将目标函数设置为:
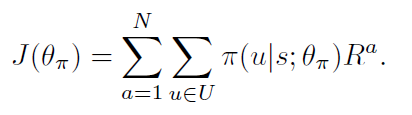
在本文的情况下,学习网络参数使其可以最大化上述公式,其梯度为:
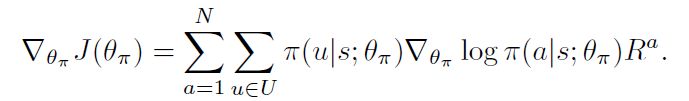
这变成了一个 non-trivial optimization problem, 由于 action sequence space 的维度过高。REINFORCE 通过蒙特卡洛采样的方式,进行梯度的估计:
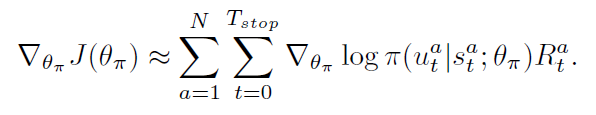
然后,我们可以利用随机梯度下降的方式,来最小化下面的损失:
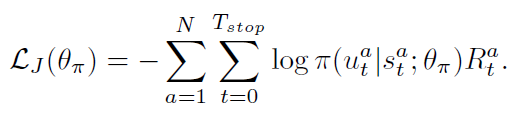
Maximum entropy:
为了避免让策略迅速变的 deterministic,研究者考虑将 entropy regularization 技术引入到 DRL 算法中,以鼓励探索。更大的熵,agent 就会更加偏向于探索其他动作。所以,我们利用 policy 的 entropy 来进行正则:
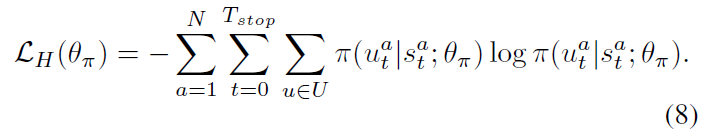
所以,MARL 总得损失是上述两个损失函数的加和:
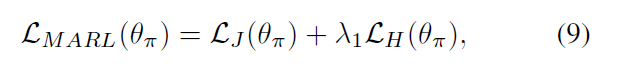
3.2 Classification Objective :
作者用 Cross-entropy loss 来最小化 gt 和 prediction p 之间的 KL-散度:
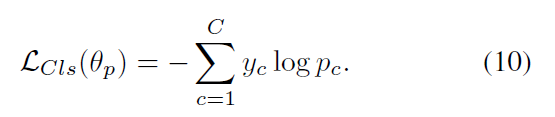
最终,我们优化组合损失,即:
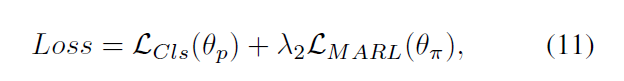
4. Experiments:


==
Multi-Agent Reinforcement Learning Based Frame Sampling for Effective Untrimmed Video Recognition的更多相关文章
- [转]Deep Reinforcement Learning Based Trading Application at JP Morgan Chase
Deep Reinforcement Learning Based Trading Application at JP Morgan Chase https://medium.com/@ranko.m ...
- [转]Introduction to Learning to Trade with Reinforcement Learning
Introduction to Learning to Trade with Reinforcement Learning http://www.wildml.com/2018/02/introduc ...
- Introduction to Learning to Trade with Reinforcement Learning
http://www.wildml.com/2015/12/implementing-a-cnn-for-text-classification-in-tensorflow/ The academic ...
- 【资料总结】| Deep Reinforcement Learning 深度强化学习
在机器学习中,我们经常会分类为有监督学习和无监督学习,但是尝尝会忽略一个重要的分支,强化学习.有监督学习和无监督学习非常好去区分,学习的目标,有无标签等都是区分标准.如果说监督学习的目标是预测,那么强 ...
- (转) Deep Reinforcement Learning: Pong from Pixels
Andrej Karpathy blog About Hacker's guide to Neural Networks Deep Reinforcement Learning: Pong from ...
- (转) Playing FPS games with deep reinforcement learning
Playing FPS games with deep reinforcement learning 博文转自:https://blog.acolyer.org/2016/11/23/playing- ...
- (转) Deep Learning Research Review Week 2: Reinforcement Learning
Deep Learning Research Review Week 2: Reinforcement Learning 转载自: https://adeshpande3.github.io/ad ...
- 论文笔记:Learning how to Active Learn: A Deep Reinforcement Learning Approach
Learning how to Active Learn: A Deep Reinforcement Learning Approach 2018-03-11 12:56:04 1. Introduc ...
- (zhuan) Evolution Strategies as a Scalable Alternative to Reinforcement Learning
Evolution Strategies as a Scalable Alternative to Reinforcement Learning this blog from: https://blo ...
随机推荐
- wokerman随笔
linux环境检查是否满足workerman要求: curl -Ss http://www.workerman.net/check.php | php workerman依赖扩展:pcntl扩展.po ...
- Linux crontab命令参数和时间格式说明
crontab 是用来让使用者在固定时间或固定间隔执行程序之用 参数说明 选项 功能 -e 编辑crontab定时任务 -l 查询crontab任务 -r 删除当前用户所有的crontab任务 时间格 ...
- 业余时间折腾了个微信小程序版本的街机游戏模拟器(吾爱街机),8090后的童年回忆,欢迎大家体验
好多年没来博客园了,有段时间想玩街机游戏,发现都需要下载安装,现在小程序这么流行,是不是可以集成到小程序里(无需下载,在线玩),出于这想法,就业余时间折腾了下,分享给大家,偶尔可以回味畅玩下. 中间遇 ...
- Codeforces D. Intercity Travelling(区间组合)
题目描述: D. Intercity Travelling time limit per test 1.5 seconds memory limit per test 256 megabytes in ...
- metasploit 一款开源的渗透测试框架
渗透神器漏洞利用框架metasploit from: https://zhuanlan.zhihu.com/p/30743401 metasploit是一款开源的渗透测试框架软件也是一个逐步发展与成熟 ...
- 通过Python实现mysql查询数据库实例
#coding:utf-8 ''' Created on 2017年10月25日 @author: li.liu ''' import pymysql db=pymysql.connect('loca ...
- [USACO08OCT]:打井Watering Hole(MST)
题意:有N个牧场,每个牧场修水井花费Wi,连接牧场花费Pij,问最小花费,使得每个牧场要么有水井,要么和有水井的牧场有通道. 思路:加一个格外的节点O,连接O表示修井,边权是修井的费用. 那么 ...
- python 中的tile函数,shape函数,sum函数
1.tile函数: tile函数是模板numpy.lib.shape_base中的函数.函数的形式是tile(A,reps) A的类型几乎所有类型都可以:array, list, tuple, dic ...
- SSM框架--Spring+SpringMVC+Mybatis (IDEA)搭建
使用idea创建一个maven项目( 这里演示 的是 web项目) 点击 Finish 然后开始配置 pom.xml文件(添加各种依赖jar包) 先去找 spring 所需的 jar包 jar包中心仓 ...
- jmeter使用教程
jmeter是基于JVM(最新版本基于jdk8+)的压测工具包.提供了丰富的工具来设置压测计划,执行压测任务和生成压测报告. 我这边使用的是windows10平台. 整个流程如下: 1.下载jmete ...