
第十六节:Scrapy爬虫框架之项目创建spider文件数据爬取
Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中。其最初是为了页面抓取所设计的, 也可以应用在获取API所返回的数据或者通用的网络爬虫。
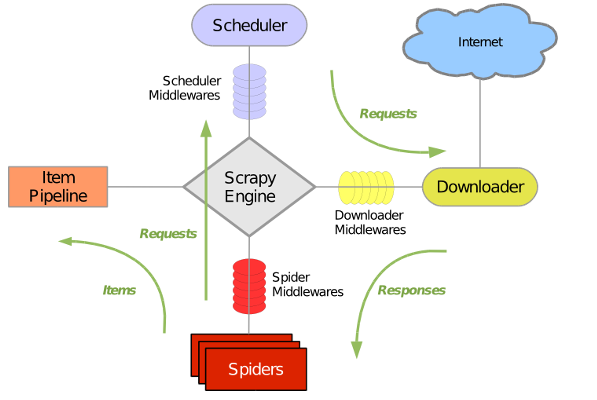
Scrapy原理图如下:
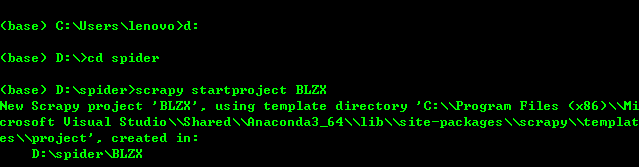
1、创建Scrapy项目:进入你需要创建scrapy项目的文件夹下,输入scrapy startproject BLZX(此处BLZX为爬虫项目名称)
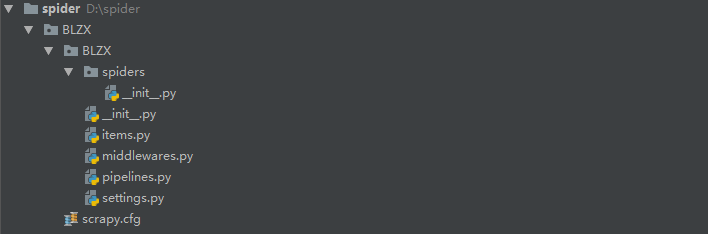
项目创建完成后出现一个scrapy框架自动给你生成的爬虫目录
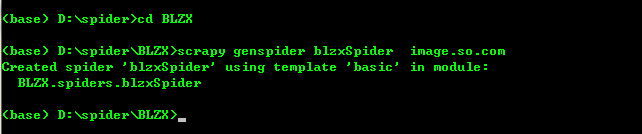
2、进入创建好的项目当中创建spider爬虫文件blzxSpider:
cd BLZX
scrapy genspider blzxSpider image.so.com (其中image.so.com为爬取数据的链接)
到此我们的scrapy爬虫项目已经创建完成,目录如下:
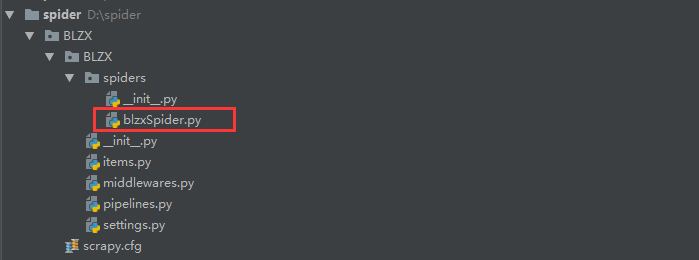
创建好了blzxSpider爬虫文件后scrapy将会在改文件当中自动生成 如下代码,我们就可以在这个文件当中进行编写代码爬取数据了。
# -*- coding: utf-8 -*-

import scrapy

class BlzxspiderSpider(scrapy.Spider):

    name = 'blzxSpider'

    allowed_domains = ['image.so.com']

    start_urls = ['http://image.so.com/']

    def parse(self, response):

        pass
3、爬取360图片玩转的图片,此时我们需要编写blzxSpiser文件进行爬取360图片
代码如下
import scrapy

import json

class BoleSpider(scrapy.Spider):

    name = 'boleSpider'

    def start_requests(self):

        url = "https://image.so.com/zj?ch=photography&sn={}&listtype=new&temp=1"

        page = self.settings.get("MAX_PAGE")

        for i in range(int(page)+1):

            yield scrapy.Request(url=url.format(i*30))

    def parse(self,response):

        photo_list = json.loads(response.text)

        for image in photo_list.get("list"):

            id = image["id"]

            url = image["qhimg_url"]

            title = image["group_title"]

            thumb = image["qhimg_thumb_url"]

            print(id,url,title,thumb)
抓取的结果为
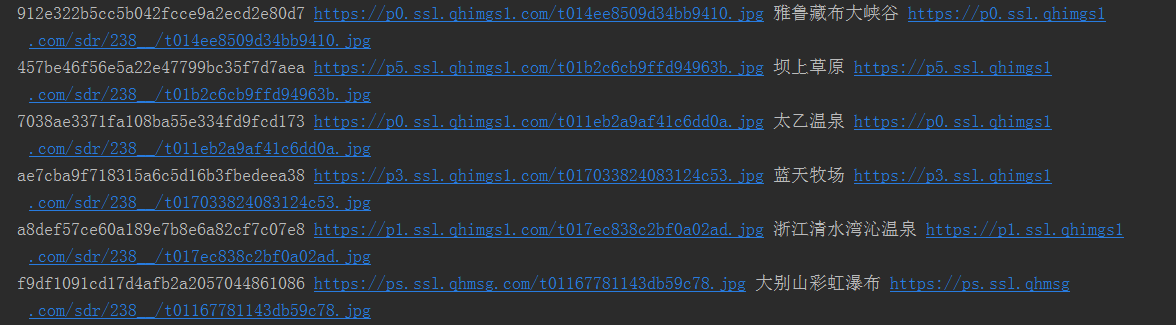
最后,我们已经将360图片的信息已经抓取下来了并打印在的控制台当中。但是我们需要把数据给下载下来,并且进行存储,所以在下一节当中会对item.py文件进行讲解。
第十六节:Scrapy爬虫框架之项目创建spider文件数据爬取的更多相关文章
- 第三百一十六节,Django框架,中间件
第三百一十六节,Django框架,中间件 django 中的中间件(middleware),在django中,中间件其实就是一个类,在请求到来和结束后,django会根据自己的规则在合适的时机执行中间 ...
- scrapy爬虫成长日记之创建工程-抽取数据-保存为json格式的数据
在安装完scrapy以后,相信大家都会跃跃欲试想定制一个自己的爬虫吧?我也不例外,下面详细记录一下定制一个scrapy工程都需要哪些步骤.如果你还没有安装好scrapy,又或者为scrapy的安装感到 ...
- 第二百六十六节,Tornado框架-XSS处理,页码计算,页码显示
Tornado框架-XSS处理,页码计算,页码显示 Tornado框架-XSS攻击过滤 注意:Tornado框架的模板语言,读取数据已经自动处理了XSS攻击,过滤转换了危险字符 如果要使危险字符可以远 ...
- 创建一个scrapy爬虫框架的项目
第一步:打开pycharm,选择"terminal",如图所示: 第二步:在命令中端输入创建scrapy项目的命令:scrapy startproject demo (demo指的 ...
- Scrapy爬虫框架(2)--内置py文件
Scrapy概念图 这里有很多py文件,分别与Scrapy的各个模块对应 superspider是一个爬虫项目 spider1.py则是一个创建好的爬虫文件,爬取资源返回url和数据 items.py ...
- 【php爬虫】百万级别知乎用户数据爬取与分析
代码托管地址:https://github.com/hoohack/zhihuSpider 这次抓取了110万的用户数据,数据分析结果如下: 开发前的准备 安装Linux系统(Ubuntu14.04) ...
- Python爬虫入门教程 3-100 美空网数据爬取
美空网数据----简介 从今天开始,我们尝试用2篇博客的内容量,搞定一个网站叫做"美空网"网址为:http://www.moko.cc/, 这个网站我分析了一下,我们要爬取的图片在 ...
- 第十七节:Scrapy爬虫框架之item.py文件以及spider中使用item
Scrapy原理图: item位于原理图的最左边 item.py文件是报存爬取数据的容器,他使用的方法和字典很相似,但是相比字典item多了额外的保护机制,可以避免拼写错误或者定义错误. 1.创建it ...
- 第二百五十六节,Web框架
Web框架 Web框架本质 众所周知,对于所有的Web应用,本质上其实就是一个socket服务端,用户的浏览器其实就是一个socket客户端. 举例: #!/usr/bin/env python #c ...
随机推荐
- Android项目通过Android Debug Database实时查看本地Sqlite数据库内容
前几天写Android项目时,想和Sqlyog那样图形化查看数据库中的文件,由于Android自带小型的Sqlite轻量级数据库,在查找方法时发现了一个特别简单适用的方法,纪录一下. 在android ...
- Java之简单的四则运算
简单的四则运算 请你编写程序实现能处理两个数的+.-.*./.%的表达式程序.数据的输入/输出全部使用标准输入/输出,输入数据的第一行为你需要计算表达式的个数,从第2行开始,每一行为你计算的一个表达式 ...
- [2010国家集训队]Crash的旅游计划
Description 眼看着假期就要到了,Crash由于长期切题而感到无聊了,因此他决定利用这个假期和好友陶陶一起出去旅游. Crash和陶陶所要去的城市里有N (N > 1) 个景点,Cra ...
- [CF1076F] Summer Practice Report
Description Transmission Gate Solution 这一题可以考虑Dp,设\(Dp[i][j]\) 为在第i段中,以j颜色为结尾的最后一小段长度的最小值. 那么可以先考虑以表 ...
- UOJ228 简单数据结构练习题
Description 传送门 维护一个数列, 有以下操作: 对[l,r]同时加上x 把[l,r]开根后下取整. 查询[l,r]之和 n,m \(\leq\)$ 100000, $\(a_i,x \l ...
- [USACO 2012 Mar Silver] Landscaping【Edit Distance】
传送门:http://www.usaco.org/index.php?page=viewproblem2&cpid=126 好题啊好题,一开始就输给了这道题的想法! 先把原始状态以及目标状态换 ...
- Monkey Banana Problem LightOJ - 1004
Monkey Banana Problem LightOJ - 1004 错误记录: 1.数组开小2.每组数据数组没有清空 #include<cstdio> #include<cst ...
- 题解报告:hdu 1166 敌兵布阵(线段树or树状数组)
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=1166 Problem Description C国的死对头A国这段时间正在进行军事演习,所以C国间谍头 ...
- Docker安装jenkins(六)
这里是在linux环境下安装docker之后,在doucer内安装jenkins --------------------docker 安装 jenkins---------------------- ...
- Visual Studio 2013 错误系统找不到指定文件,0x80070002
错误:Visual Studio 2013 按照成功后,可以创建空web项目,但不能建webform 和 mvc 项目. 提示系统找不到指定文件,0x80070002. 解决方式: Step1: Wi ...