
Kafka 温故(五):Kafka的消费编程模型
Kafka的消费模型分为两种:
1.分区消费模型
2.分组消费模型
一.分区消费模型
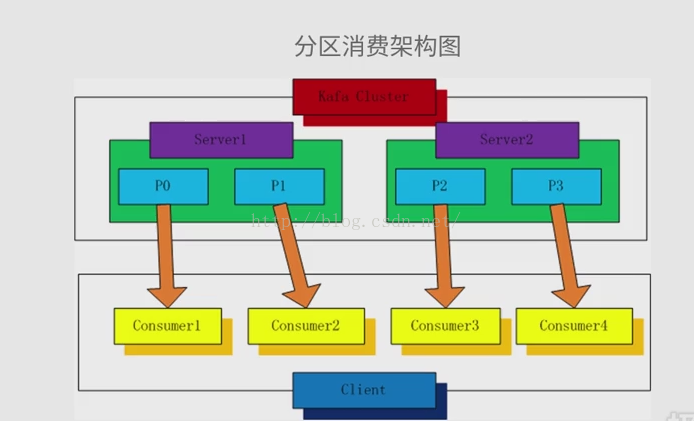
二、分组消费模型

Producer :
package cn.outofmemory.kafka;

import java.util.Properties;

import kafka.javaapi.producer.Producer;

import kafka.producer.KeyedMessage;

import kafka.producer.ProducerConfig;

/**

 * Hello world!

 *

 */

public class KafkaProducer

{

    private final Producer<String, String> producer;

    public final static String TOPIC = "TEST-TOPIC";

    private KafkaProducer(){

        Properties props = new Properties();

        //此处配置的是kafka的端口

        props.put("metadata.broker.list", "192.168.193.148:9092");

        //配置value的序列化类

        props.put("serializer.class", "kafka.serializer.StringEncoder");

        //配置key的序列化类

        props.put("key.serializer.class", "kafka.serializer.StringEncoder");

        //request.required.acks

        //0, which means that the producer never waits for an acknowledgement from the broker (the same behavior as 0.7). This option provides the lowest latency but the weakest durability guarantees (some data will be lost when a server fails).

        //1, which means that the producer gets an acknowledgement after the leader replica has received the data. This option provides better durability as the client waits until the server acknowledges the request as successful (only messages that were written to the now-dead leader but not yet replicated will be lost).

        //-1, which means that the producer gets an acknowledgement after all in-sync replicas have received the data. This option provides the best durability, we guarantee that no messages will be lost as long as at least one in sync replica remains.

        props.put("request.required.acks","-1");

        producer = new Producer<String, String>(new ProducerConfig(props));

    }

    void produce() {

        int messageNo = 1000;

        final int COUNT = 10000;

        while (messageNo < COUNT) {

            String key = String.valueOf(messageNo);

            String data = "hello kafka message " + key;

            producer.send(new KeyedMessage<String, String>(TOPIC, key ,data));

            System.out.println(data);

            messageNo ++;

        }

    }

    public static void main( String[] args )

    {

        new KafkaProducer().produce();

    }

}
Consumer
package cn.outofmemory.kafka;

import java.util.HashMap;

import java.util.List;

import java.util.Map;

import java.util.Properties;

import kafka.consumer.ConsumerConfig;

import kafka.consumer.ConsumerIterator;

import kafka.consumer.KafkaStream;

import kafka.javaapi.consumer.ConsumerConnector;

import kafka.serializer.StringDecoder;

import kafka.utils.VerifiableProperties;

public class KafkaConsumer {

    private final ConsumerConnector consumer;

    private KafkaConsumer() {

        Properties props = new Properties();

        //zookeeper 配置

        props.put("zookeeper.connect", "192.168.193.148:2181");

        //group 代表一个消费组

        props.put("group.id", "jd-group");

        //zk连接超时

        props.put("zookeeper.session.timeout.ms", "4000");

        props.put("zookeeper.sync.time.ms", "200");

        props.put("auto.commit.interval.ms", "1000");

        props.put("auto.offset.reset", "smallest");

        //序列化类

        props.put("serializer.class", "kafka.serializer.StringEncoder");

        ConsumerConfig config = new ConsumerConfig(props);

        consumer = kafka.consumer.Consumer.createJavaConsumerConnector(config);

    }

    void consume() {

        Map<String, Integer> topicCountMap = new HashMap<String, Integer>();

        topicCountMap.put(KafkaProducer.TOPIC, new Integer(1));

        StringDecoder keyDecoder = new StringDecoder(new VerifiableProperties());

        StringDecoder valueDecoder = new StringDecoder(new VerifiableProperties());

        //获取到的输入流

        Map<String, List<KafkaStream<String, String>>> consumerMap =

                consumer.createMessageStreams(topicCountMap,keyDecoder,valueDecoder);

        KafkaStream<String, String> stream = consumerMap.get(KafkaProducer.TOPIC).get(0);

        ConsumerIterator<String, String> it = stream.iterator();

        //输出接受到的消息

        while (it.hasNext())

            System.out.println(it.next().message());

    }

    public static void main(String[] args) {

        new KafkaConsumer().consume();

    }

}
kafka 学习告一段落,后面进入的为Spring 温习。
Kafka 温故(五):Kafka的消费编程模型的更多相关文章
- Kafka 温故(二):Kafka的基本概念和结构
一.Kafka中的核心概念 Producer: 特指消息的生产者Consumer :特指消息的消费者Consumer Group :消费者组,可以并行消费Topic中partition的消息Broke ...
- Storm集成Kafka编程模型
原创文章,转载请注明: 转载自http://www.cnblogs.com/tovin/p/3974417.html 本文主要介绍如何在Storm编程实现与Kafka的集成 一.实现模型 数据流程: ...
- Kafka 通过python简单的生产消费实现
使用CentOS6.5.python3.6.kafkaScala 2.10 - kafka_2.10-0.8.2.2.tgz (asc, md5) 一.下载kafka 下载地址 https://ka ...
- kafka的编程模型
1.kafka消费者编程模型 分区消费模型 组(group)消费模型 1.1.1.分区消费架构图,每个分区对应一个消费者. 1.1.2.分区消费模型伪代码描述 指定偏移量,用于从上次消费的地方开始消费 ...
- kafka架构,消息存储和生成消费模型,Kafka与其他队列对比,零拷贝,Kafka基本介绍
kafka架构,消息存储和生成消费模型,Kafka与其他队列对比,零拷贝,Kafka基本介绍 一.初识kafka 1.1SparkStreaming+Kafka好处: 1.2Kafka的架构: 二.k ...
- Kafka具体解释五、Kafka Consumer的底层API- SimpleConsumer
1.Kafka提供了两套API给Consumer The high-level Consumer API The SimpleConsumer API 第一种高度抽象的Consumer API,它使用 ...
- Kafka详解五:Kafka Consumer的底层API- SimpleConsumer
问题导读 1.Kafka如何实现和Consumer之间的交互?2.使用SimpleConsumer有哪些弊端呢? 1.Kafka提供了两套API给Consumer The high-level Con ...
- Kafka创建&查看topic,生产&消费指定topic消息
启动zookeeper和Kafka之后,进入kafka目录(安装/启动kafka参考前面一章:https://www.cnblogs.com/cici20166/p/9425613.html) 1.创 ...
- kafka创建topic,生产和消费指定topic消息
启动zookeeper和Kafka之后,进入kafka目录(安装/启动kafka参考前面一章:https://www.cnblogs.com/cici20166/p/9425613.html) 1.创 ...
随机推荐
- 【源码】进入ASP.NET MVC流程的大门 - UrlRoutingModule
UrlRoutingModule的功能 在ASP.NET MVC的请求过程中,UrlRoutingModule的作用是拦截当前的请求URL,通过URL来解析出RouteData,为后续的一系列流程提供 ...
- 使用ClosedXML,读取到空行
最近项目中使用了ClosedXML.dll来处理Excel,在读取Excel的时候,用workSheet.Rows()获取Excel行数,默认读取Excel最大行数1048576 所以为了读取到不是空 ...
- jquery自动获取项目url路径
//很多时候我们需要使用当前项目路径,但是如果把项目路径写死,会带来很多不便,此时就需要自动获取项目路径.//我们可以根据jquery来进行自动获取项目路径,获取方法如下function getRoo ...
- ecCodes 学习 利用ecCodes fortran90 api对GRIB文件进行读写
参考 https://www.ecmwf.int/assets/elearning/eccodes/eccodes2/story_html5.htmlhttps://confluence.ecmwf. ...
- PS官方正式中文版(搬砖分享)
https://pan.baidu.com/s/1c3IdQq0 PS官方正式中文版(搬砖分享) 注意事项: 1.安装开始前请先断网,在成功破解激活前请全程断网: 2.安装完成后先试运行软件一次,然后 ...
- babel的使用(关于使用async报错的问题)
一.配置文件.babelrc .babelrc 文件存放在项目的根目录下. { "presets": [], "plugins": [] } presets 字 ...
- 《Linux内核分析》课程第一周学习总结
姓名:何伟钦 学号:20135223 ( *原创作品转载请注明出处*) ( 学习课程:<Linux内核分析>MOOC课程http://mooc.study.163.com/course/U ...
- Sprint第二个计划
一.现状 现在是冲刺的第二个阶段了,我们的进度还是一样,没有太大的进展.所以这一个阶段应该加紧进度,好好学习别的组,弥补我们组的不足.一开始我们是打算用原来的初级APP,然后再补充一些新的内容.可是现 ...
- 使用不同的namespace让不同的kafka/Storm连接同一个zookeeper
背景介绍: 需要部署2个kafka独立环境,但是只有一个zookeeper集群. 需要部署2个独立的storm环境,但是只有一个zookeeper集群. ----------------------- ...
- Linux命令(二十六) 用户管理命令
一.添加用户 useradd useradd 命令用于创建新用户,格式为useradd [选项] 用户名. 可以使用 useradd 命令创建用户帐户,使用该命令创建账户时,默认的用户目录在 /hom ...