
AI论文解读:基于Transformer的多目标跟踪方法TrackFormer
摘要:多目标跟踪这个具有挑战性的任务需要同时完成跟踪目标的初始化、定位并构建时空上的跟踪轨迹。本文将这个任务构建为一个帧到帧的集合预测问题,并提出了一个基于transformer的端到端的多目标跟踪方法TrackFormer。
本文分享自华为云社区《论文解读系列十四:基于transformer的多目标跟踪方法TrackFormer详细解读》,原文作者:谷雨润一麦 。
多目标跟踪这个具有挑战性的任务需要同时完成跟踪目标的初始化、定位并构建时空上的跟踪轨迹。本文将这个任务构建为一个帧到帧的集合预测问题,并提出了一个基于transformer的端到端的多目标跟踪方法TrackFormer。本文模型通过注意力机制实现了帧与帧之间的数据关联,完成了视频序列间的跟踪轨迹的预测。Transformer的解码器同时从静态的目标查询中初始化新的目标和从跟踪查询中跟踪已有的跟踪轨迹并对位置进行更新,两种类型的查询都可以同时从self-attention和encoder-decoder的注意力中关注到全局的帧级特征。因此可以省略掉额外的图优化和匹配的过程,也不需要对运动和外貌特征进行建模。
1. Motivation
多目标跟踪任务需要跟踪一系列目标的轨迹,当目标在视频序列中移动时可以保持各自具有区分性的跟踪id。现有的tracking-by-detection的方法一般都包含两个步骤(1)检测单独视频帧中目标(2)对帧与帧之间的检测目标进行关联,从而形成每个目标的跟踪轨迹。传统的基于tracking-by-detection的方法的数据关联一般都需要图优化或者利用卷积神经网络预测目标间的分数的方式。本文提出了一个新的跟踪范式tracking-by-attention,该方法将多目标跟踪任务建模为一个集合预测问题,通过提出的TrackFormer网络实现了端到端的可训练的在线多目标跟踪网络。该网络利用encoder对来自卷积网络的图像特征进行编码,然后通过decoder将查询向量解码为包围框和对应的身份id,其中的跟踪查询用来做帧与帧之间的数据关联。
2. 网络结构
本文提出的TrackFormer是一个基于transformer的端到端多目标跟踪方法,它将多目标跟踪任务建模为一个集合预测问题,并引出了tracking-by-attention这种新的范式。下面将从整体流程、跟踪过程和网络损失函数三个方面分别对网络进行介绍。
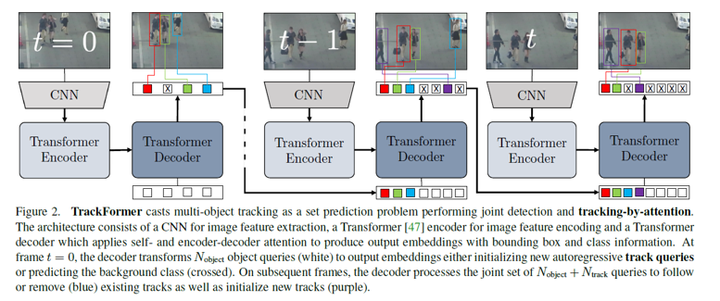
图一 trackformer训练流程图
2.1 基于集合预测的多目标任务
给定具有K个不同identity的目标的视频序列,多目标跟踪任务需要生成包括包围框和身份id(k)的跟踪轨迹
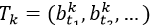
总帧数T 的子集(t1,t2,…)记录了目标从进入到离开场景的时间序列。
为了将MOT(多目标跟踪任务)建模为序列预测问题,本文利用了transformer的编码器-解码器结构。文本模型通过下面四个步骤完成在线的跟踪并同时输出每一帧目标的边界框、类别以及身份id:
1)通过通用的卷积神经网络backbone提取帧级的特征,例如ResNet
2)通过transformer的编码器的self-attention模块完成帧级特征编码
3)通过transformer的解码器的self-和cross-attention完成对查询实体的解码
4)通过多层感知机对解码器输出进行映射完成边界框和类别的预测
其中解码器的注意力机制一共分为两种(1)所有查询向量上的self-attention,可以用来响应场景中的所有目标;(2)编码器和解码器之间的注意力,可以获取到当前帧的全局视觉信息。另外,因为transformer具有排列不变性,需要分别给特征输入和解码查询实体添加额外的位置编码和目标编码。
2.2 基于解码器查询向量的跟踪过程
Transformer的解码器查询向量一共有两种初始化方式(1)静态目标查询向量,帮助模型在任意帧初始化跟踪目标(2)自回归跟踪查询向量,负责在帧与帧之间跟踪目标。Transformer同时对目标和跟踪查询进行解码可以以一种统一方式的实现检测和跟踪,因此引入了一种tracking-by-attention的模式。详细的网络结构如下图所示:
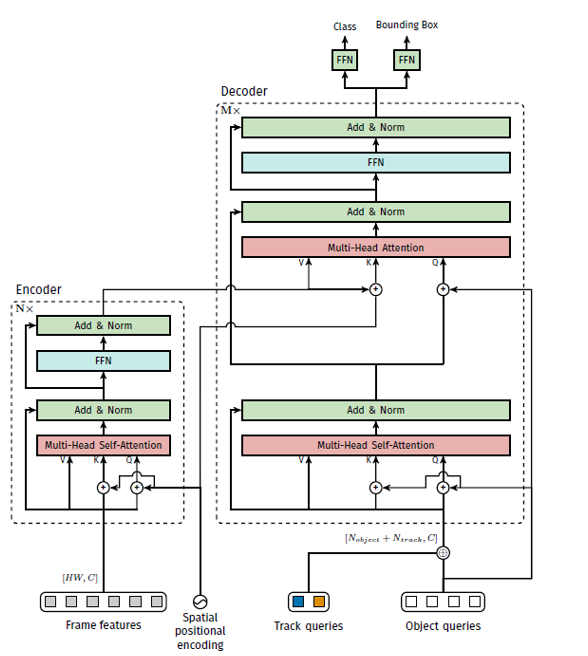
图二 trackformer网络结构
2.2.1 跟踪初始化
场景中新出现的目标都是通过固定数量(Nobject)的目标查询向量进行检测的,这Nobject个目标向量在网络训练过程中会不断学习从而可以实现场景中的所有目标编码,然后通过transformer的解码器的解码完成新目标类别和位置信息的预测,从而实现了跟踪的初始化。
2.2.2跟踪查询
为了实现帧与帧之间的跟踪,本文在解码过程中提出了“跟踪查询”这个概念。跟踪查询会在视频序列中不断跟踪目标,在携带者身份信息的同时还通过自回归的方式自适应的调整目标的位置预测。为了实现这个目标,在解码过程中会用上一帧对应的输出embedding来初始化检测的跟踪查询向量,然后在解码过程中通过encoder和decoder建立当前帧和查询向量之间注意力关系,从而完成了跟踪查询中各个实例的身份和位置的更新。
跟踪查询向量如图一中的颜色方块所示,上一帧的transformer输出embedding会被用来初始化当前帧的查询向量,通过和当前帧特征进行查询,完整帧与帧之间的目标跟踪。
2.3 网络训练及损失函数
因为查询跟踪需要跟踪下一帧的目标并和目标查询交互一起工作,TrackFormer需要专门的帧与帧之间的跟踪训练。如图一所示,本文通过同时训练紧邻的两帧来完成跟踪训练,并一起优化所有的多目标跟踪目标函数。集合预测损失度量了每一帧的所有输出
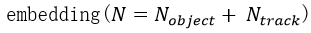
的类别和边界框预测与真实目标之间的相似性,集合预测损失一共可以分为两部分计算:
1)上一帧(t-1)的 Nobject 个目标查询的loss
2)从上一步得到得到的跟踪目标和当前帧(t)的新的检测目标总共N个查询的loss
因为transformer的输出是无序的,因此在计算集合预测损失之前需要先完成输出embedding和真实标签之间的匹配问题。这个匹配可以同时通过跟踪id和包围框以及类别之间的相似性来完成,首先考虑跟踪id的情况,我们用 Kt-1 表示t-1帧的跟踪id集合,用 Kt 表示当前帧t的跟踪id集合,通过这两个跟踪集合可以完成Ntrack跟踪查询和真实标签的硬匹配。两个集合的匹配一共可以分为三种情况:(1)kt-1 和 kt 的交集,这个可以用来直接给跟踪查询embedding匹配对应的真实标签(2)kt-1 中出现 kt 中没有的,直接舍匹配背景标签(3)kt 和 kt-1中有中不存在的在,这一部分是新的目标,需要用匈牙利算法对目标查询和真实标签的包围框和类别进行优化匹配得到最小损失的匹配结果。匹配过程如下公式所示:
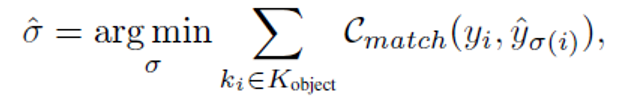
σ为gt到目标查询(Nobject)的映射关系,优化目标就是让匹配损失最小,匹配损失同时包括了类别损失和包围框损失如下所示:
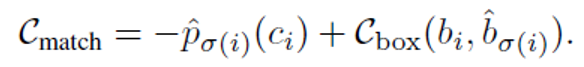
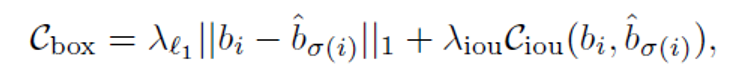
得到匹配结果后,最后就可以计算集合预测损失,同时包括了跟踪和目标查询输出的损失,计算方法如下:
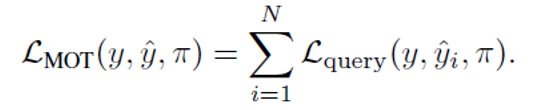
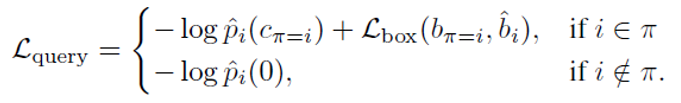
∏是通过跟踪id和匈牙利算法得到的输出与真值之间的匹配结果。
3. 实验结果
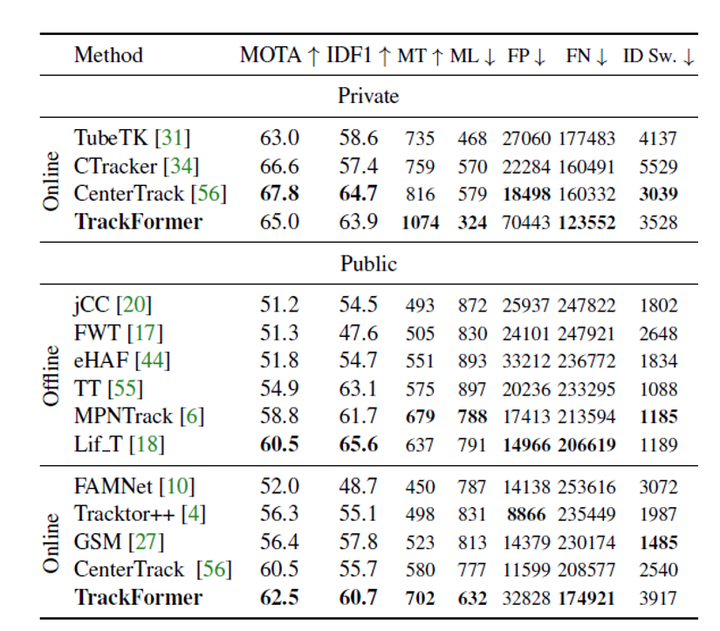
表3-1 MOT17上的跟踪结果
从表3-1的结果可以看出,在私有检测器上的跟踪结果仍有一定差距,这主要是因为基于transformer的检测器效果没有现在SOTA的方法好,但当采用共有检测器时,在线上跟踪的情况下无论是在MOTP和IDF1都有明显的提升。
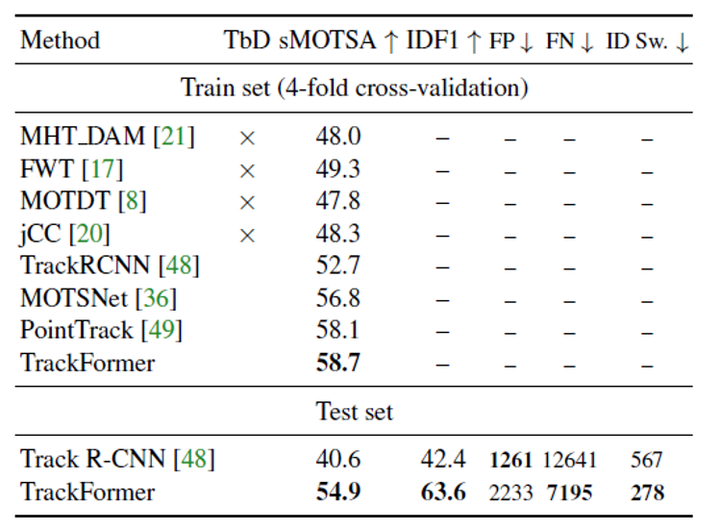
表3-2 MOTS20上的跟踪结果
除了目标检测和跟踪之外,TrackFormer还可以预测实例水平的分割图。从表3-2可以看出无论是在交叉验证结果上还是测试集上,TrackFormer都要优于现有的SOTA方法。
AI论文解读:基于Transformer的多目标跟踪方法TrackFormer的更多相关文章
- 医学AI论文解读 |Circulation|2018| 超声心动图的全自动检测在临床上的应用
文章来自微信公众号:机器学习炼丹术.号主炼丹兄WX:cyx645016617.文章有问题或者想交流的话欢迎- 参考目录: @ 目录 0 论文 1 概述 2 pipeline 3 技术细节 3.1 预处 ...
- AAAI2019 | 基于区域分解集成的目标检测 论文解读
Object Detection based on Region Decomposition and Assembly AAAI2019 | 基于区域分解集成的目标检测 论文解读 作者 | 文永亮 学 ...
- 论文解读丨基于局部特征保留的图卷积神经网络架构(LPD-GCN)
摘要:本文提出一种基于局部特征保留的图卷积网络架构,与最新的对比算法相比,该方法在多个数据集上的图分类性能得到大幅度提升,泛化性能也得到了改善. 本文分享自华为云社区<论文解读:基于局部特征保留 ...
- 带你读AI论文丨LaneNet基于实体分割的端到端车道线检测
摘要:LaneNet是一种端到端的车道线检测方法,包含 LanNet + H-Net 两个网络模型. 本文分享自华为云社区<[论文解读]LaneNet基于实体分割的端到端车道线检测>,作者 ...
- 解读ICDE'22论文:基于鲁棒和可解释自编码器的无监督时间序列离群点检测算法
摘要:本文提出了两个用于无监督的具备可解释性和鲁棒性时间序列离群点检测的自动编码器框架. 本文分享自华为云社区<解读ICDE'22论文:基于鲁棒和可解释自编码器的无监督时间序列离群点检测算法&g ...
- 论文解读(XR-Transformer)Fast Multi-Resolution Transformer Fine-tuning for Extreme Multi-label Text Classification
Paper Information Title:Fast Multi-Resolution Transformer Fine-tuning for Extreme Multi-label Text C ...
- 带你读AI论文丨针对文字识别的多模态半监督方法
摘要:本文提出了一种针对文字识别的多模态半监督方法,具体来说,作者首先使用teacher-student网络进行半监督学习,然后在视觉.语义以及视觉和语义的融合特征上,都进行了一致性约束. 本文分享自 ...
- THFuse: An infrared and visible image fusion network using transformer and hybrid feature extractor 论文解读
THFuse: An infrared and visible image fusion network using transformer and hybrid feature extractor ...
- [论文解读] 阿里DIEN整体代码结构
[论文解读] 阿里DIEN整体代码结构 目录 [论文解读] 阿里DIEN整体代码结构 0x00 摘要 0x01 文件简介 0x02 总体架构 0x03 总体代码 0x04 模型基类 4.1 基本逻辑 ...
- 浅谈分词算法(5)基于字的分词方法(bi-LSTM)
目录 前言 目录 循环神经网络 基于LSTM的分词 Embedding 数据预处理 模型 如何添加用户词典 前言 很早便规划的浅谈分词算法,总共分为了五个部分,想聊聊自己在各种场景中使用到的分词方法做 ...
随机推荐
- 栩栩如生,音色克隆,Bert-vits2文字转语音打造鬼畜视频实践(Python3.10)
诸公可知目前最牛逼的TTS免费开源项目是哪一个?没错,是Bert-vits2,没有之一.它是在本来已经极其强大的Vits项目中融入了Bert大模型,基本上解决了VITS的语气韵律问题,在效果非常出色的 ...
- OpenGL 着色器详解
1. GLSL语言 glsl语言是用来编写着色器的,通过一段一段包含main函数的程序片段,告诉渲染引擎怎么去渲染内容. glsl语言的语法有点类似c语言风格,只是增加了一些特有的关键字来修饰变量,下 ...
- [Python急救站课程]Hello Kitty的绘制
我女朋友喜欢Hello Kitty,当她知道我会用Python画图,让我给画一个,怎么说呢,当然要安排上啦!请看程序 import math import turtle as t # 计算长度.角度 ...
- animate.css 动画种类(详细)
作者:WangMin 格言:努力做好自己喜欢的每一件事 以下为各种动画类型包含的不同动画效果类,仅供参考.具体可查看animate.css 官网. bounce 弹跳 2. flash 闪烁 3. p ...
- 历时三年,写的一本数据结构与算法pdf,开源了!
前言 大家好,我是bigsai,很早就在写博客,将文章整理成了一个pdf,并且开源到github上! 自己写东西断断续续也不少时间了,也写了不少东西(虽然是偏向小白),这个其实花费的时间还是比较多的, ...
- 本地训练,开箱可用,Bert-VITS2 V2.0.2版本本地基于现有数据集训练(原神刻晴)
按照固有思维方式,深度学习的训练环节应该在云端,毕竟本地硬件条件有限.但事实上,在语音识别和自然语言处理层面,即使相对较少的数据量也可以训练出高性能的模型,对于预算有限的同学们来说,也没必要花冤枉钱上 ...
- SpringBoot + 通义千问 + 自定义React组件,支持EventStream数据解析!
一.前言 大家好!我是sum墨,一个一线的底层码农,平时喜欢研究和思考一些技术相关的问题并整理成文,限于本人水平,如果文章和代码有表述不当之处,还请不吝赐教. 最近ChatGPT非常受欢迎,尤其是在编 ...
- 逻辑回归(Logistic Regression) ----转载
概要: 1. 介绍Logistic Regression的数学模型,推导并详细解释求解最优回归系数的过程:2. Python实现Logistic Regression的基本版:3. 介绍sklearn ...
- java.util.List如何用
起因是这样,我在学习Javaweb,然后就突然有很多类似的语句 这是什么意思呢?让我们一起来解决看看吧! List有序集合(也成为序列),用户可以精确控制列表中每个元素的插入位置.用户可以通过整数索引 ...
- jmeter-json断言
1.JSON 断言所在位置:断言->JSON 断言 2.JSON断言中的字段解析 Assert JSON Path exists:json 表达式,判断所字段是否存在,存在则为True, 否则为 ...