
如何成功将 API 客户的 transformer 模型推理速度加快 100 倍
Transformers 已成为世界各地数据科学家用以探索最先进 NLP 模型、构建新 NLP 模块的默认库。它拥有超过 5000 个预训练和微调的模型,支持 250 多种语言,任君取用。无论你使用哪种框架,都能用得上它。
虽然在 Transformers 中试验模型很容易,但以最高性能将这些大模型部署到生产中,并将它们用可扩展的架构管理起来,对于任何机器学习工程师来说都是一个 艰巨的工程挑战。
100 倍性能提升及内置可扩展性是用户选择在我们托管的 Accelerated Inference API 基础上构建自己的 NLP 模块的原因。尤其是为了实现 最后那 10 倍性能 提升,我们需要进行底层的、特定于模型且特定于目标硬件的优化。
本文分享了我们为用户充分榨干每一滴计算资源所使用的一些方法。
获取首个 10 倍加速
优化之旅的第一站相对来讲是最容易的,主要涉及到 Hugging Face 库 提供的所有平台无关的优化技术。
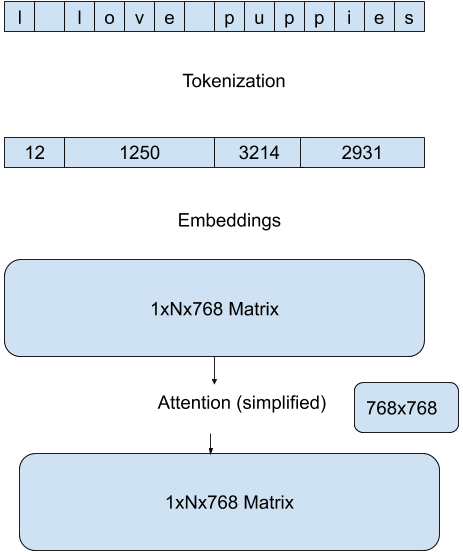
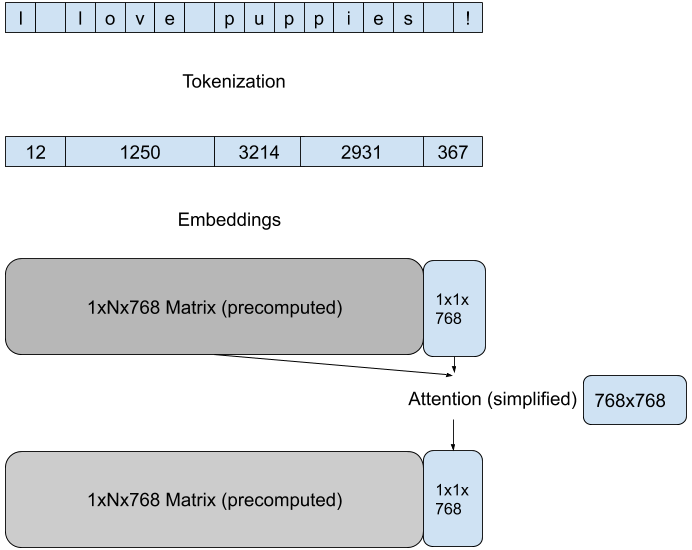
我们在 Hugging Face 模型的 流水线 (pipeline ) 中集成了能有效减少每次前向传播计算量的最佳方法。这些方法因模型架构和目标任务不同而不同,例如,对基于 GPT 架构的模型的文本生成任务,我们通过缓存过去时刻的注意力矩阵,而仅计算每一轮中最后一个新词元的注意力,来减小参与计算的注意力矩阵的维度:
| - | 原始版 | 优化版 |
|---|---|---|
| - |  |
 |
分词常常成为推理效率的瓶颈。我们在 Tokenizers 库中实现了高效的算法,用 Rust 来实现模型分词器并与智能缓存技术相结合,获得了高达 10 倍的端到端延迟加速。
利用 Hugging Face 库的最新功能,在相同的模型及硬件上,与开箱即用的部署相比,我们稳定达到了 10 倍加速。由于 Transformer 和 Tokenizer 通常每月都会发版,因此我们的 API 客户无需不断适配新的优化,即可让自己的模型越跑越快。
为了胜利而编译: 10 倍加速硬核技术
现在到真正棘手的地方了。为了获得最佳性能,我们需要修改模型并针对特定硬件进行编译以优化推理速度。选择什么硬件取决于模型 (内存大小) 和需求情况 (对请求进行组批)。即使是使用相同的模型来进行预测,一些 API 客户可能会更受益于 CPU 推理加速,而其他客户可能会更受益于 GPU 推理加速,而每种硬件会涉及不同的优化技术以及库。
一旦为针对应用场景选定计算平台,我们就可以开始工作了。以下是一些可应用于静态图的针对 CPU 的优化技术:
- 图优化 (删除无用节点和边)
- 层融合 (使用特定的 CPU 算子)
- 量化
使用开源库中的开箱即用功能 (例如 Transformers 结合 ONNX Runtime) 很难得到最佳的结果,或者会有明显的准确率损失,特别是在使用量化方法时。没有什么灵丹妙药,每个模型架构的最佳优化方案都不同。但深入研究 Transformers 代码和 ONNX Runtime 文档,星图即会显现,我们就能够组合出适合目标模型和硬件的额外的 10 倍加速方案。
不公平的优势
从 NLP 起家的 Transformer 架构是机器学习性能的决定性转折点,在过去 3 年中,自然语言理解和生成的进展急剧加快,同时水涨船高的是模型的平均大小,从 BERT 的 110M 参数到现在 GPT-3 的 175B 参数。
这种趋势给机器学习工程师将最新模型部署到生产中带来了严峻的挑战。虽然 100 倍加速是一个很高的标准,但惟有这样才能满足消费级应用对实时性的需求。
为了达到这个标准,作为 Hugging Face 的机器学习工程师,我们与 Transformers 和 Tokenizers 维护人员 相邻而坐,相对其他机器学习工程师而言当然拥有不公平的优势。更幸运的是,通过与英特尔、英伟达、高通、亚马逊和微软等硬件及云供应商的开源合作建立起的广泛合作伙伴关系,我们还能够使用最新的硬件优化技术来优化我们的模型及基础设施。
如果你想感受我们基础设施的速度,可以 免费试用 一下,我们也会与你联系。
如果你想在自己的基础设施实施我们的推理优化,请加入我们的 专家加速计划。
英文原文: https://hf.co/blog/accelerated-inference
原文作者: Hugging Face
译者: Matrix Yao (姚伟峰),英特尔深度学习工程师,工作方向为 transformer-family 模型在各模态数据上的应用及大规模模型的训练推理。
审校/排版: zhongdongy (阿东)
如何成功将 API 客户的 transformer 模型推理速度加快 100 倍的更多相关文章
- Tensorflow object detection API 搭建物体识别模型(四)
四.模型测试 1)下载文件 在已经阅读并且实践过前3篇文章的情况下,读者会有一些文件夹.因为每个读者的实际操作不同,则文件夹中的内容不同.为了保持本篇文章的独立性,制作了可以独立运行的文件夹目标检测. ...
- Tensorflow object detection API 搭建物体识别模型(一)
一.开发环境 1)python3.5 2)tensorflow1.12.0 3)Tensorflow object detection API :https://github.com/tensorfl ...
- Tensorflow object detection API 搭建物体识别模型(二)
二.数据准备 1)下载图片 图片来源于ImageNet中的鲤鱼分类,下载地址:https://pan.baidu.com/s/1Ry0ywIXVInGxeHi3uu608g 提取码: wib3 在桌面 ...
- Transformer模型总结
Transformer改进了RNN最被人诟病的训练慢的缺点,利用self-attention机制实现快速并行. 它是由编码组件.解码组件和它们之间的连接组成. 编码组件部分由一堆编码器(6个 enco ...
- 大规模 Transformer 模型 8 比特矩阵乘简介 - 基于 Hugging Face Transformers、Accelerate 以及 bitsandbytes
引言 语言模型一直在变大.截至撰写本文时,PaLM 有 5400 亿参数,OPT.GPT-3 和 BLOOM 有大约 1760 亿参数,而且我们仍在继续朝着更大的模型发展.下图总结了最近的一些语言模型 ...
- 细说 Web API参数绑定和模型绑定
今天跟大家分享下在Asp.NET Web API中Controller是如何解析从客户端传递过来的数据,然后赋值给Controller的参数的,也就是参数绑定和模型绑定. Web API参数绑定就是简 ...
- 文本分类实战(八)—— Transformer模型
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- 详解Transformer模型(Atention is all you need)
1 概述 在介绍Transformer模型之前,先来回顾Encoder-Decoder中的Attention.其实质上就是Encoder中隐层输出的加权和,公式如下: 将Attention机制从Enc ...
- Tensorflow object detection API 搭建物体识别模型(三)
三.模型训练 1)错误一: 在桌面的目标检测文件夹中打开cmd,即在路径中输入cmd后按Enter键运行.在cmd中运行命令: python /your_path/models-master/rese ...
- 客户续费模型 逻辑回归 分类器 AdaBoost
客户续费模型 逻辑回归 分类器 AdaBoost
随机推荐
- 【爬虫+数据清洗+可视化】用Python分析“淄博烧烤“的评论数据
目录 一.背景介绍 二.爬虫代码 2.1 展示爬取结果 2.2 爬虫代码讲解 三.可视化代码 3.1 读取数据 3.2 数据清洗 3.3 可视化 3.3.1 IP属地分析-柱形图 3.3.2 评论时间 ...
- HyperPlatform
之前也写过一个vt的框架,但是比较简单,写的比较乱迁移什么的比较麻烦,于是阅读下HyperPlatform的源码学习下. 本文只对主体框架分析. vt的流程大概如下 1:检测是否支持VT. 2:vmx ...
- 如何基于G6进行双树流转绘制?
1. 背景 业务背景:CRM系统随着各业务条线对线索精细化分配的诉求逐渐增加,各个条线的流向规则会越来越复杂,各个条线甚至整个CRM的线索流转规则急需一种树形的可视化的图来表达. 技术背景:在开发之前 ...
- ShowMeBug 持续升级,提供高信效度支撑的技术招聘方案
去年年底,全新升级版的 ShowMeBug --一款支持实战编程的技术能力评估平台,首次揭开了它神秘的面纱. 而近日,ShowMeBug 再次迎来一系列产品更新,它将以全新的面貌,提供高信效度支撑的技 ...
- 【python基础】复杂数据类型-字典(增删改查)
1.初识字典 字典,是另外一种复杂的数据类型,相较于列表,字典可以将相关信息关联起来.比如说一个人的信息有名字.年龄.性别等,如果用列表存储的话,不能表示他们之间是相关联的,而字典可以,字典是一个或多 ...
- unity添加Mysql的dll以及发布的问题
最近在做一个unity项目中,要读取数据库,还是MySql的数据库.遇到了很多问题,写出来供大家参考一下. 关于unity引用第三方的Mysql.data.dll的问题: 这个地方有一个难点,正常的C ...
- 基于Elasticsearch 为电商提供商品数据大数据查询
基于Elasticsearch 为电商提供商品数据大数据查询 前言 对于现代电商的产品,维度的多员花,与一套强大的搜索引擎,那是非常必要的.今天我们主要是描述我们在从事电商搜索引擎过程中的遇到的一些问 ...
- Intellij IDEA 插件开发
写在前面 很多idea插件文档更多的是介绍如何创建一个简单的idea插件,本篇文章从开发环境.demo.生态组件.添加依赖包.源码解读.网络请求.渲染数据.页面交互等方面介绍,是一篇能够满足基本的插件 ...
- Visual Studio2019如何添加引用
同一解决方案中添加引用 比如我们想在Test项目中添加Queue项目的引用 1.鼠标右击引用-->添加引用 2."引用管理器"-->项目-->解决方案--&g ...
- Python Django 零基础从零到一部署服务,Hello Django!全文件夹目录和核心代码!
在这篇文章中,我将手把手地教你如何从零开始部署一个使用Django框架的Python服务.无论你是一个刚开始接触开发的新手,还是一个有经验的开发者想要快速了解Django,这篇教程都会为你提供一条清晰 ...