
go 虎牙爬取
package main

import (

	"fmt"

	"github.com/antchfx/htmlquery"

	"io/ioutil"

	"net/http"

)

func main() {

	var url string = "https://www.huya.com/l"

	resp, _ := http.Get(url)

	defer resp.Body.Close()

	doc,_ := htmlquery.Parse(resp.Body)

	list := htmlquery.Find(doc, "//ul[@id='js-live-list']//li")

	for _,li := range list{

		nick := htmlquery.FindOne(li,"//i[@class='nick']/text()")

		//people := htmlquery.FindOne(li,"//i[@class='js-num']/text()")

		//title := htmlquery.FindOne(li,"//a[@class='title']")

		img := htmlquery.FindOne(li,"//a[@class='video-info ']/img/@data-original")

		//fmt.Printf("%s %s %s %s\n",htmlquery.InnerText(nick),htmlquery.InnerText(people),htmlquery.SelectAttr(title,"title"),htmlquery.SelectAttr(img,"data-original"))

		imgurl := htmlquery.SelectAttr(img,"data-original")

		titleString := htmlquery.InnerText(nick)

		savepic(imgurl,titleString)

	}

}

func savepic(url string,name string ) {

	if len(url)<= 0{

		return

	}

	if url[0:2] == "//" {

		url =   "http:"+url

	}

	resp, err := http.Get(url)

	if err !=nil{

		fmt.Println("http error",err)

		return

	}

	content, err1 := ioutil.ReadAll(resp.Body)

	if err1 != nil{

		fmt.Println("read err",err1)

		return

	}

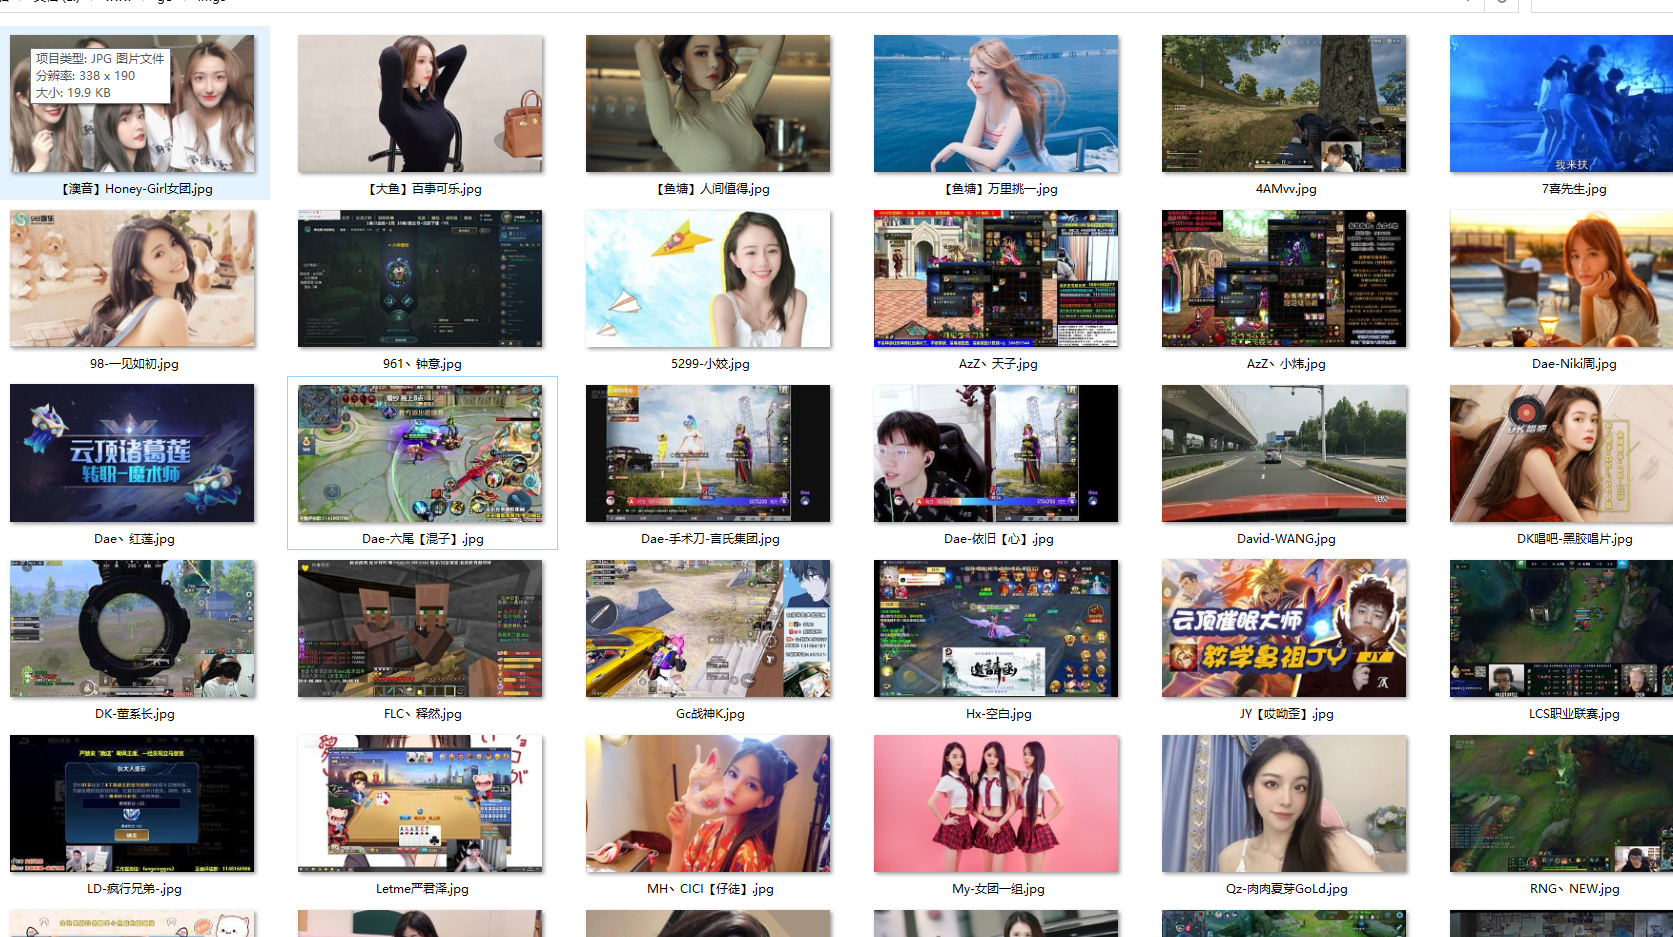
	file := ioutil.WriteFile("./imgs/"+name+".jpg", content, 0777)

	if file != nil {

		fmt.Printf("下载图片%s 失败\n", name)

	} else{

		fmt.Printf("下载图片%s 成功\n", name)

	}

}
go 虎牙爬取的更多相关文章
- Scrapy:虎牙爬取,图片存储与数据分析
第一次爬取虎牙主播数据,有点小激动 1.共批量爬取的101个主播的,包括 头像 主播名字 房间号 房间链接 2.数据规整部分,需要将json数据加载到pandas的Dataframe,只显示的前15个 ...
- Scrapy框架爬虫初探——中关村在线手机参数数据爬取
关于Scrapy如何安装部署的文章已经相当多了,但是网上实战的例子还不是很多,近来正好在学习该爬虫框架,就简单写了个Spider Demo来实践.作为硬件数码控,我选择了经常光顾的中关村在线的手机页面 ...
- python爬取github数据
爬虫流程 在上周写完用scrapy爬去知乎用户信息的爬虫之后,github上star个数一下就在公司小组内部排的上名次了,我还信誓旦旦的跟上级吹牛皮说如果再写一个,都不好意思和你再提star了,怕你们 ...
- Python多线程爬虫爬取电影天堂资源
最近花些时间学习了一下Python,并写了一个多线程的爬虫程序来获取电影天堂上资源的迅雷下载地址,代码已经上传到GitHub上了,需要的同学可以自行下载.刚开始学习python希望可以获得宝贵的意见. ...
- python3爬取1024图片
这两年python特别火,火到博客园现在也是隔三差五的出现一些python的文章.各种开源软件.各种爬虫算法纷纷开路,作为互联网行业的IT狗自然看的我也是心痒痒,于是趁着这个雾霾横行的周末瞅了两眼,作 ...
- 从爬取湖北某高校hub教务系统课表浅谈Java信息抓取的实现 —— import java.*;
原创文章与源码,如果转载请注明来源. 开发环境:Myeclipse,依赖包:apache-httpclient . Jsoup.base64 一.概述 整个系统用Java开发.我们现在要做的是类似于超 ...
- 使用beautifulsoup与requests爬取数据
1.安装需要的库 bs4 beautifulSoup requests lxml如果使用mongodb存取数据,安装一下pymongo插件 2.常见问题 1> lxml安装问题 如果遇到lxm ...
- python爬虫学习(7) —— 爬取你的AC代码
上一篇文章中,我们介绍了python爬虫利器--requests,并且拿HDU做了小测试. 这篇文章,我们来爬取一下自己AC的代码. 1 确定ac代码对应的页面 如下图所示,我们一般情况可以通过该顺序 ...
- Python实战项目网络爬虫 之 爬取小说吧小说正文
本次实战项目适合,有一定Python语法知识的小白学员.本人也是根据一些网上的资料,自己摸索编写的内容.有不明白的童鞋,欢迎提问. 目的:爬取百度小说吧中的原创小说<猎奇师>部分小说内容 ...
随机推荐
- 转发请求RequestDispatcher()方法用于与页面的交互
jsp1代码 <form action="HelloServlet" > 账号: <input type="text" name=" ...
- [源码分析] OpenTracing之跟踪Redis
[源码分析] OpenTracing之跟踪Redis 目录 [源码分析] OpenTracing之跟踪Redis 0x00 摘要 0x01 总体逻辑 1.1 相关概念 1.2 埋点插件 1.3 总体逻 ...
- 记一次函数异常(getopt_long)
前言 以下参考博客以及man手册. getopt_long函数,getopt_long函数包含了getopt函数的功能,并且还可以指定"长参数"(或者说长选项),与getopt函数 ...
- [LeetCode] 337. 打家劫舍 III (树形dp)
题目 在上次打劫完一条街道之后和一圈房屋后,小偷又发现了一个新的可行窃的地区.这个地区只有一个入口,我们称之为"根". 除了"根"之外,每栋房子有且只有一个&q ...
- CentOS6.10下安装MongoDB和Redis
安装mongodb 首先考虑离线安装,但是安装过程中在启动服务的时候出现了问题,centOS出于稳定原因考虑,系统自带的glibc版本过低, 而编译需要使用较高版本,这个问题我查询了一下,需要升级gl ...
- chrome浏览器控制台 console不打印信息问题解决办法
谷歌浏览器控制台不能显示consle打印的东西,我记得之前可以正常打印,代码没问题,可能是你在浏览器中无意间点到了fifter,我们2可以使用最简单粗暴的方法---->恢复默认值. 按下F12, ...
- [De1CTF 2019]Giftbox 分析&&TPOP学习
[De1CTF 2019]Giftbox 刚进来我以为是直接给了shell,恐怖如斯. 随便扔了个命令,之后就没然后了,hhh,截包发现可能存在sql注入. 然后我就不会了... what i lea ...
- Python爬取股票信息,并实现可视化数据
前言 截止2019年年底我国股票投资者数量为15975.24万户, 如此多的股民热衷于炒股,首先抛开炒股技术不说, 那么多股票数据是不是非常难找, 找到之后是不是看着密密麻麻的数据是不是头都大了? 今 ...
- Vue 分支循环
分支循环 在Vue中,分支循环也是使用标签属性指令完成的,这一点与后端模板语法不太相同. v-for 下面是通过v-for进行循环,不光可以拿到元素本身,也可以拿到索引值. 如果数据是对象类型,则可以 ...
- 推荐一个超牛的SpringCloud微服务项目,开发脚手架
前言 Cloud-Platform是国内首个基于Spring Cloud微服务化开发平台,具有统一授权.认证后台管理系统,其中包含具备用户管理.资源权限管理.网关API 管理等多个模块,支持多业务系统 ...