
爬虫简介与request模块
一 爬虫简介
概述
近年来,随着网络应用的逐渐扩展和深入,如何高效的获取网上数据成为了无数公司和个人的追求,在大数据时代,谁掌握了更多的数据,谁就可以获得更高的利益,而网络爬虫是其中最为常用的一种从网上爬取数据的手段。
网络爬虫,即Web Spider,是一个很形象的名字。如果把互联网比喻成一个蜘蛛网,那么Spider就是在网上爬来爬去的蜘蛛。网络蜘蛛是通过网页的链接地址来寻找网页的。从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页都抓取完为止。

爬虫的价值
互联网中最有价值的便是数据,比如天猫商城的商品信息,链家网的租房信息,雪球网的证券投资信息等等,这些数据都代表了各个行业的真金白银,可以说,谁掌握了行业内的第一手数据,谁就成了整个行业的主宰,如果把整个互联网的数据比喻为一座宝藏,那我们的爬虫课程就是来教大家如何来高效地挖掘这些宝藏,掌握了爬虫技能, 你就成了所有互联网信息公司幕后的老板,换言之,它们都在免费为你提供有价值的数据。
robots.txt协议
如果自己的门户网站中的指定页面中的数据不想让爬虫程序爬取到的话,那么则可以通过编写一个robots.txt的协议文件来约束爬虫程序的数据爬取。robots协议的编写格式可以观察淘宝网的robots(访问www.taobao.com/robots.txt即可)。但是需要注意的是,该协议只是相当于口头的协议,并没有使用相关技术进行强制管制,所以该协议是防君子不防小人。但是我们在学习爬虫阶段编写的爬虫程序可以先忽略robots协议。
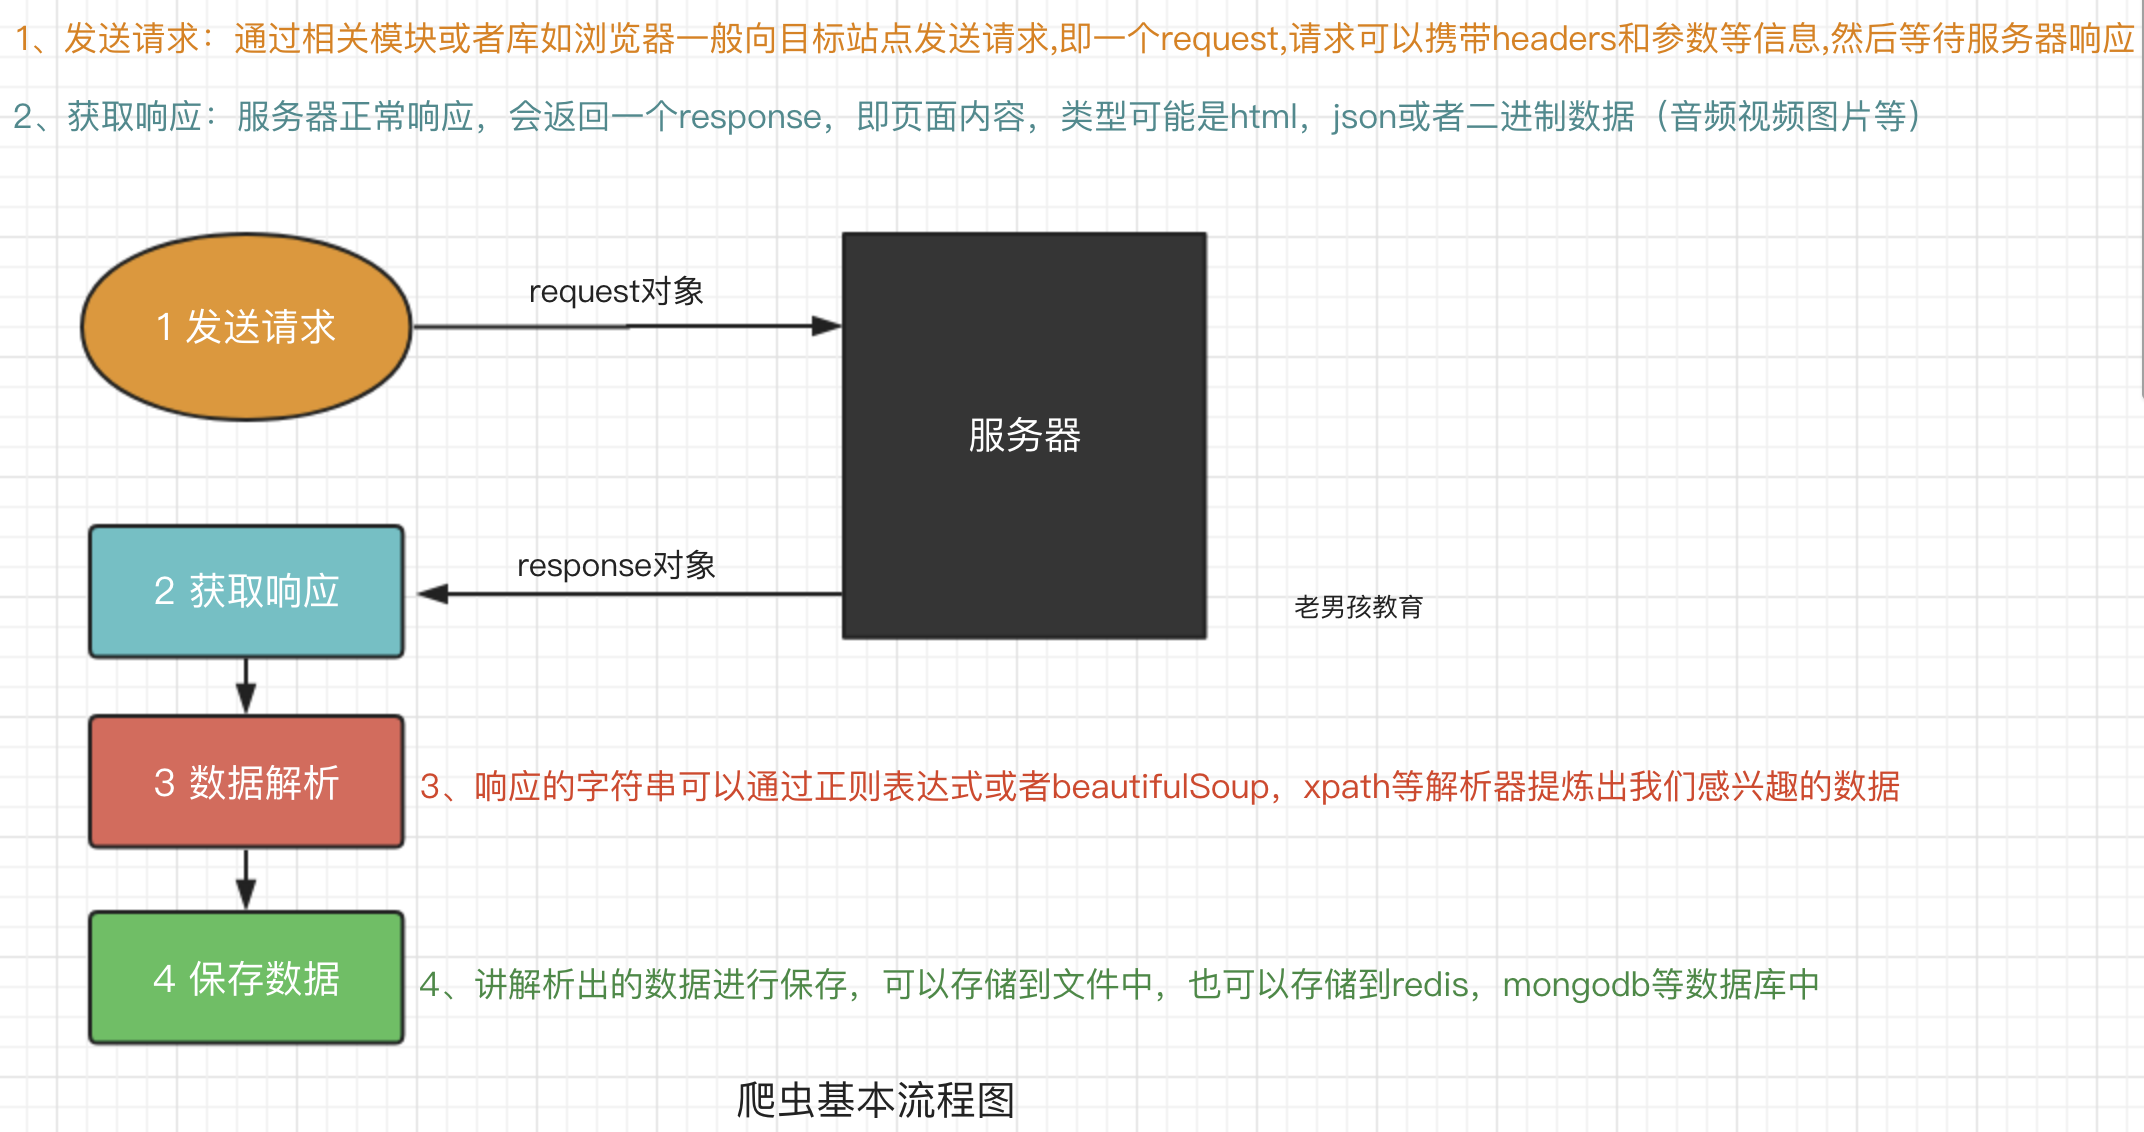
爬虫的基本流程
预备知识
http协议
https://www.cnblogs.com/pyedu/p/10287967.html
二 requests模块
requests模块支持的请求
import requests

requests.get("http://httpbin.org/get")

requests.post("http://httpbin.org/post")

requests.put("http://httpbin.org/put")

requests.delete("http://httpbin.org/delete")

requests.head("http://httpbin.org/get")

requests.options("http://httpbin.org/get")
get请求
1 基本请求
import requests

response=requests.get('https://www.jd.com/',)

with open("jd.html","wb") as f:

    f.write(response.content)
2 含参数请求
import requests

response=requests.get('https://s.taobao.com/search?q=手机')

response=requests.get('https://s.taobao.com/search',params={"q":"美女"})
3 含请求头请求
import requests

response=requests.get('https://dig.chouti.com/',

             headers={

                   'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.75 Safari/537.36',

                         }

                      )
4 含cookies请求
import uuid

import requests

url = 'http://httpbin.org/cookies'

cookies = dict(sbid=str(uuid.uuid4()))

res = requests.get(url, cookies=cookies)

print(res.text)
post请求
1 data参数
requests.post()用法与requests.get()完全一致,特殊的是requests.post()多了一个data参数,用来存放请求体数据
response=requests.post("http://httpbin.org/post",params={"a":"10"}, data={"name":"yuan"})
2 发送json数据
import requests

res1=requests.post(url='http://httpbin.org/post', data={'name':'yuan'}) #没有指定请求头,#默认的请求头:application/x-www-form-urlencoed

print(res1.json())

res2=requests.post(url='http://httpbin.org/post',json={'age':"22",}) #默认的请求头:application/json

print(res2.json())
response对象
(1) 常见属性
import requests

respone=requests.get('https://sh.lianjia.com/ershoufang/')

# respone属性

print(respone.text)

print(respone.content)

print(respone.status_code)

print(respone.headers)

print(respone.cookies)

print(respone.cookies.get_dict())

print(respone.cookies.items())

print(respone.url)

print(respone.history)

print(respone.encoding)
(2) 编码问题
import requests

response=requests.get('http://www.autohome.com/news')

#response.encoding='gbk' #汽车之家网站返回的页面内容为gb2312编码的,而requests的默认编码为ISO-8859-1,如果不设置成gbk则中文乱码

with open("res.html","w") as f:

    f.write(response.text)
(3) 下载二进制文件(图片,视频,音频)
import requests

response=requests.get('http://bangimg1.dahe.cn/forum/201612/10/200447p36yk96im76vatyk.jpg')

with open("res.png","wb") as f:

    # f.write(response.content) # 比如下载视频时,如果视频100G,用response.content然后一下子写到文件中是不合理的

    for line in response.iter_content():

        f.write(line)
(4) 解析json数据
import requests

import json

response=requests.get('http://httpbin.org/get')

res1=json.loads(response.text) #太麻烦

res2=response.json() #直接获取json数据

print(res1==res2)
(5) Redirection and History
默认情况下,除了 HEAD, Requests 会自动处理所有重定向。可以使用响应对象的 history 方法来追踪重定向。Response.history 是一个 Response 对象的列表,为了完成请求而创建了这些对象。这个对象列表按照从最老到最近的请求进行排序。
>>> r = requests.get('http://github.com')

>>> r.url

'https://github.com/'

>>> r.status_code

200

>>> r.history

[<Response [301]>]
另外,还可以通过 allow_redirects 参数禁用重定向处理:
>>> r = requests.get('http://github.com', allow_redirects=False)

>>> r.status_code

301

>>> r.history

[]
requests进阶用法
res=requests.get('http://httpbin.org/ip', proxies={'http':'110.83.40.27:9999'}).json()

print(res)
免费代理:https://www.kuaidaili.com/free/
爬虫简介与request模块的更多相关文章
- 1、爬虫简介与request模块
一 爬虫简介 概述 近年来,随着网络应用的逐渐扩展和深入,如何高效的获取网上数据成为了无数公司和个人的追求,在大数据时代,谁掌握了更多的数据,谁就可以获得更高的利益,而网络爬虫是其中最为常用的一种从网 ...
- 爬虫简介与requests模块
爬虫简介与requests模块 一 爬虫简介 概述 网络爬虫是一种按照一定规则,通过网页的链接地址来寻找网页的,从网站某一个页面(通常是首页)开始,读取网页的内容,找到网页中的其他链接地址,然后通过这 ...
- 爬虫基础(一)-----request模块的使用
---------------------------------------------------摆脱穷人思维 <一> : 建立时间价值的概念,减少做那些"时间花的多收 ...
- 爬虫简介和requests模块
目录 爬虫介绍 requests模块 requests模块 1.requests模块的基本使用 2.get 请求携带参数,调用params参数,其本质上还是调用urlencode 3.携带header ...
- 爬虫之urllib包以及request模块和parse模块
urllib简介 简介 Python3中将python2.7的urllib和urllib2两个包合并成了一个urllib库 Python3中,urllib库包含有四个模块: urllib.reques ...
- nodejs爬虫笔记(一)---request与cheerio等模块的应用
目标:爬取慕课网里面一个教程的视频信息,并将其存入mysql数据库.以http://www.imooc.com/learn/857为例. 一.工具 1.安装nodejs:(操作系统环境:WiN 7 6 ...
- 爬虫与request模块
一.爬虫简介 1.介绍 网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本.另外一些不常使用的名字还有蚂蚁. ...
- 【nodejs】理想论坛帖子下载爬虫1.07 使用request模块后稳定多了
在1.06版本时,访问网页采用的时http.request,但调用次数多以后就问题来了. 寻找别的方案时看到了https://cnodejs.org/topic/53142ef833dbcb076d0 ...
- 爬虫基础之requests模块
1. 爬虫简介 1.1 概述 网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本. 1.2 爬虫的价值 在互 ...
随机推荐
- JavaScript(转载自 计科学院 慕课网)
什么是脚本语言? ①脚本语言介于HTML和C,C++,Java,C#等编程语言之间 ②脚本语言与编程语言有相似地方,其函数与编程语言类似,也有变量.与编程语言之间最大的区别是编程语言的语法和规则更为严 ...
- Dynamics 365新特性介绍:在视图中显示图片和提示
关注本人微信和易信公众号: 微软动态CRM专家罗勇 ,回复242或者20161230可方便获取本文,同时可以在第一间得到我发布的最新的博文信息,follow me!我的网站是 www.luoyong. ...
- vulnhub writeup - 持续更新
目录 wakanda: 1 0. Description 1. flag1.txt 2. flag2.txt 3. flag3.txt Finished Tips Basic Pentesting: ...
- MyBatis批量修改操作
1.需求 后台管理页面,查询频道列表,需要批量修改频道的状态,批量上线和下线 2.MyBatis配置 这是mysql的配置,注意需要加上&allowMultiQueries=true配置 jd ...
- iOS开发之OC与swift开发混编教程,代理的相互调用,block的实现。OC调用Swift中的代理, OC调用Swift中的Block 闭包
本文章将从两个方向分别介绍 OC 与 swift 混编 1. 第一个方向从 swift工程 中引入 oc类 1. 1 如何在swift的类中使用oc类 1.2 如何在swift中实现oc的代理 ...
- MySql 学习之路-高级2
目录: 1.约束 2.ALTER TABLE 3.VIEW 1.约束 说明:SQL约束用于规定表中的数据规则,如果存在违反约束的数据行为,行为会被约束终止,约束可以在建表是规定,也可以在建表后规定,通 ...
- Thread中的join()方法
package com.qjc.thread; public class JoinExcemple { // join方法就是用来同步的 public static void main(String[ ...
- Python开发【前端篇】HTML5+CSS3
CSS权重 CSS权重指的是样式的优先级,有两条或多条样式作用于一个元素,权重高的那条样式对元素起作用,权重相同的,后写的样式会覆盖前面写的样式. 权重的等级 可以把样式的应用方式分为几个等级,按照等 ...
- uml类图关系
原文地址http://www.jfox.info/uml-lei-tu-guan-xi-fan-hua-ji-cheng-shi-xian-yi-lai-guan-lian-ju-he-zu-he 在 ...
- Spark1.6之后为何使用Netty通信框架替代Akka
解决方案: 一直以来,基于Akka实现的RPC通信框架是Spark引以为豪的主要特性,也是与Hadoop等分布式计算框架对比过程中一大亮点. 但是时代和技术都在演化,从Spark1.3.1版本开始,为 ...