
Kafka基础入门
1. Kafka简介
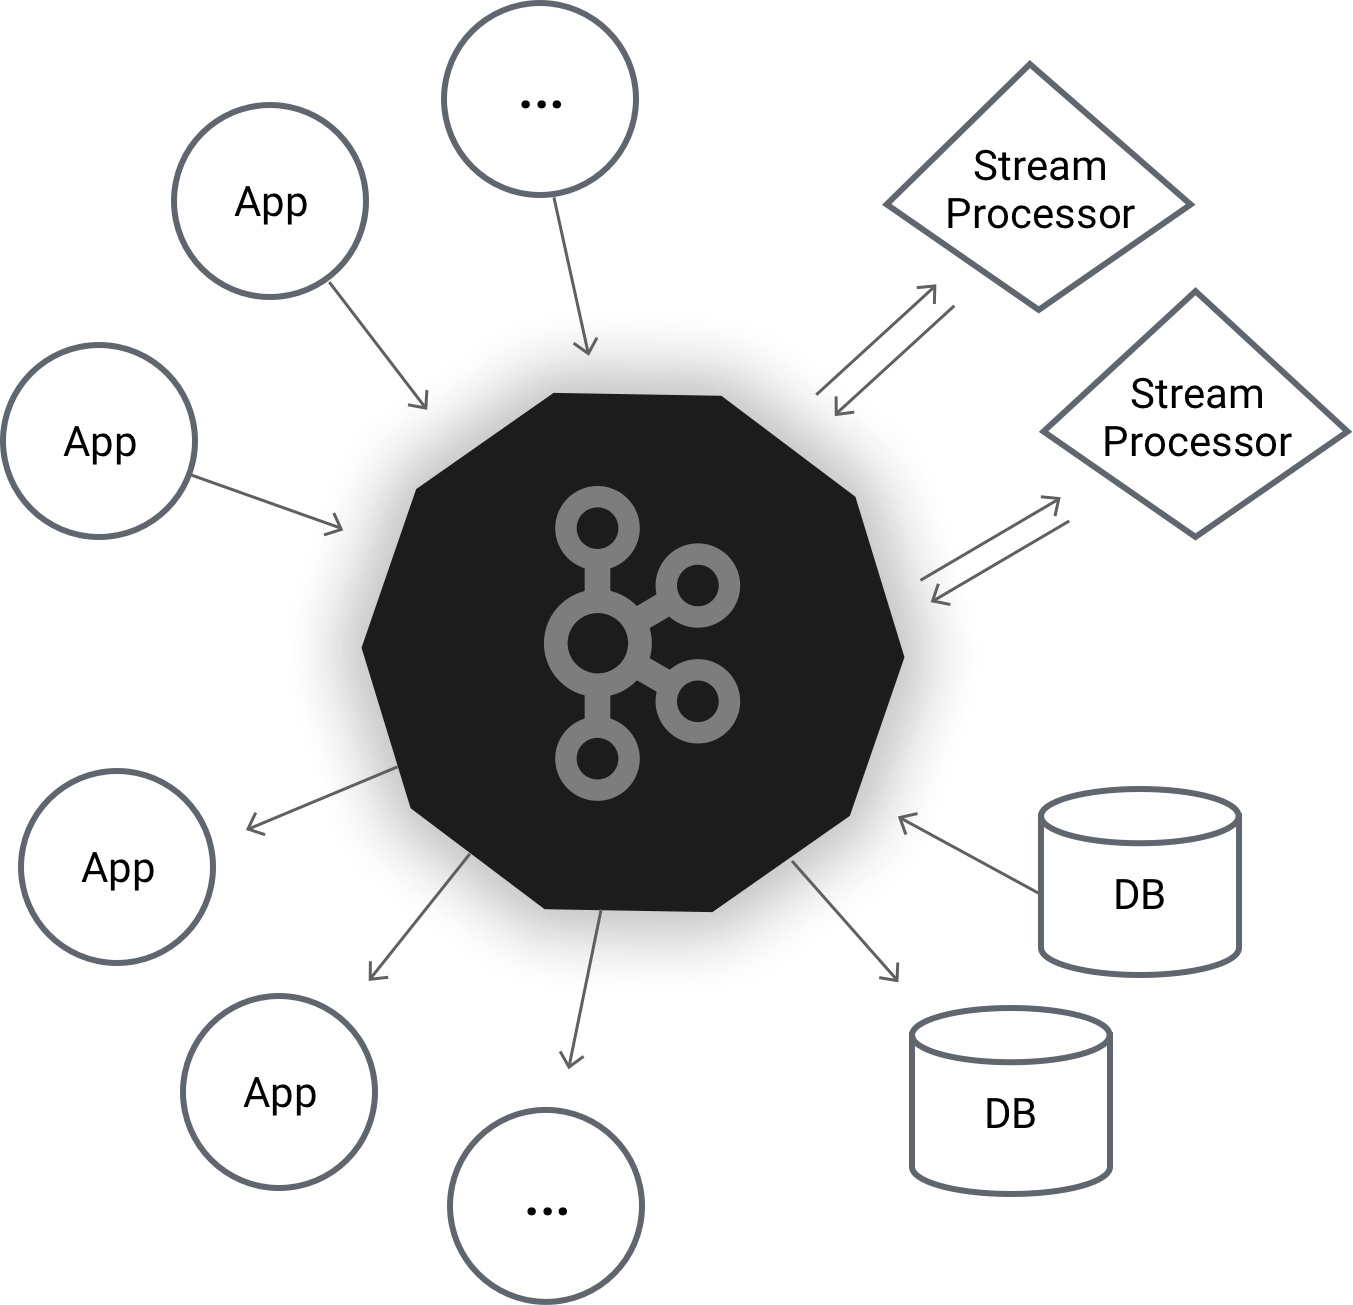
Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写。Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流数据。 这种动作(网页浏览,搜索和其他用户的行动)是在现代网络上的许多社会功能的一个关键因素。 这些数据通常是由于吞吐量的要求而通过处理日志和日志聚合来解决。 对于像Hadoop的一样的日志数据和离线分析系统,但又要求实时处理的限制,这是一个可行的解决方案。Kafka的目的是通过Hadoop的并行加载机制来统一线上和离线的消息处理,也是为了通过集群来提供实时的消费。
2. 名词解释
- Broker
Kafka集群包含一个或多个服务器,这种服务器被称为broker[5] - Topic
每条发布到Kafka集群的消息都有一个类别,这个类别被称为Topic。(物理上不同Topic的消息分开存储,逻辑上一个Topic的消息虽然保存于一个或多个broker上但用户只需指定消息的Topic即可生产或消费数据而不必关心数据存于何处) - Partition
Partition是物理上的概念,每个Topic包含一个或多个Partition. - Producer
消息生产者,负责发布消息到Kafka broker - Consumer
消息消费者,向Kafka broker读取消息的客户端。 - Consumer Group
每个Consumer属于一个特定的Consumer Group(可为每个Consumer指定group name,若不指定group name则属于默认的group)。
3. Kafka拓扑结构

一个典型的Kafka集群中包含若干Producer(可以是web前端产生的Page View,或者是服务器日志,系统CPU、Memory等),若干broker(Kafka支持水平扩展,一般broker数量越多,集群吞吐率越高),若干Consumer Group,以及一个Zookeeper集群。Kafka通过Zookeeper管理集群配置,选举leader,以及在Consumer Group发生变化时进行rebalance。Producer使用push模式将消息发布到broker,Consumer使用pull模式从broker订阅并消费消息。
对于传统的message queue而言,一般会删除已经被消费的消息,而Kafka集群会保留所有的消息,无论其被消费与否。当然,因为磁盘限制,不可能永久保留所有数据(实际上也没必要),因此Kafka提供两种策略删除旧数据。一是基于时间,二是基于Partition文件大小。例如可以通过配置$KAFKA_HOME/config/server.properties,让Kafka删除一周前的数据,也可在Partition文件超过1GB时删除旧数据,配置如下所示。
# The minimum age of a log file to be eligible for deletion

log.retention.hours=168

# The maximum size of a log segment file. When this size is reached a new log segment will be created.

log.segment.bytes=1073741824

# The interval at which log segments are checked to see if they can be deleted according to the retention policies

log.retention.check.interval.ms=300000

# If log.cleaner.enable=true is set the cleaner will be enabled and individual logs can then be marked for log compaction.

log.cleaner.enable=false
4. Kafka常用命令
- 启动zookeeper
nohup /usr/kafka/kafka_2.11-0.11.0.0/bin/zookeeper-server-start.sh /usr/kafka/kafka_2.11-0.11.0.0/config/zookeeper.properties &
- 停止zookeeper
/usr/kafka/kafka_2.11-0.11.0.0/bin/zookeeper-server-stop.sh /usr/kafka/kafka_2.11-0.11.0.0/config/zookeeper.properties &
- 启动kafka
nohup /usr/kafka/kafka_2.11-0.11.0.0/bin/kafka-server-start.sh /usr/kafka/kafka_2.11-0.11.0.0/config/server.properties &
- 停止kafka
/usr/kafka/kafka_2.11-0.11.0.0/bin/kafka-server-stop.sh /usr/kafka/kafka_2.11-0.11.0.0/config/server.properties &
- 创建Topic
./kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic test3
- 查看所有topic
./kafka-topics.sh --list --zookeeper localhost:2181
- 查看某个topic主题详情
./kafka-topics.sh --describe --zookeeper localhost:2181 --topic test3
- 发送消息,使用生产者,创建一个broker
./kafka-console-producer.sh --broker-list localhost:9092 --topic test3
- 接收消息,使用消费者
./kafka-console-consumer.sh --zookeeper localhost:2181 --topic test3 --from-beginning
Kafka基础入门的更多相关文章
- 【对线面试官】Kafka基础入门
<对线面试官>系列目前已经连载33篇啦,这是一个讲人话面试系列 [对线面试官]Java注解 [对线面试官]Java泛型 [对线面试官] Java NIO [对线面试官]Java反射 &am ...
- kafka学习笔记(二)——基础入门
1.集群规划 从官网下载jar包 http://kafka.apache.org/downloads.html,我选择的是kafka_2.11-0.11.0.0.tgz版本 规划一下集群环境先~ ha ...
- Zookeeper与Kafka基础概念和原理
1.zookeeper概念介绍 在介绍ZooKeeper之前,先来介绍一下分布式协调技术,所谓分布式协调技术主要是用来解决分布式环境当中多个进程之间的同步控制,让他们有序的去访问某种共享资源,防止造成 ...
- Kafka【入门】就这一篇!
为获得更好的阅读体验,建议您访问原文地址:传送门 前言:在之前的文章里面已经了解到了「消息队列」是怎么样的一种存在(传送门),Kafka 作为当下流行的一种中间件,我们现在开始学习它! 一.Kafka ...
- 【01】SpringBoot2核心技术-基础入门
SpringBoot 2 1. SpringBoot2核心技术-基础入门 01 Spring与SpringBoot 1.Spring 能做什么 1.1 Spring的能力 微服务:将一个应用的所有功能 ...
- js学习笔记:webpack基础入门(一)
之前听说过webpack,今天想正式的接触一下,先跟着webpack的官方用户指南走: 在这里有: 如何安装webpack 如何使用webpack 如何使用loader 如何使用webpack的开发者 ...
- 「译」JUnit 5 系列:基础入门
原文地址:http://blog.codefx.org/libraries/junit-5-basics/ 原文日期:25, Feb, 2016 译文首发:Linesh 的博客:JUnit 5 系列: ...
- .NET正则表达式基础入门
这是我第一次写的博客,个人觉得十分不容易.以前看别人写的博客文字十分流畅,到自己来写却发现十分困难,还是感谢那些为技术而奉献自己力量的人吧. 本教程编写之前,博主阅读了<正则指引>这本入门 ...
- 从零3D基础入门XNA 4.0(2)——模型和BasicEffect
[题外话] 上一篇文章介绍了3D开发基础与XNA开发程序的整体结构,以及使用Model类的Draw方法将模型绘制到屏幕上.本文接着上一篇文章继续,介绍XNA中模型的结构.BasicEffect的使用以 ...
随机推荐
- js判断时间段
开始时间小于结束时间的判断,下面是封装号的方法,直接可以调用: var data = new Date(); var year = data .getFullYear(); //获取完整的年份(4位) ...
- npm、cnpm、yarn 安装删除异同
背景 一直觉得npm.cnpm.yarn的安装删除基本一样用哪个都行,不过俗话说的好,实践出真知,这里记录一下今天简单测试得到的结果总结. 可能会有错误,希望大家评论指正,十分感谢. 测试电脑系统:M ...
- sqlserver 评估过期
解决:重新打开安装中心->维护-->版本升级 ,重新输入序列号 即可 sqlserver2008企业级序列号:JD8Y6-HQG69-P9H84-XDTPG-34MBB
- ajax源代码
//**********第一步, 获得一个xhr对象************* var xmlHttpReq = null; //声明一个空对象用来装入XMLHttpRequest if (windo ...
- vue组件之间的传值方式
一.父组件向子组件传值方式 1.1父组件向子组件传数据方式 <!DOCTYPE html> <html lang="en"> <head> &l ...
- 自己封装element-ui树组件的过滤
前言:vue开发项目时用到了element-ui的树组件,但是发现一执行过滤事件,树就全部都展开了,为了解决这个问题,只能自己先过滤数剧,再赋值给树组件的data,就避免了一上来全部展开的尴尬. 一. ...
- VS启动Winform项目提示:不支持互操作调试
64 位平台不支持互操作调试(托管 + 非托管混合模式调试). 在VS中设置项目属性--->调试--->取消选中“启用本地代码调试”. 此问题在.NET FrameWork低版本框架会出现 ...
- 计算CPU的MIPS
如图: MIPS=主频/CPI*(10^6), 其中CPI的计算公式为CPI=总的时钟周期数/总的指令数 CPI=(0.5a*2+0.2a*3+0.1a*4+0.2a*5)/a=3
- HBuilder git合作-代码同步
1. 以下场景的操作都是同样的,包括:新建了文件.删除了文件.独占式修改文件(即不存在多人同时修改一个文件的情况) 提交 项目修改完成后,选中项目,右键Team->Commit 一般是选择Com ...
- ubuntu tensorflow install(Ubuntu16.04+CUDA9.0+cuDNN7.5+Python3.6+TensorFlow1.5)
在网上找了很多案例,踩了许多坑,感觉比较全面的是下面介绍的 http://www.cnblogs.com/xuliangxing/p/7575586.html 先说说我的步骤: 首先安装了Anacod ...