
1.0 Hadoop的介绍、搭建、环境
HADOOP背景介绍
1.1 Hadoop产生背景
- HADOOP最早起源于Nutch。Nutch的设计目标是构建一个大型的全网搜索引擎,包括网页抓取、索引、查询等功能,但随着抓取网页数量的增加,遇到了严重的可扩展性问题——如何解决数十亿网页的存储和索引问题。
- 2003年、2004年谷歌发表的两篇论文为该问题提供了可行的解决方案。(谷歌为现代技术做了十分大的贡献!!)
——分布式文件系统(GFS),可用于处理海量网页的存储
——分布式计算框架MAPREDUCE,可用于处理海量网页的索引计算问题。
Nutch的开发人员完成了相应的开源实现HDFS和MAPREDUCE,并从Nutch中剥离成为独立项目HADOOP,到2008年1月,HADOOP成为Apache顶级项目,迎来了它的快速发展期。
1.2 什么是HADOOP
- HADOOP是apache旗下的一套开源软件平台(apache软件几乎都开源)
- HADOOP提供的功能:利用服务器集群,根据用户的自定义业务逻辑,对海量数据进行分布式处理
- HADOOP的核心组件有
- HDFS(分布式文件系统)
- YARN(运算资源调度系统)
- MAPREDUCE(分布式 运算编程框架)
1.3 HADOOP在大数据、云计算中的位置和关系
1. 云计算是分布式计算、并行计算、网格计算、多核计算、网络存储、虚拟化、负载均衡等传统计算机技术和互联网技术融合发展的产物。借助IaaS(基础设施即服务)、PaaS(平台即服务)、SaaS(软件即服务)等业务模式,把强大的计算能力提供给终端用户。
2. 现阶段,云计算的两大底层支撑技术为“虚拟化”和“大数据技术。
3. 而HADOOP则是云计算的PaaS层的解决方案之一,并不等同于PaaS,更不等同于云计算本身。
1.4 Hadoop生态系统

HDFS:分布式文件系统(hdfs、MAPREDUCE、yarn)元老级大数据处理技术框架,擅长离线数据分析
MAPREDUCE:分布式运算程序开发框架
HIVE:基于大数据技术(文件系统+运算框架)的SQL数据仓库工具,使用方便,功能丰富。但基于MR会有很大的延迟。
HBASE:基于HADOOP的分布式海量数据库,离线分析和在线业务通吃, 是 Google Bigtable 的另一套开源实现。
ZOOKEEPER:分布式协调服务基础组件,提供的功能包括:配置维护、名字服务、 分布式同步、心跳、组服务等
Mahout:基于mapreduce/spark/flink等分布式运算框架的机器学习算法库提供可扩展的计算机学习领域的算法实现,旨在帮助开发人员更加快捷地开发智能 应用程序。
Oozie:工作流调度框架
Sqoop:数据导入导出工具
Flume:日志数据采集框架
Avro: 基于JSON的数据序列化的系统。
Cassandra: 一套分布式,非关系型存储系统,类似Google - BigTable。
Chukwa: 用于监控大型分布式系统的数据采集系统。
Pig:提供一个并行执行的数据流框架。
Spark:类似MapReduce的通用并行框架,继承了其的分布式优势,只是中间输出结果存储 于内存中,提供了相对实时性的处理能力
Tez:新的一套分布式执行框架,主要以开发人员为最终用户构建性能更快、扩展性更强的应 用程序。
1.5Hadoop大数据项目流程图
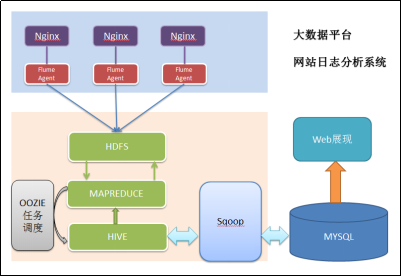
1) 数据采集:定制开发采集程序,或使用开源框架FLUME
2) 数据预处理:定制开发mapreduce程序运行于hadoop集群
3) 数据仓库技术:基于hadoop之上的Hive
4) 数据导出:基于hadoop的sqoop数据导入导出工具
5) 数据可视化:定制开发web程序或使用kettle等产品
6) 整个过程的流程调度:hadoop生态圈中的oozie工具或其他类似开源产品
1.6Hadoop集群的安装
提前准备:虚拟机的正常安装,网卡启动成功,Xshell和ftp软件。jdk的压缩包,和Hadoop的压缩包。
HadoopMaster1 NameNode SecondaryNameNode 192.168.242.110
HadoopYarn ResourceManager 192.168.242.111
HadoopSlaver1 DataNode NodeManager 192.168.242.112
HadoopSlaver2 DataNode NodeManager 192.168.242.113
HadoopSlaver3 DataNode NodeManager 192.168.242.114
1.6.1上传jdk安装包(用xftp上传文件)
解压到相应目录:rpm -ivh ./xxxxx.jdk ./user/java
编辑环境变量:为了在各个目录下能运行JAVA代码
vim /etc/profile
export JAVA_HOME=/usr/java/jvm/jdk1.7.0_79
export JRE_HOME=${JAVA_HOME}/jre
export CLASSPATH=.:${JAVA_HOME}/lib:${JRE_HOME}/lib
export PATH=${JAVA_HOME}/bin:$PATH
wq后保存: source /etc/profile 配置更新
echo java 检验 或者 javac java-version
1.6.2 Hadoop的安装
1、解压到相应目录:cd /usr/local tar –zxvf ./hadoop-2.7.2.tar.gz
把目录修改为hadoop mv hadoop-2... hadoop
2、修改hadoop-env.sh
vim /usr/local/hadoop/etc/hadoop/hadoop-env.sh
修改export JAVA_HOME 语句为 export JAVA_HOME=/usr/java/default
3、修改core-site.xml 配置端口
cd /usr/local/hadoop/etc/hadoop
vi core-site.xml
<configuration>
<property>
<name>hadoop.tmp.dir</name>
<value>file://usr/hadoop/hadoop-2.6.4/tmp</value> //文件存储的目录。需要创建
</property>
<property>
<name>fs.defaultFS</name>
<value>hdfs://localhost:9000</value> //集群Master的端口号
</property>
</configuration>
###修改secondaryNamenode中的core-site.xml 配置冷备份
<property>
<name>fs.checkpoint.period</name>
<value>60</value>
</property>
<property>
<name>fs.checkpoint.size</name>
<value>67108864</value>
</property>
<property>
<name>fs.checkpoint.dir</name>
<value>file:/usr/hadoop/hadoop-2.8.0/dfs/fsimage/</value> //需要把映射文件考到这个目录
</property>
<property>
<name>fs.checkpoint.edits.ir</name>
<value>file:/usr/hadoop/hadoop-2.8.0/dfs/edits/</value>
</property>
4、修改集群hdfs-site.xml配置
vi hdfs-site.xml
<configuration>
<property>
<name>dfs.namenode.secondary.http-address</name> //冷备份
<value>HadoopMaster1 :50090</value>
</property>
<property>
<name>dfs.namenode.name.dir</name>
<value>/home/hadoop/data/name</value>//主文件的存储目录需要在相应目录创建
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/home/hadoop/data/data</value>//data文件的存储目录需要在相应目录创建
</property>
<property>
<name>dfs.replication</name>
<value>3</value>
</property>
<property>
<name>dfs.secondary.http.address</name>
<value>hdp-node-01:50090</value>
</property>
</configuration>
5、配hadoop的环境变量 把/usr/hadoop/bin和/usr/hadoop/sbin设到PATH中
vi /etc/profile
export PATH=$PATH:/usr/hadoop/bin:/usr/hadoop/sbin
更新:source etc/profile
测试hadoop命令是否可以直接执行,任意目录下敲hadoop
1.6.3Yarn的搭建
配置计算调度系统Yarn和计算引擎Map/Reduce
1 namenode上配置 mapred-site.xml
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
2 yarn-site.xml的配置
<property>
<name>yarn.resourcemanager.hostname</name>
<value>master</value>
</property>
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<property>
<name>yarn.nodemanager.auxservices.mapreduce.shuffle.class</name>
<value>org.apache.hadoop.mapred.ShuffleHandler</value>
</property>
3启动yarn集群start-yarn.sh
4 jps观察启动结果
1.6.4搭建五台机器,集群
1、关闭虚拟机,完全克隆复制5份(一个个启动 修改IP和hostname)
分别修改虚拟机的ip vim/etc/sysconfig/network-scripts/ifcfg-env33跟之前的图对应
修改hostname vim /etc/hostname 对应之前的名
2、确认互相能够ping通,用ssh登陆
在主机创建 .shh目录
ssh-keygen -t rsa
ssh-copy-id (子机IP和自己IP)一直确定完成免密,hosts修改可以改名
3,同时修改所有虚拟机的/etc/hosts,确认使用名字可以ping通
HadoopMaster1 192.168.242.110
HadoopYarn 192.168.242.111
HadoopSlaver1 192.168.242.112
HadoopSlaver2 192.168.242.113
HadoopSlaver3 192.168.242.114
4,修改master上/etc/hadoop/slaves文件,每一个slave占一行(子机的名)
HadoopSlaver1
HadoopSlaver2
HadoopSlaver3
现在集群namenode datanode已经可以启动了
使用start-dfs.sh启动集群,jps并观察结果
配置文件详细信息以后慢慢搭建时会慢慢更改。
现在这个集群完全搭建完毕,过程较长。建议初学者一点一点搭环境。配置文件可能会有问题。后续慢慢更改。
1.0 Hadoop的介绍、搭建、环境的更多相关文章
- Hadoop笔记之搭建环境
Hadoop的环境搭建分为单机模式.伪分布式模式.完全分布式模式. 因为我的本本比较挫,所以就使用伪分布式模式. 安装JDK 一般Linux自带的Java运行环境都是Open JDK,我们到官网下载O ...
- linux Cenos-7.0下安装jdk搭建环境变量
搭建linux系统的java环境本人目前所知有两种方式: 第一种是从oracle官网下载linux系统的jdk版本: 第二种是使用yum命令的方式下载安装,咱们今天讲的是第一种方式. 一.工具准备: ...
- Linux环境下Hadoop集群搭建
Linux环境下Hadoop集群搭建 前言: 最近来到了武汉大学,在这里开始了我的研究生生涯.昨天通过学长们的耐心培训,了解了Hadoop,Hdfs,Hive,Hbase,MangoDB等等相关的知识 ...
- 环境搭建-Hadoop集群搭建
环境搭建-Hadoop集群搭建 写在前面,前面我们快速搭建好了centos的集群环境,接下来,我们就来开始hadoop的集群的搭建工作 实验环境 Hadoop版本:CDH 5.7.0 这里,我想说一下 ...
- Hadoop学习笔记—1.基本介绍与环境配置
一.Hadoop的发展历史 说到Hadoop的起源,不得不说到一个传奇的IT公司—全球IT技术的引领者Google.Google(自称)为云计算概念的提出者,在自身多年的搜索引擎业务中构建了突破性的G ...
- 使用WIF实现单点登录Part I——Windows Identity Foundation介绍及环境搭建
首先先说一下什么是WIF(Windows Identity Foundation).由于各种历史原因,身份验证和标识的管理一般都比较无规律可循.在软件里加入“身份验证”功能意味着要在你的代码里混进处理 ...
- 使用WIF实现单点登录Part I——Windows Identity Foundation介绍及环境搭建 -摘自网络
上个月有一个星期的时间都在研究asp.net mvc统一身份验证及单点登录的实现.经过了一番的探索,最终决定使用微软的Windows Identity Foundation.但是这东西用的人貌似不多, ...
- Linux巩固记录(3) hadoop 2.7.4 环境搭建
由于要近期使用hadoop等进行相关任务执行,操作linux时候就多了 以前只在linux上配置J2EE项目执行环境,无非配置下jdk,部署tomcat,再通过docker或者jenkins自动部署上 ...
- 关于DreamWeaver CS6.0 + PhoneGap 之移动开发环境搭建
原博客地址为:http://blog.csdn.net/alovebtoc/article/details/9315437 HTML5已经逆袭了移动开发,近期有幸布置PhoneGap的环境搭载,其实 ...
随机推荐
- Delphi XE10在 Android下调用静态库a文件
Delphi Seatle can link Delphi project with Static library files(*.a): 1.at Delphi IDE, Add the " ...
- Token生成(转载)
package main import ( "encoding/base64" "encoding/json" "log" "ne ...
- ORACLE逐行累计求和方法(OVER函数)
1.RANK ( ) OVER ( [QUERY_PARTITION_CLAUSE] ORDER_BY_CLAUSE ) DENSE_RANK ( ) OVER ( [QUERY_PARTITION_ ...
- iOS原生分享功能
iOS_系统原生分享 - CSDN博客 通过UIActivityViewController实现更多分享服务 - 简书 UIActivity - UIKit _ Apple Developer Doc ...
- 实现 在子界面的button按下,在主界面的label显示。
不知道理解的对不对,反正功能是实现了. 这是子界面,COM口配置界面的 .H文件的定义.下面的Private:定义了Ui:MainWindow *main_ui;的指针变量 要 注 ...
- [译]C语言实现一个简易的Hash table(6)
上一章中,我们实现了Hash表中的插入.搜索和删除接口,我们在初始化hash表时固定了大小为53,为了方便扩展,本章将介绍如何修改hash表的大小. 设置Hash表大小 现在,我们的hash表是固定大 ...
- php面试题,百度答案
一公司: 1.@当将其放置在一个PHP表达式之前有什么作用? 2.用foreach把$arr=array(1,2,3,4)每个values值乘2输出: 3.PHP定界符如何使用? 4.说出mysql_ ...
- 大数据学习--day16(集合总体架构--ArrayList--LinkedList)
集合总体架构--ArrayList--LinkedList Collection接口的实现类用法上都有相似的方法.Map同理. List: 特性 : 1. 有索引 2. 有序 ...
- Docker 运行时的用户与组管理的方法
docker 以进程为核心, 对系统资源进行隔离使用的管理工具. 隔离是通过 cgroups (control groups 进程控制组) 这个操作系统内核特性来实现的. 包括用户的参数限制. 帐户管 ...
- 如何通过审计安全事件日志检测密码喷洒(Password Spraying)攻击
许多渗透测试人员和攻击者通常都会使用一种被称为“密码喷洒(Password Spraying)”的技术来进行测试和攻击.对密码进行喷洒式的攻击,这个叫法很形象,因为它属于自动化密码猜测的一种.这种针对 ...