
在zookeeper集群的基础上,搭建solrCloud
1 将在window中部署的单机版solr上传到node-01中
cd /export/software/

rz
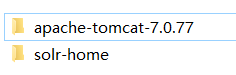
选择资料中的solr.zip进行上传(此zip就是 solr的简单部署:在tomcat中启动slor 的内容, 包含solr-home和tomcat)
2 将zip进行解压到指定目录中
由于是zip文件,在linux上解压需要unzip
yum -y install unzip

unzip solr.zip

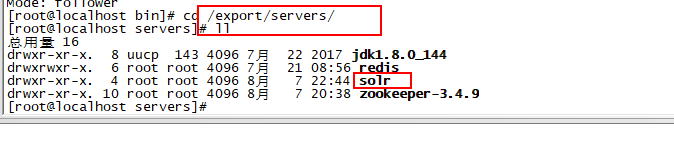
mv solr /export/servers/
3 修改tomcat的Catalina.sh的配置文件
cd /export/servers/solr/apache-tomcat-7.0./bin

vi catalina.sh             //注意此时修改的.sh的文件 为非.bat

//添加如下内容:(此处后面还会进行修改, 目前只是为了测试单机版本能否在linux中运行)

export "JAVA_OPTS=-Dsolr.solr.home=/export/servers/solr/solr-home"
4 启动tomcat测试单机版本能否在linux中运行
//注意: 由于是解压的是zip文件, tomcat中的.sh文件都没有任何的执行缺陷, 需要进行赋权限:

chmod  /export/servers/solr/apache-tomcat-7.0./bin/*

//启动tomcat:

cd /export/servers/solr/apache-tomcat-7.0.77/bin/

./startup.sh
访问 192.168.44.28:8080/solr 看是否成功 192.168.44.28是你当前虚拟机的ip
5 成功后: 将tomcat务必先关闭
./shutdown.sh
6 将solr的配置文件交给zookeeper进行管理
//1. 需要先上传solr的安装包

cd /export/software/

rz

//2. 解压solr的安装包

unzip solr-4.10..zip

//3. 将solr安装包复制到/export/servers下

mv solr-4.10. /export/servers/

//4. 开始执行上传

cd /export/servers/solr-4.10./example/scripts/cloud-scripts/

//注意: 以下命令是一行  而且要确保三台机器的zookeeper是开启的  zookeeper集群的搭建

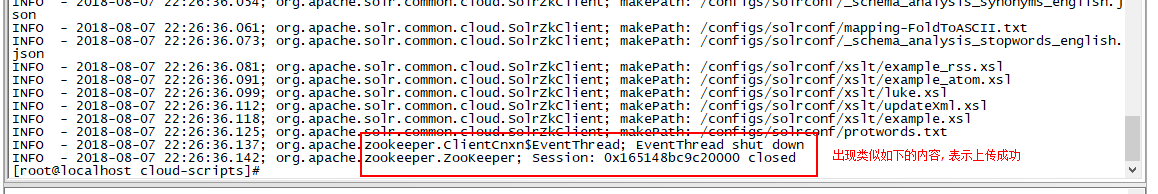
./zkcli.sh -zkhost node-:,node-:,node-: -cmd upconfig -confdir /export/servers/solr/solr-home/collection1/conf/ -confname solrconf
//参数解释: -zkhost指定zookeeper地址列表, -cmd指定命令, upconfig上传配置的命令, -confdir配置文件所在目录, -confname配置名称
7 修改solr.xml配置文件
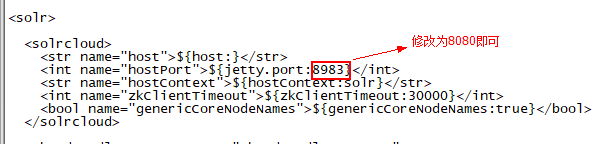
solr.xml是solr集群管理文件
cd /export/servers/solr/solr-home/

vi solr.xml
8 修改tomcat的Catalina.sh配置文件
其实可以单独修改每个solr的solrhome地址(修改每个solr的 web.xml 文件, 关联它自己的solrhome),然后在这里直接配置-DzHost就可以了,这里就先不做介绍了。
cd /export/servers/solr/apache-tomcat-7.0./bin/

vi catalina.sh

// 修改如下内容

export "JAVA_OPTS=-Dsolr.solr.home=/export/servers/solr/solr-home   //原来的内容

//以下为替换后的内容  注意: 这是一行内容, 复制时一起复制即可

export "JAVA_OPTS=-Dsolr.solr.home=/export/servers/solr/solr-home -DzkHost=node-01:2181,node-02:2181,node-03:2181
9 将solr目录发送到其他两台linux上(node2,node3)
cd /export/servers/

scp -r solr root@node-:$PWD

scp -r solr root@node-:$PWD
10 依次启动三台solr即可
cd /export/servers/solr/apache-tomcat-7.0./bin/

./startup.sh
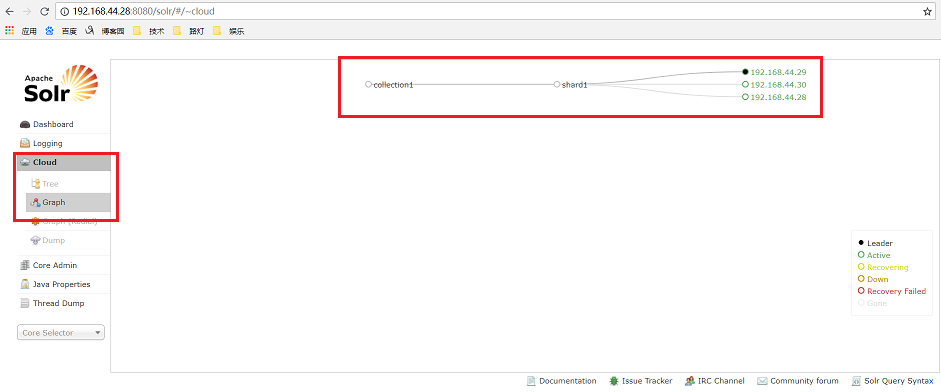
------------------------------以上 基本搭建就完成了 下面介绍solrCloud相关的管理命令-------------------------------
1 创建新集群(创建一个索引库)
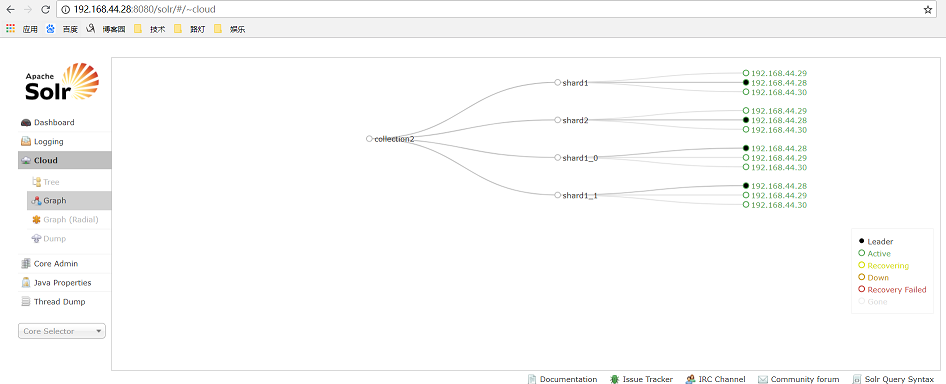
http://192.168.44.28:8080/solr/admin/collections?action=CREATE&name=collection2&numShards=2&replicationFactor=3&maxShardsPerNode=8&property.schema=schema.xml&property.config=solrconfig.xml

//接口参数说明:

action: 表示执行的操作 CREATE 创建

name: 新集群的名称

numShards: 分片数

replicationFactor: 每个分片的节点数

maxShardsPerNode: 设置每个分片的最大节点数, 默认为1

property.schema: 指定使用的schema文件   (注意, 此文件必须在zookeeper上存在)

property.config: 指定使用的solrConfig文件 (注意, 此文件必须在zookeeper上存在)
2 删除core命令
http://192.168.44.28:8080/solr/admin/collections?action=DELETE&name=collection1
3 查询所有的Core
http://192.168.44.28:8080/solr/admin/collections?action=LIST
4 分裂shard(扩展容量)
分裂: 就是将某个分片分成两个分片
注意: 一旦分裂后, 虽然原来的分片还可以提供服务, 但是已经不再保存数据, 会将数据保存到新的分裂后的分片
http://192.168.44.28:8080/solr/admin/collections?action=SPLITSHARD&collection=collection2&shard=shard1

参数说明:

shard: 指定要分裂的分片
5 删除某个分片
注意: 删除的分片必须是已经被分裂的, 或者是已经无法提供服务的
http://192.168.44.28:8080/solr/admin/collections?action=DELETESHARD&shard=shard1&collection=collection2
使用java代码对zookeeper集群中的solrCloud数据进行CURD
在zookeeper集群的基础上,搭建solrCloud的更多相关文章
- 沉淀,再出发——在Hadoop集群的基础上搭建Spark
在Hadoop集群的基础上搭建Spark 一.环境准备 在搭建Spark环境之前必须搭建Hadoop平台,尽管以前的一些博客上说在单机的环境下使用本地FS不用搭建Hadoop集群,可是在新版spark ...
- 在zookeeper集群的基础上,搭建伪solrCloud集群
伪集群的搭建:将solrCloud搭建到同一台机器上. 准备工作 1 将在window中部署的单机版solr上传到服务器(虚拟机)中 solr的简单部署:在tomcat中启动slor 的内容 这一次放 ...
- [k8s]zookeeper集群在k8s的搭建(statefulset模式)-pod的调度
之前一直docker-compose跑zk集群,现在把它挪到k8s集群里. docker-compose跑zk集群 zk集群in k8s部署 参考: https://github.com/kubern ...
- 第八章 搭建hadoop2.2.0集群,Zookeeper集群和hbase-0.98.0-hadoop2-bin.tar.gz集群
安装配置jdk,SSH 一.首先,先搭建三台小集群,虚拟机的话,创建三个 下面为这三台机器分别分配IP地址及相应的角色:集群有个特点,三台机子用户名最好一致,要不你就创建一个组,把这些用户放到组里面去 ...
- 关于Linux系统下zookeeper集群的搭建
1.集群概述 1.1什么是集群 1.1.1集群概念 集群是一种计算机系统, 它通过一组松散集成的计算机软件和/或硬件连接起来高度紧密地协作完成计算工作.在某种意义上,他们可以被看作是一台计算机.集群系 ...
- docker-compose搭建zookeeper集群环境 CodingCode
docker-compose搭建zookeeper集群环境 使用docker-compose搭建zookeeper集群环境 zookeeper是一个集群环境,用来管理微服务架构下面的配置管理功能. 这 ...
- Zookeeper集群介绍及其搭建
1 Zookeeper集群简介 1为什么搭建Zookeeper集群 大部分分布式应用需要一个主控.协调器或者控制器来管理物理分布的子进程.目前,大多数都要开发私有的协调程序,缺乏一个通用机制,协调程序 ...
- Zookeeper 集群 BindException: Cannot assign requested address 解决方案
前言 经历: 最近在搭建zookeeper集群,基础是3台机器(尝试过ubuntu 17 和 Centos 7). 一开始选择的是3台腾讯云服务器,每台机器在java环境配置正确的情况下,单机的情况都 ...
- 构建Zookeeper集群(zkcluster) ~一篇文章玩转zk集群^.^
概念 Zookeeper集群是由一个leader(负责人)主机和多个follower(追随者)或observer(观察者)主机组成. 构建一个Zookeeper集群需要有一个leader和一个foll ...
随机推荐
- 《Drools7.0.0.Final规则引擎教程》第4章 4.2 lock-on-active
lock-on-active 当在规则上使用ruleflow-group属性或agenda-group属性的时候,将lock-on-active 属性的值设置为true,可避免因某些Fact对象被修改 ...
- [面试时]我是如何讲清楚TCP/IP是如何实现可靠传输的 转
[面试时]我是如何讲清楚TCP/IP是如何实现可靠传输的 - shawjan的专栏 - 博客频道 - CSDN.NET http://blog.csdn.net/shawjan/article/det ...
- asp.net viewstate 数据过大 导致错误
当在ViewState中放入dataSet的数据量比较大的时候,当再点页面上的控件时,不会返回到后台,并且会出现如下错误: 或者是上面的12030改成500的错误. --解决方法:Viewstate绑 ...
- (二)canvas边框问题
lineWidth 设置边框的大小 fillStyle 设置div的颜色 strokeStyle 设置边框的颜色 注: 边框在不设置的情况下默认为1px 黑色,但是x,y轴的距离是以图形的正中心为原始 ...
- PTA L3-023 计算图 (dfs+数学推导)
“计算图”(computational graph)是现代深度学习系统的基础执行引擎,提供了一种表示任意数学表达式的方法,例如用有向无环图表示的神经网络. 图中的节点表示基本操作或输入变量,边表示节点 ...
- Django之模板继承
为了在Django模板配置中减少代码的冗余,需使用模板继承 1. 语法 {% block classinfo %} {% endblock} 2. 步骤 (1)创建一个base.html把需要显示的页 ...
- matlab中的开方sqrt用牛顿迭代法实现的代码
function kaifang = KAIFANG(a)g0=a/2;g1=(g0+a./g0)/2;for i=0 : 299g0=g1;g1=(g0+a./g0)/2;endkaifang = ...
- uoj #190. 【集训队互测2016】消失的源代码 提交答案题
Test 1: 发现是一个字母表的映射 把 \('a' \to 'z'\) 打进去找出映射就好了QAQ . Test 2: 求助 \(dalao\) 得知的点.. 答案是 : \(2016x^2 + ...
- Python学习流程
这是我在过去几家公司招聘到工程师,Python入职培训的过程. 时间分为4周,全部自学,仅提供大纲.适用于Web方向: 1.Week1:读完<简明Python教程>,适应Python开发环 ...
- dirname 和 basename
dirname 和 basename 命令 [root@localhost /]# cat /tmp/a.sh dirname $0 #获取脚本所在的路径 basename $0 ...