
ML assignment #1
ML assignment #1
Problem:
implement classification model to train the Iris dataset and make predictions.
Environment:
Navigator and Jupyter notebook
Language:
python 2.7
Module:
graphlab, matplotlib
Workflow:
1、decision tree using trainset and testset
首先使用graphlab.SFrame.read_csv(“Iris.csv”)導入數據集,然後將數據集,然後將其random split為trainset 和 testset,使用graphlab.decision_tree_classifier.create(train_data,target = target,features = features)
訓練model.該function會自動進行pruning 來防止overfitting.
訓練結果:
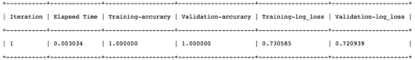
接著使用model.evaluate()分析預測準確率,準確率結果為:0.9629629629629629
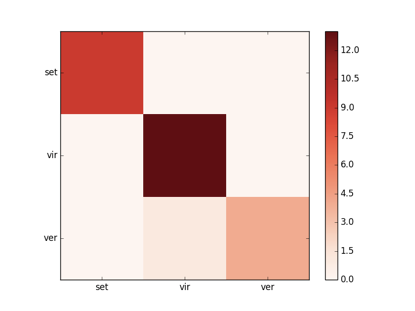
使用model.predict()對testset做出prediction,檢驗訓練模型. 並用 matplotlib畫出confusion matrix.
confusion matrix:
2、decision tree using K-fold cross validation
首先使用 graphlab.cross_validation.KFold(iris,10)將iris數據集進行10-fold拆分. 然後loop進行模型訓練,計算平均誤差.
最後的平均正確率結果為: 0.926666666667, 更佳符合實際.
3、decision using boosting
graphlab.boosted_trees_classifier.create(train_data,target=target,features=features)
對 train_data用boosting進行訓練,從結果中可以發現,耗時優於上面其他decision tree 算法.
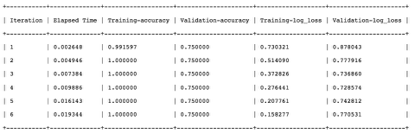
接著使用model.evaluate()分析預測準確率,準確率結果為:0.9629629629629629
使用model.predict()對testset做出prediction,檢驗訓練模型. 並用 matplotlib畫出confusion matrix.
4、using random forest graphlab.random_forest_classifier.create(train_data,target=target,features=features)
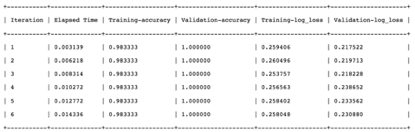
對 train_data進行random forest訓練.
結果如下:
會發現耗時較長,效率較差.
Conclusion:
總共使用了四種方法來對Iris 數據集進行模型訓練,其中1,3,4準確率相等,2略低但更符合test結果.所有的模型的confusion matrix均相同.
ML assignment #1的更多相关文章
- Programming Assignment 5: Kd-Trees
用2d-tree数据结构实现在2维矩形区域内的高效的range search 和 nearest neighbor search.2d-tree有许多的应用,在天体分类.计算机动画.神经网络加速.数据 ...
- Spark ML下实现的多分类adaboost+naivebayes算法在文本分类上的应用
1. Naive Bayes算法 朴素贝叶斯算法算是生成模型中一个最经典的分类算法之一了,常用的有Bernoulli和Multinomial两种.在文本分类上经常会用到这两种方法.在词袋模型中,对于一 ...
- Coursera Deep Learning 2 Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization - week1, Assignment(Initialization)
声明:所有内容来自coursera,作为个人学习笔记记录在这里. Initialization Welcome to the first assignment of "Improving D ...
- Coursera Deep Learning 2 Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization - week1, Assignment(Regularization)
声明:所有内容来自coursera,作为个人学习笔记记录在这里. Regularization Welcome to the second assignment of this week. Deep ...
- Spark2 ML 学习札记
摘要: 1.pipeline 模式 1.1相关概念 1.2代码示例 2.特征提取,转换以及特征选择 2.1特征提取 2.2特征转换 2.3特征选择 3.模型选择与参数选择 3.1 交叉验证 3.2 训 ...
- [Machine Learning & Algorithm]CAML机器学习系列2:深入浅出ML之Entropy-Based家族
声明:本博客整理自博友@zhouyong计算广告与机器学习-技术共享平台,尊重原创,欢迎感兴趣的博友查看原文. 写在前面 记得在<Pattern Recognition And Machine ...
- [Machine Learning & Algorithm]CAML机器学习系列1:深入浅出ML之Regression家族
声明:本博客整理自博友@zhouyong计算广告与机器学习-技术共享平台,尊重原创,欢迎感兴趣的博友查看原文. 符号定义 这里定义<深入浅出ML>系列中涉及到的公式符号,如无特殊说明,符号 ...
- Atitit GRASP(General Responsibility Assignment Software Patterns),中文名称为“通用职责分配软件模式”
Atitit GRASP(General Responsibility Assignment Software Patterns),中文名称为"通用职责分配软件模式" 1. GRA ...
- 机器学习 - ML
CNCC - 2016 | 机器学习(原文链接) Machine Learning - ML,机器学习起源于人工智能,是AI的一个分支. 机器学习的理论基础:计算学习理论 - Computationa ...
随机推荐
- SpringMVC整合MongoDB
首先,在pom文件中新增spring-data-mongodb的依赖: <dependency> <groupId>org.springframework.data</g ...
- TSimpleMsgPack的样例代码
TSimpleMsgPack的样例代码 unit uMain; interface uses SimpleMsgPack, Windows, Messages, SysUtils, Variants, ...
- react/redux组件库、模板、学习教程
开源的有蚂蚁金服的: 1.https://pro.ant.design/index-cn 2.https://pro.ant.design/docs/getting-started-cn 3.http ...
- 深入理解vue路由的使用
vue-router是Vue.js官方的路由插件,它和vue.js是深度集成的,适合用于构建单页面应用.vue的单页面应用是基于路由和组件的,路由用于设定访问路径,并将路径和组件映射起来.传统的页面应 ...
- 如何在Linux中使用sFTP上传或下载文件与文件夹
如何在Linux中使用sFTP上传或下载文件与文件夹 sFTP(安全文件传输程序)是一种安全的交互式文件传输程序,其工作方式与 FTP(文件传输协议)类似. 然而,sFTP 比 FTP 更安全;它通过 ...
- java中finalkeyword
在java中有3个地方须要用finalkeyword: 1.假设一个不希望被继承,那么用final来修饰这个类 2.假设一个方法不须要被重写.那么这种方法用final来修饰 3.假设一个变量的值不希望 ...
- CSS规则的优先级匹配
CSS规则之间能够互相覆盖.这一点我们应该已经习以为常了.然而正是因为规则之间能够互相覆盖.子元素继承父元素的默认行为,导致了CSS冲突的问题. 碰到CSS冲突时.通常我们会增加一些更加具体的规则来明 ...
- centos7下memcached的安装配置
memcached 依赖 libevent-devel 首先安装libevent-devel yum -y install libevent-devel 安装完毕! 继续安装memcached yum ...
- canvas 五角星之回顾【初中三角函数】
当程序中遇到三角函数的时候我是懵逼的,于是百度了“初中三角函数”, 忘了这几个公式的,自己打脸. 目的是通过Canvas画一个五角星, 突破口:只要能通过给定的两个外圈点的半径,和内圈点的半径,借助上 ...
- 【caffe-windows】 caffe-master 之图片转换成lmdb or leveldb
前期准备: 文件夹train:此文件夹中按类别分好子文件夹,各子文件夹里存放相应图片 文件夹test:同train,有多少类就有多少个子文件夹 trainlabels.txt : 存的是训练集的标签 ...