
自学Python九 爬虫实战二(美图福利)
作为一个新世纪有思想有文化有道德时刻准备着的屌丝男青年,在现在这样一个社会中,心疼我大慢播抵制大百度的前提下,没事儿上上网逛逛YY看看斗鱼翻翻美女图片那是必不可少的,可是美图虽多翻页费劲!今天我们就搞个爬虫把美图都给扒下来!本次实例有2个:煎蛋上的妹子图,某网站的rosi图。我只是一个学习python的菜鸟,技术不可耻,技术是无罪的!!!
煎蛋:
先说说程序的流程:获取煎蛋妹子图URL,得到网页代码,提取妹子图片地址,访问图片地址并将图片保存到本地。Ready? 先让我们看看煎蛋妹子网页:

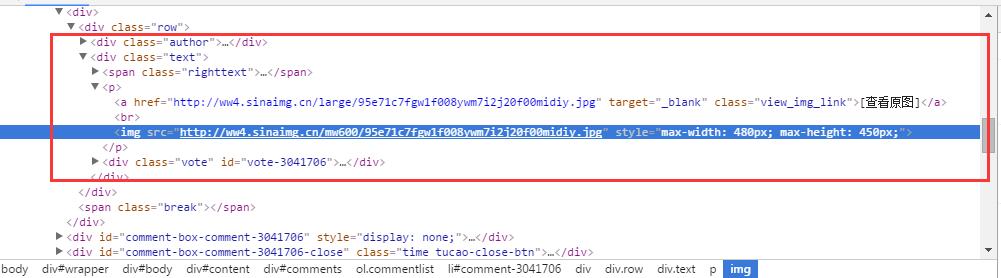
我们得到URL为:http://jandan.net/ooxx/page-1764#comments 1764就是页码, 首先我们要得到最新的页码,然后向前寻找,然后得到每页中图片的url。下面我们分析网站代码写出正则表达式!

根据之前文章的方法我们写出如下函数getNewPage:
 def __getNewPage(self):

         pageCode = self.Get(self.__Url)

         type = sys.getfilesystemencoding()

         pattern = re.compile(r'<div .*?cp-pagenavi">.*?<span .*?current-comment-page">\[(.*?)\]</span>',re.S)

         newPage = re.search(pattern,pageCode.decode("UTF-8").encode(type))

         print pageCode.decode("UTF-8").encode(type)

         if newPage != None:

             return newPage.group(1)

         return 1500
不要问我为什么如果失败返回1500。。。 因为煎蛋把1500页之前的图片都给吃了。 你也可以返回0。接下来是图片的
 def __getAllPicUrl(self,pageIndex):

         realurl = self.__Url + "page-" + str(pageIndex) + "#comments"

         pageCode = self.Get(realurl)

         type = sys.getfilesystemencoding()

         pattern = re.compile('<p>.*?<a .*?view_img_link">.*?</a>.*?<img src="(.*?)".*?</p>',re.S)

         items = re.findall(pattern,pageCode.decode("UTF-8").encode(type))

         for item in items:

             print item
好了,得到了图片地址,接下来就是访问图片地址然后保存图片了:
     def __savePics(self,img_addr,folder):

         for item in img_addr:

             filename = item.split('/')[-1]

             print "正在保存图片:" + filename

             with open(filename,'wb') as file:

                 img = self.Get(item)

                 file.write(img)
当你觉得信心满满的时候,一定会有一盆冷水浇到你的头上,毕竟程序就是这样,考验你的耐性,打磨你的自信。你测试了一会儿,然后你发现你重启程序后再也无法获取最新页码,你觉得我什么也没动啊为什么会这样。别着急,我们将得到的网页代码打印出来看看:

看到了吧,是服务器感觉你不像浏览器访问的结果把你的ip给屏蔽了。 真是给跪了,辛辛苦苦码一年,屏蔽回到解放前!那么这个如何解决呢,答:换ip 找代理。接下来我们要改一下我们的HttpClient.py 将里面的opener设置下代理服务器。具体代理服务器请自行百度之,关键字:http代理 。 想找到一个合适的代理也不容易 自己ie Internet选项挨个试试,测试下网速。
 # -*- coding: utf-8 -*-

 import cookielib, urllib, urllib2, socket

 import zlib,StringIO

 class HttpClient:

   __cookie = cookielib.CookieJar()

   __proxy_handler = urllib2.ProxyHandler({"http" : '42.121.6.80:8080'})#设置代理服务器与端口

   __req = urllib2.build_opener(urllib2.HTTPCookieProcessor(__cookie),__proxy_handler)#生成opener

   __req.addheaders = [

     ('Accept', 'application/javascript, */*;q=0.8'),

     ('User-Agent', 'Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; WOW64; Trident/5.0)')

   ]

   urllib2.install_opener(__req)

   def Get(self, url, refer=None):

     try:

       req = urllib2.Request(url)

       #req.add_header('Accept-encoding', 'gzip')

       if not (refer is None):

         req.add_header('Referer', refer)

       response = urllib2.urlopen(req, timeout=120)

       html = response.read()

       #gzipped = response.headers.get('Content-Encoding')

       #if gzipped:

       #    html = zlib.decompress(html, 16+zlib.MAX_WBITS)

       return html

     except urllib2.HTTPError, e:

       return e.read()

     except socket.timeout, e:

       return ''

     except socket.error, e:

       return ''
然后,就可以非常愉快的查看图片了。不过用了代理速度好慢。。。可以设置timeout稍微长一点儿,防止图片下载不下来!

好了,rosi的下篇文章再放!现在是时候上一波代码了:
 # -*- coding: utf-8 -*-

 import cookielib, urllib, urllib2, socket

 import zlib,StringIO

 class HttpClient:

   __cookie = cookielib.CookieJar()

   __proxy_handler = urllib2.ProxyHandler({"http" : '42.121.6.80:8080'})

   __req = urllib2.build_opener(urllib2.HTTPCookieProcessor(__cookie),__proxy_handler)

   __req.addheaders = [

     ('Accept', 'application/javascript, */*;q=0.8'),

     ('User-Agent', 'Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; WOW64; Trident/5.0)')

   ]

   urllib2.install_opener(__req)

   def Get(self, url, refer=None):

     try:

       req = urllib2.Request(url)

       req.add_header('Accept-encoding', 'gzip')

       if not (refer is None):

         req.add_header('Referer', refer)

       response = urllib2.urlopen(req, timeout=120)

       html = response.read()

       gzipped = response.headers.get('Content-Encoding')

       if gzipped:

           html = zlib.decompress(html, 16+zlib.MAX_WBITS)

       return html

     except urllib2.HTTPError, e:

       return e.read()

     except socket.timeout, e:

       return ''

     except socket.error, e:

       return ''

   def Post(self, url, data, refer=None):

     try:

       #req = urllib2.Request(url, urllib.urlencode(data))

       req = urllib2.Request(url,data)

       if not (refer is None):

         req.add_header('Referer', refer)

       return urllib2.urlopen(req, timeout=120).read()

     except urllib2.HTTPError, e:

       return e.read()

     except socket.timeout, e:

       return ''

     except socket.error, e:

       return ''

   def Download(self, url, file):

     output = open(file, 'wb')

     output.write(urllib2.urlopen(url).read())

     output.close()

 #  def urlencode(self, data):

 #    return urllib.quote(data)

   def getCookie(self, key):

     for c in self.__cookie:

       if c.name == key:

         return c.value

     return ''

   def setCookie(self, key, val, domain):

     ck = cookielib.Cookie(version=0, name=key, value=val, port=None, port_specified=False, domain=domain, domain_specified=False, domain_initial_dot=False, path='/', path_specified=True, secure=False, expires=None, discard=True, comment=None, comment_url=None, rest={'HttpOnly': None}, rfc2109=False)

     self.__cookie.set_cookie(ck)

 #self.__cookie.clear() clean cookie

 # vim : tabstop=2 shiftwidth=2 softtabstop=2 expandtab
HttpClient
 # -*- coding: utf-8 -*-

 from __future__ import unicode_literals

 from HttpClient import HttpClient

 import sys,re,os

 class JianDan(HttpClient):

     def __init__(self):

         self.__pageIndex = 1500 #之前的图片被煎蛋吞了

         self.__Url = "http://jandan.net/ooxx/"

         self.__floder = "jiandan"

     def __getAllPicUrl(self,pageIndex):

         realurl = self.__Url + "page-" + str(pageIndex) + "#comments"

         pageCode = self.Get(realurl)

         type = sys.getfilesystemencoding()

         pattern = re.compile('<p>.*?<a .*?view_img_link">.*?</a>.*?<img src="(.*?)".*?</p>',re.S)

         items = re.findall(pattern,pageCode.decode("UTF-8").encode(type))

         for item in items:

             print item

         self.__savePics(items,self.__floder)

     def __savePics(self,img_addr,folder):

         for item in img_addr:

             filename = item.split('/')[-1]

             print "正在保存图片:" + filename

             with open(filename,'wb') as file:

                 img = self.Get(item)

                 file.write(img)

     def __getNewPage(self):

         pageCode = self.Get(self.__Url)

         type = sys.getfilesystemencoding()

         pattern = re.compile(r'<div .*?cp-pagenavi">.*?<span .*?current-comment-page">\[(.*?)\]</span>',re.S)

         newPage = re.search(pattern,pageCode.decode("UTF-8").encode(type))

         print pageCode.decode("UTF-8").encode(type)

         if newPage != None:

             return newPage.group(1)

         return 1500

     def start(self):

         isExists=os.path.exists(self.__floder)#检测是否存在目录

         print isExists

         if not isExists:

             os.mkdir(self.__floder)

         os.chdir(self.__floder)

         page = int(self.__getNewPage())

         for i in range(self.__pageIndex,page):

             self.__getAllPicUrl(i)

 if __name__ == '__main__':

     jd = JianDan()

     jd.start()
JianDan
自学Python九 爬虫实战二(美图福利)的更多相关文章
- 自学Python十 爬虫实战三(美女福利续)
我又来送福利啦!!!不同于上篇文章,这次我们的爬虫采用了多线程,一直以来被所谓的分布式 多线程 爬虫 给唬的怕怕的.今天就来一发多线程爬虫吧,还能看妹子图,想想就觉得很激动!!! 依然是流程解释: ...
- Python网络爬虫实战(二)数据解析
上一篇说完了如何爬取一个网页,以及爬取中可能遇到的几个问题.那么接下来我们就需要对已经爬取下来的网页进行解析,从中提取出我们想要的数据. 根据爬取下来的数据,我们需要写不同的解析方式,最常见的一般都是 ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- 转 Python爬虫实战二之爬取百度贴吧帖子
静觅 » Python爬虫实战二之爬取百度贴吧帖子 大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 ...
- python网络爬虫实战PDF高清完整版免费下载|百度云盘|Python基础教程免费电子书
点击获取提取码:vg1y python网络爬虫实战帮助读者学习Python并开发出符合自己要求的网络爬虫.网络爬虫,又被称为网页蜘蛛,网络机器人,是一种按照一定的规则,自动地抓取互联网信息的程序或者脚 ...
- 关于Python网络爬虫实战笔记③
Python网络爬虫实战笔记③如何下载韩寒博客文章 Python网络爬虫实战笔记③如何下载韩寒博客文章 target:下载全部的文章 1. 博客列表页面规则 也就是, http://blog.sina ...
- 关于Python网络爬虫实战笔记①
python网络爬虫项目实战笔记①如何下载韩寒的博客文章 python网络爬虫项目实战笔记①如何下载韩寒的博客文章 1. 打开韩寒博客列表页面 http://blog.sina.com.cn/s/ar ...
- python多线程爬虫+批量下载斗图啦图片项目(关注、持续更新)
python多线程爬虫项目() 爬取目标:斗图啦(起始url:http://www.doutula.com/photo/list/?page=1) 爬取内容:斗图啦全网图片 使用工具:requests ...
- Python网络爬虫实战(一)快速入门
本系列从零开始阐述如何编写Python网络爬虫,以及网络爬虫中容易遇到的问题,比如具有反爬,加密的网站,还有爬虫拿不到数据,以及登录验证等问题,会伴随大量网站的爬虫实战来进行. 我们编写网络爬虫最主要 ...
随机推荐
- B.2 列表
从很多方面来说,列表是最简单也最自然的集合类型.框架中包含很多实现,具有各种功能 和性能特征.一些常用的实现在哪里都可以使用,而一些较有难度的实现则有其专门的使用场景. B.2.1 List< ...
- JAVA经典题--计算一个字符串中每个字符出现的次数
需求: 计算一个字符串中每个字符出现的次数 思路: 通过toCharArray()拿到一个字符数组--> 遍历数组,将数组元素作为key,数值1作为value存入map容器--> 如果k ...
- MySQL数据库操作(一)
一.数据操作 1.显示数据库 show databases; 2.创建数据库 #utf- create database 数据库名称 default charset utf8 collate utf8 ...
- BZOJ 1572 USACO 2009 Open 工作安排
先把工作按照Deadline从小到大排序 然后按顺序取,deadline大于现在总用时就取,等于现在总用时就从前面已取的工作中找一个P最小的同它比较,取P较大的一个 用优先队列维护已取工作中P的最小值 ...
- 洛谷 P2827 BZOJ 4721 UOJ #264 蚯蚓
题目描述 本题中,我们将用符号表示对c向下取整,例如:. 蛐蛐国最近蚯蚓成灾了!隔壁跳蚤国的跳蚤也拿蚯蚓们没办法,蛐蛐国王只好去请神刀手来帮他们消灭蚯蚓. 蛐蛐国里现在共有n只蚯蚓(n为正整数).每只 ...
- java.lang.ClassFormatError: Unknown constant tag 0 in class file
在通过文件上传之后,运行java程序,突然发现这么一个错误:java.lang.ClassFormatError: Unknown constant tag 0 in class file,通过网上查 ...
- 解决Android 应用方法数不能超过65K的问题
Conversion to Dalvik format failed:Unable toexecute dex: method ID not in [0, 0xffff]: 65536 假设你的应用出 ...
- UVa 263 - Number Chains
题目:给你一个数字n0.将它的每一个位的数字按递增排序生成数a,按递减排序生成数b, 新的数字为n1 = a-b,下次依照相同方法计算n1,知道出现循环,问计算了多少次. 分析:数论.模拟.直接模拟计 ...
- 蓝牙调试工具hcitool的使用实例【转】
本文转载自:http://blog.csdn.net/kangear/article/details/37961769 这个工具据说是基于BlueZ的,但是Android4.2以后不再采用BlueZ取 ...
- 0x6A 网络流初步
CH Round #17-C 这个算是一个技能点吧,不点不会,点了就没什么了.懒得写看书吧书上的1应该是0... 我又回来了太懒了不想翻书还是写写吧 必须边的判定条件:该边流量为0且两端的点在残余网络 ...