
tesseract-orc训练 结合python3图像识别验证码
##前言
其实就是用到tesseract-ocr这个引擎来识别,只不过我们需要做一些在此之前的工作
将图片用pillow进行初步处理,将图片中的验证码显示的清晰一些,关于这些教程可以查看我的另一篇文章(现在还没写)
然后用tesseract-ocr将处理完的图片进行识别,当然不训练tesseract-ocr是不行的,还需要对其进行训练,后面我会说明怎么训练
windows 平台
1.安装
######安装tesseract-ocr
地址: 点我点我!
注意:如果你要识别中文的需要在安装时把中文包勾选上
######安装python第三方库
我这里用的是python3,python3怎么安装我就不多说了。
安装必要的 python第三方库:
pip install Pillow pytesseract -i https://mirrors.aliyun.com/pypi/simple/
Pillow是一个python图像处理的第三方库
pytesseract 我的理解是调用刚才安装的tesseract-ocr的一个接口吧
######安装训练矫正的工具(jTessBoxEditorFX)
地址:点我点我!
2.编写python处理图片函数
######二值化
from PIL import Image

from pytesseract import *

im = Image.open('1.jpg') #用pil打开这个图片

im = im.convert('L')

im = im.point(lambda x: 0 if x<100 else x>=100, '1') # 二值化 100为分割灰度的点(阀值),二值化就是将图片的颜色转换成非黑即白的图片

im.show() #查看图片
图片资源
经过上述处理应该这样的生成图片
如果显示的图片中线没有去掉,可以调整阀值来去掉线
######去除噪点
把图片中的黑点去掉
def getPixel(image,x,y):

    L = image.getpixel((x,y)) #获取当前像素点的像素

    if L == 0:  #判读此像素点是否为黑,因为如果是白的就没必要处理了

        nearDots = 0  #初始化记录周围有没有黑像素数量的值

        #判断周围像素点

        if L - image.getpixel((x - 1,y - 1)):

            nearDots += 1

        if L - image.getpixel((x - 1,y)):

            nearDots += 1

        if L - image.getpixel((x - 1,y + 1)):

            nearDots += 1

        if L - image.getpixel((x,y - 1)):

            nearDots += 1

        if L - image.getpixel((x,y + 1)):

            nearDots += 1

        if L - image.getpixel((x + 1,y - 1)):

            nearDots += 1

        if L - image.getpixel((x + 1,y)):

            nearDots += 1

        if L - image.getpixel((x + 1,y + 1)):

            nearDots += 1

        if nearDots ==8: #这里如果周围八个全是白点那么就返回一个白点,实现去黑点的操作

            return  1

         #这里主要是有俩个黑点连在一起,所有周围会有七个黑点扩大范围进一步判断

        elif nearDots ==7:

            nearDots = 0

            if L - image.getpixel((x - 2,y - 2)):

                nearDots += 1

            if L - image.getpixel((x - 2,y)):

                nearDots += 1

            if L - image.getpixel((x - 2,y + 2)):

                nearDots += 1

            if L - image.getpixel((x,y - 2)):

                nearDots += 1

            if L - image.getpixel((x,y + 2)):

                nearDots += 1

            if L - image.getpixel((x + 2,y - 2)):

                nearDots += 1

            if L - image.getpixel((x + 2,y)):

                nearDots += 1

            if L - image.getpixel((x + 2,y + 2)):

                nearDots += 1

            if nearDots == 8:

                return 1 #返回白点

            else:

                return 0 #返回黑点

    else:

        return 1

def clearNoise(image):

    draw = ImageDraw.Draw(image)

    #循环遍历每个像素点

    for x in range(0,image.size[0]):

        for y in range(0,image.size[1]):

            color = getPixel(image,x,y)

            draw.point((x,y),color)

#将上一步处理完成的im对象传给clearNoise()函数

im = clearNoise(im)

im.show()
代码挺简单的应该可以看懂
不出意外的话处理完成的图片变成这样:
处理到这一步就已经可以了,当然你也可以进行进一步处理,例如局部放大
######调用 tesseract-ocr识别图片
在上面的代码中加入
# lang只用哪个库来识别 默认有个eng库,config 指代识别单行还是多行-psm 7只的是单行

result = pytesseract.image_to_string(im,lang='eng',config="-psm 7")

print(result)
不出意外的话识别结果应该是:o 3 o 4
但是我图像都已经处理到这一步了,怎么还识别出错??
答:因为你没有训练!
3.训练tesseract-ocr
######合成tif文件
打开安装的 Jtessboxedit ,点击tools——Merge TiFF然后选中经过处理的验证码图片(因为最终识别的是经过python处理完的,所以也拿处理完成的验证码来训练在原函数中加入im.save(保存路径)即可保存),随便找到另一个地方生成tif,命名为num.font.exp0.tif保存
注意:这里的文件名不是瞎起的,文件名有要求的,取和我相同的名字就行了,因为后面运行的命令都是依靠这个文件名的
######生成box文件
生成好后,进入tif文件所在的文件夹
运行命令
tesseract num.font.exp0.tif num.font.exp0 -psm 7 batch.nochop makebox
在文件夹就会生成一个 .box的文件
######训练
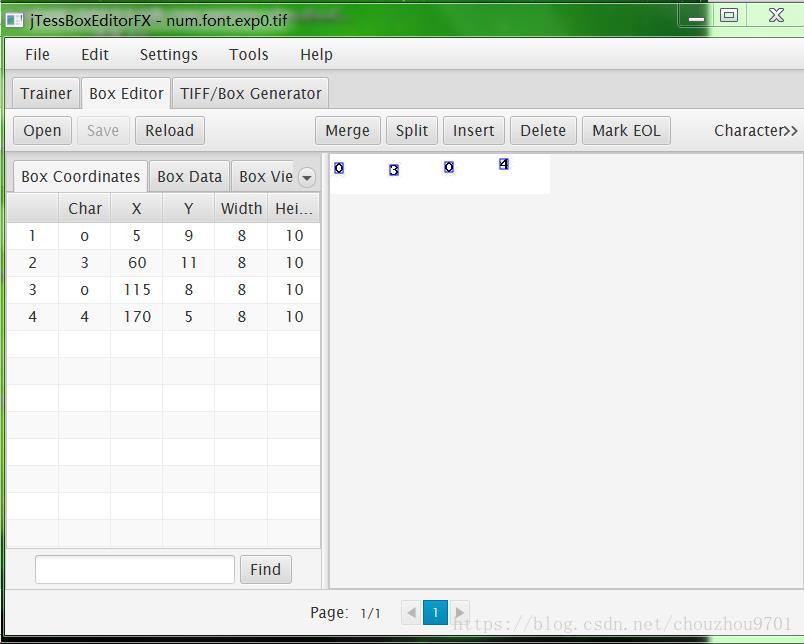
然后在jtessboxedit中Box Editor选项卡中点击open按钮打开上一步生成的tif文件
如果位置不对就调整x y,w,h的值,字符不对就修改字符,这里我把俩个o修改成0
然后save
######生成训练的库文件
进入到tif和box所在的文件夹
运行以下命令
tesseract.exe num.font.exp0.tif num.font.exp0 -psm 7 nobatch box.train

unicharset_extractor.exe num.font.exp0.box

echo font 0 0 0 0 0 > font_properties.txt

mftraining -F font_properties.txt -U unicharset -O num.unicharset num.font.exp0.tr

cntraining.exe num.font.exp0.tr

rename normproto num.normproto

rename inttemp num.inttemp

rename pffmtable num.pffmtable

rename shapetable num.shapetable

combine_tessdata.exe num.
把生成的num.traineddata这个文件拷贝到 你的C:\Program Files (x86)\Tesseract-OCR\tessdata下,大工告成!
4.用训练好的库来识别python处理后的图片
只需修改一下代码即可
asd = pytesseract.image_to_string(image,lang='num',config="-psm 7")#将eng修改为你训练好的库,也就是num
备注: 评论有几个人问我代码,相关代码已经上次到CSDN了(资源名称为 python验证码识别), 原本我想上传到github, 但是我觉得我的github不能放这种半成品的代码, 所以很抱歉, 现在属于审核中, 后期审核通过我会把地址放上的
tesseract-orc训练 结合python3图像识别验证码的更多相关文章
- python 简单图像识别--验证码
python 简单图像识别--验证码 记录下,准备工作安装过程很是麻烦. 首先库:pytesseract,image,tesseract,PIL windows安装PIL,直接exe进行安装更方便( ...
- Python3 识别验证码(opencv-python)
Python3 识别验证码(opencv-python) 一.准备工作 使用opencv做图像处理,所以需要安装下面两个库: pip3 install opencv-python pip3 insta ...
- tesseract 字体训练资料篇
tesseract 字体训练资料篇 1.制作.box档案文件. tesseract [lang].[fontname].exp[num].tif [lang].[fontname].exp[num] ...
- tesseract ocr训练 pt验证码
识别率有问题A大概率识别为n,因此需要训练,这里讲一下 如何训练 参考 java代码里边直接使用tess4j,是对tesseract的封装,但是如果要训练,还是需要在进行安装tesseract-ocr ...
- tesseract图像识别验证码:安装使用和避免坑
安装使用 https://blog.csdn.net/kk185800961/article/details/78747595 避免的坑 http://www.mamicode.com/info-de ...
- python图像识别--验证码
1.pip3 install pyocr 2.pip3 install pillow or easy_install Pillow 3.安装tesseract-ocr:http://jaist.dl. ...
- 【Tesseract】Tesseract 的训练流程
在泰迪杯A题中,我刚刚接触了Tesseact,其中训练字库中遇到了较多的问题.所以在此记录一下,也当做一个笔记,省得以后忘记. 为了方便 ,将tif命名格式设为[lang].[fontname].ex ...
- python3图像识别库安装与使用
pytesseract库的安装 因为用的win10,就直说windows上面的安装了.其实就是pip安装就完事了. $ pip install pytesseract 安装了这个还不算完,得安装Tes ...
- Python3 简单验证码识别思路及实例
1.介绍 在爬虫中经常会遇到验证码识别的问题,现在的验证码大多分计算验证码.滑块验证码.识图验证码.语音验证码等四种.本文就是识图验证码,识别的是简单的验证码,要想让识别率更高, 识别的更加准确就需要 ...
- OCR2:tesseract字库训练
由于tesseract的中文语言包“chi_sim”对中文字体或者环境比较复杂的图片,识别正确率不高,因此需要针对特定情况用自己的样本进行训练,提高识别率,通过训练,也可以形成自己的语言库. 工具: ...
随机推荐
- 第一行代码Android(第3版).pdf下载
2020年人民邮电出版社出版的图书 <第一行代码Android(第3版)>是2020年4月人民邮电出版社出版的图书,作者是郭霖. 封面: 内容简介: <第一行代码 Android 第 ...
- 【设计模式】Java设计模式 - 装饰者模式
Java设计模式 - 装饰者模式 不断学习才是王道 继续踏上学习之路,学之分享笔记 总有一天我也能像各位大佬一样 原创作品,更多关注我CSDN: 一个有梦有戏的人 准备将博客园.CSDN一起记录分享自 ...
- web字体浮在图像中央
在做项目的过程中遇到了需要将图像作为背景,将字体显示在图像中央需求. 尝试了两种做法: 第一种方法为设置一个div设置属性为relative固定这个框的位置,将图片铺在div块里. 在div再设一个d ...
- HashMap不安全后果及ConcurrentHashMap线程安全原理
Java集合HashMap不安全后果及ConcurrentHashMap 原理 目录 HashMap JDK7 HashMap链表循环造成死循环 HashMap数据丢失 JDK7 Concurrent ...
- 【Java面试】这应该是面试官最想听到的回答,Mysql如何解决幻读问题?
"Mysql如何解决幻读问题" 一个工作了4年小伙伴,去一个美团面试,遇到了这样一个问题. 大家好,我是Mic,一个工作了14年的Java程序员 关于这个问题,面试官想考察什么?我 ...
- Kubeadm搭建高可用(k8s)Kubernetes v1.24.0集群
文章转载自:https://i4t.com/5451.html 背景 Kubernetes 1.24新特性 从kubelet中移除dockershim,自1.20版本被弃用之后,dockershim组 ...
- 9个常用的Shell脚本
1.Dos 攻击防范(自动屏蔽攻击 IP) #!/bin/bash DATE=$(date +%d/%b/%Y:%H:%M) LOG_FILE=/usr/local/nginx/logs/demo2. ...
- 工厂里懂得mes和erp有发展吗?
在工厂里懂得MES.ERP肯定有发展啊,现在数字化转型.智能制造正当时,ERP.MES之类的系统是刚需,只是不同工厂启动的早晚有别,使用的系统不相同而已,但知识体系.逻辑.理念等大都是相通的.比如你熟 ...
- Morris 遍历实现二叉树的遍历
Morris 遍历实现二叉树的遍历 作者:Grey 原文地址: 博客园:Morris 遍历实现二叉树的遍历 CSDN:Morris 遍历实现二叉树的遍历 说明 Morris 遍历可以实现二叉树的先,中 ...
- RAID5 IO处理之replace代码详解
1 作用 从字面意思理解,replacement即是替换.我们知道硬盘都有一定的使用寿命,可以在硬盘失效之前通过该功能将就盘的数据迁移至新盘.因为replacement的流程是从旧盘中读出数据直接写入 ...