
elasticsearch之metric聚合
1、背景
此篇文章简单的记录一下 elasticsearch的metric聚合操作。比如求 平均值、最大值、最小值、求和、总计、去重总计等。
2、准备数据
2.1 准备mapping
PUT /index_person

{

  "settings": {

    "number_of_shards": 1

  },

  "mappings": {

    "properties": {

      "id":{

        "type": "long"

      },

      "name": {

        "type": "keyword"

      },

      "age": {

        "type": "integer"

      },

      "class":{

        "type": "text",

        "fielddata": true

      },

      "province":{

        "type": "keyword"

      }

    }

  }

}
2.2 准备数据
PUT /index_person/_bulk

{"index":{"_id":1}}

{"id":1, "name":"张三","age":18,"class":"大一班","province":"湖北"}

{"index":{"_id":2}}

{"id":2, "name":"李四","age":19,"class":"大一班","province":"湖北"}

{"index":{"_id":3}}

{"id":3, "name":"王武","age":20,"class":"大二班","province":"北京"}

{"index":{"_id":4}}

{"id":4, "name":"赵六","age":21,"class":"大三班技术班","province":"北京"}

{"index":{"_id":5}}

{"id":5, "name":"钱七","age":22,"class":"大三班","province":"湖北"}
3、metric聚合
3.1 max 平均值
3.1.1 dsl
POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "max": {

        "field": "age",

        "missing": 10

      }

    }

  }

}

POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "max": {

        "script": {

          "lang": "painless",

          "source": """

            doc.age

          """

        }

      }

    }

  }

}

POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "max": {

        "field": "age",

        "script": {

          "lang": "painless",

          "source": """

            _value * params.a

          """,

          "params": {

            "a": 2

          }

        }

      }

    }

  }

}
3.1.2 java代码
@Test

@DisplayName("最大值聚合")

public void test01() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_person")

                    .size(0)

                    .aggregations("agg_01", agg ->

                            agg.max(max ->

                                    // 聚合的字段

                                    max.field("age")

                                            // 如果聚合的文档缺失这个字段,则给10

                                            .missing(10)

                            )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}

@Test

@DisplayName("脚本聚合")

public void test02() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_person")

                    .size(0)

                    .aggregations("agg_01", agg ->

                            agg.max(max ->

                                    max.script(script ->

                                            script.inline(inline ->

                                                    inline.lang(ScriptLanguage.Painless)

                                                            // 脚本表达式

                                                            .source("doc.age")

                                            )

                                    )

                            )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}

@Test

@DisplayName("值脚本聚合")

public void test03() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_person")

                    .size(0)

                    .aggregations("agg_01", agg ->

                            agg.max(max ->

                                    // 指定参与聚合的字段

                                    max.field("age")

                                            .script(script ->

                                                    script.inline(inline ->

                                                            inline.lang(ScriptLanguage.Painless)

                                                                    // 脚本表达式

                                                                    .source("_value * params.plus")

                                                                    // 参数

                                                                    .params("plus", JsonData.of(2))

                                                    )

                                            )

                            )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}
3.2 min最小值
3.2.1 dsl
POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "min": {

        "field": "age",

        "missing": 10

      }

    }

  }

}
3.2.2 java
POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "min": {

        "field": "age",

        "missing": 10

      }

    }

  }

}
3.3 min最小值
3.3.1 dsl
POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "avg": {

        "field": "age",

        "missing": 10

      }

    }

  }

}
3.3.2 java
@Test

@DisplayName("平均值聚合")

public void test01() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_person")

                    .size(0)

                    .aggregations("agg_01", agg ->

                            agg.avg(avg ->

                                    // 聚合的字段

                                    avg.field("age")

                                            // 如果聚合的文档缺失这个字段,则给10

                                            .missing(10)

                            )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}
3.4 min最小值
3.4.1 dsl
POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "sum": {

        "field": "age",

        "missing": 10

      }

    }

  }

}
3.4.2 java
@Test

@DisplayName("求和聚合")

public void test01() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_person")

                    .size(0)

                    .aggregations("agg_01", agg ->

                            agg.sum(sum ->

                                    // 聚合的字段

                                    sum.field("age")

                                            // 如果聚合的文档缺失这个字段,则给10

                                            .missing(10)

                            )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}
3.5 count(*)
3.5.1 dsl
POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "value_count": {

        "field": "province",

        "missing": 10

      }

    }

  }

}
3.5.2 java
@Test

@DisplayName("count(*)聚合")

public void test01() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_person")

                    .size(0)

                    .aggregations("agg_01", agg ->

                            agg.valueCount(valueCount ->

                                    // 聚合的字段

                                    valueCount.field("age")

                                            // 如果聚合的文档缺失这个字段,则给10

                                            .missing(10)

                            )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}
3.6 count(distinct)
3.6.1 dsl
POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "cardinality": {

        "field": "province",

        "missing": 10

      }

    }

  }

}
3.6.2 java
@Test

@DisplayName("count(distinct)聚合")

public void test01() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_person")

                    .size(0)

                    .aggregations("agg_01", agg ->

                            agg.cardinality(cardinality ->

                                    // 聚合的字段

                                    cardinality.field("province")

                                            // 如果聚合的文档缺失这个字段,则给10

                                            .missing(10)

                            )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}
3.7 stat (max,min,avg,count,sum)
3.7.1 dsl
POST /index_person/_search

{

  "size": 0,

  "query": {

    "match_all": {}

  },

  "aggs": {

    "agg_01": {

      "stats": {

        "field": "avg",

        "missing": 10

      }

    }

  }

}
3.7.2 java
@Test

@DisplayName("stat聚合")

public void test01() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_person")

                    .size(0)

                    .aggregations("agg_01", agg ->

                            agg.stats(stats ->

                                    // 聚合的字段

                                    stats.field("age")

                                            // 如果聚合的文档缺失这个字段,则给10

                                            .missing(10)

                            )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}
3.8 聚合后返回每个聚合涉及的文档
3.8.1 需求
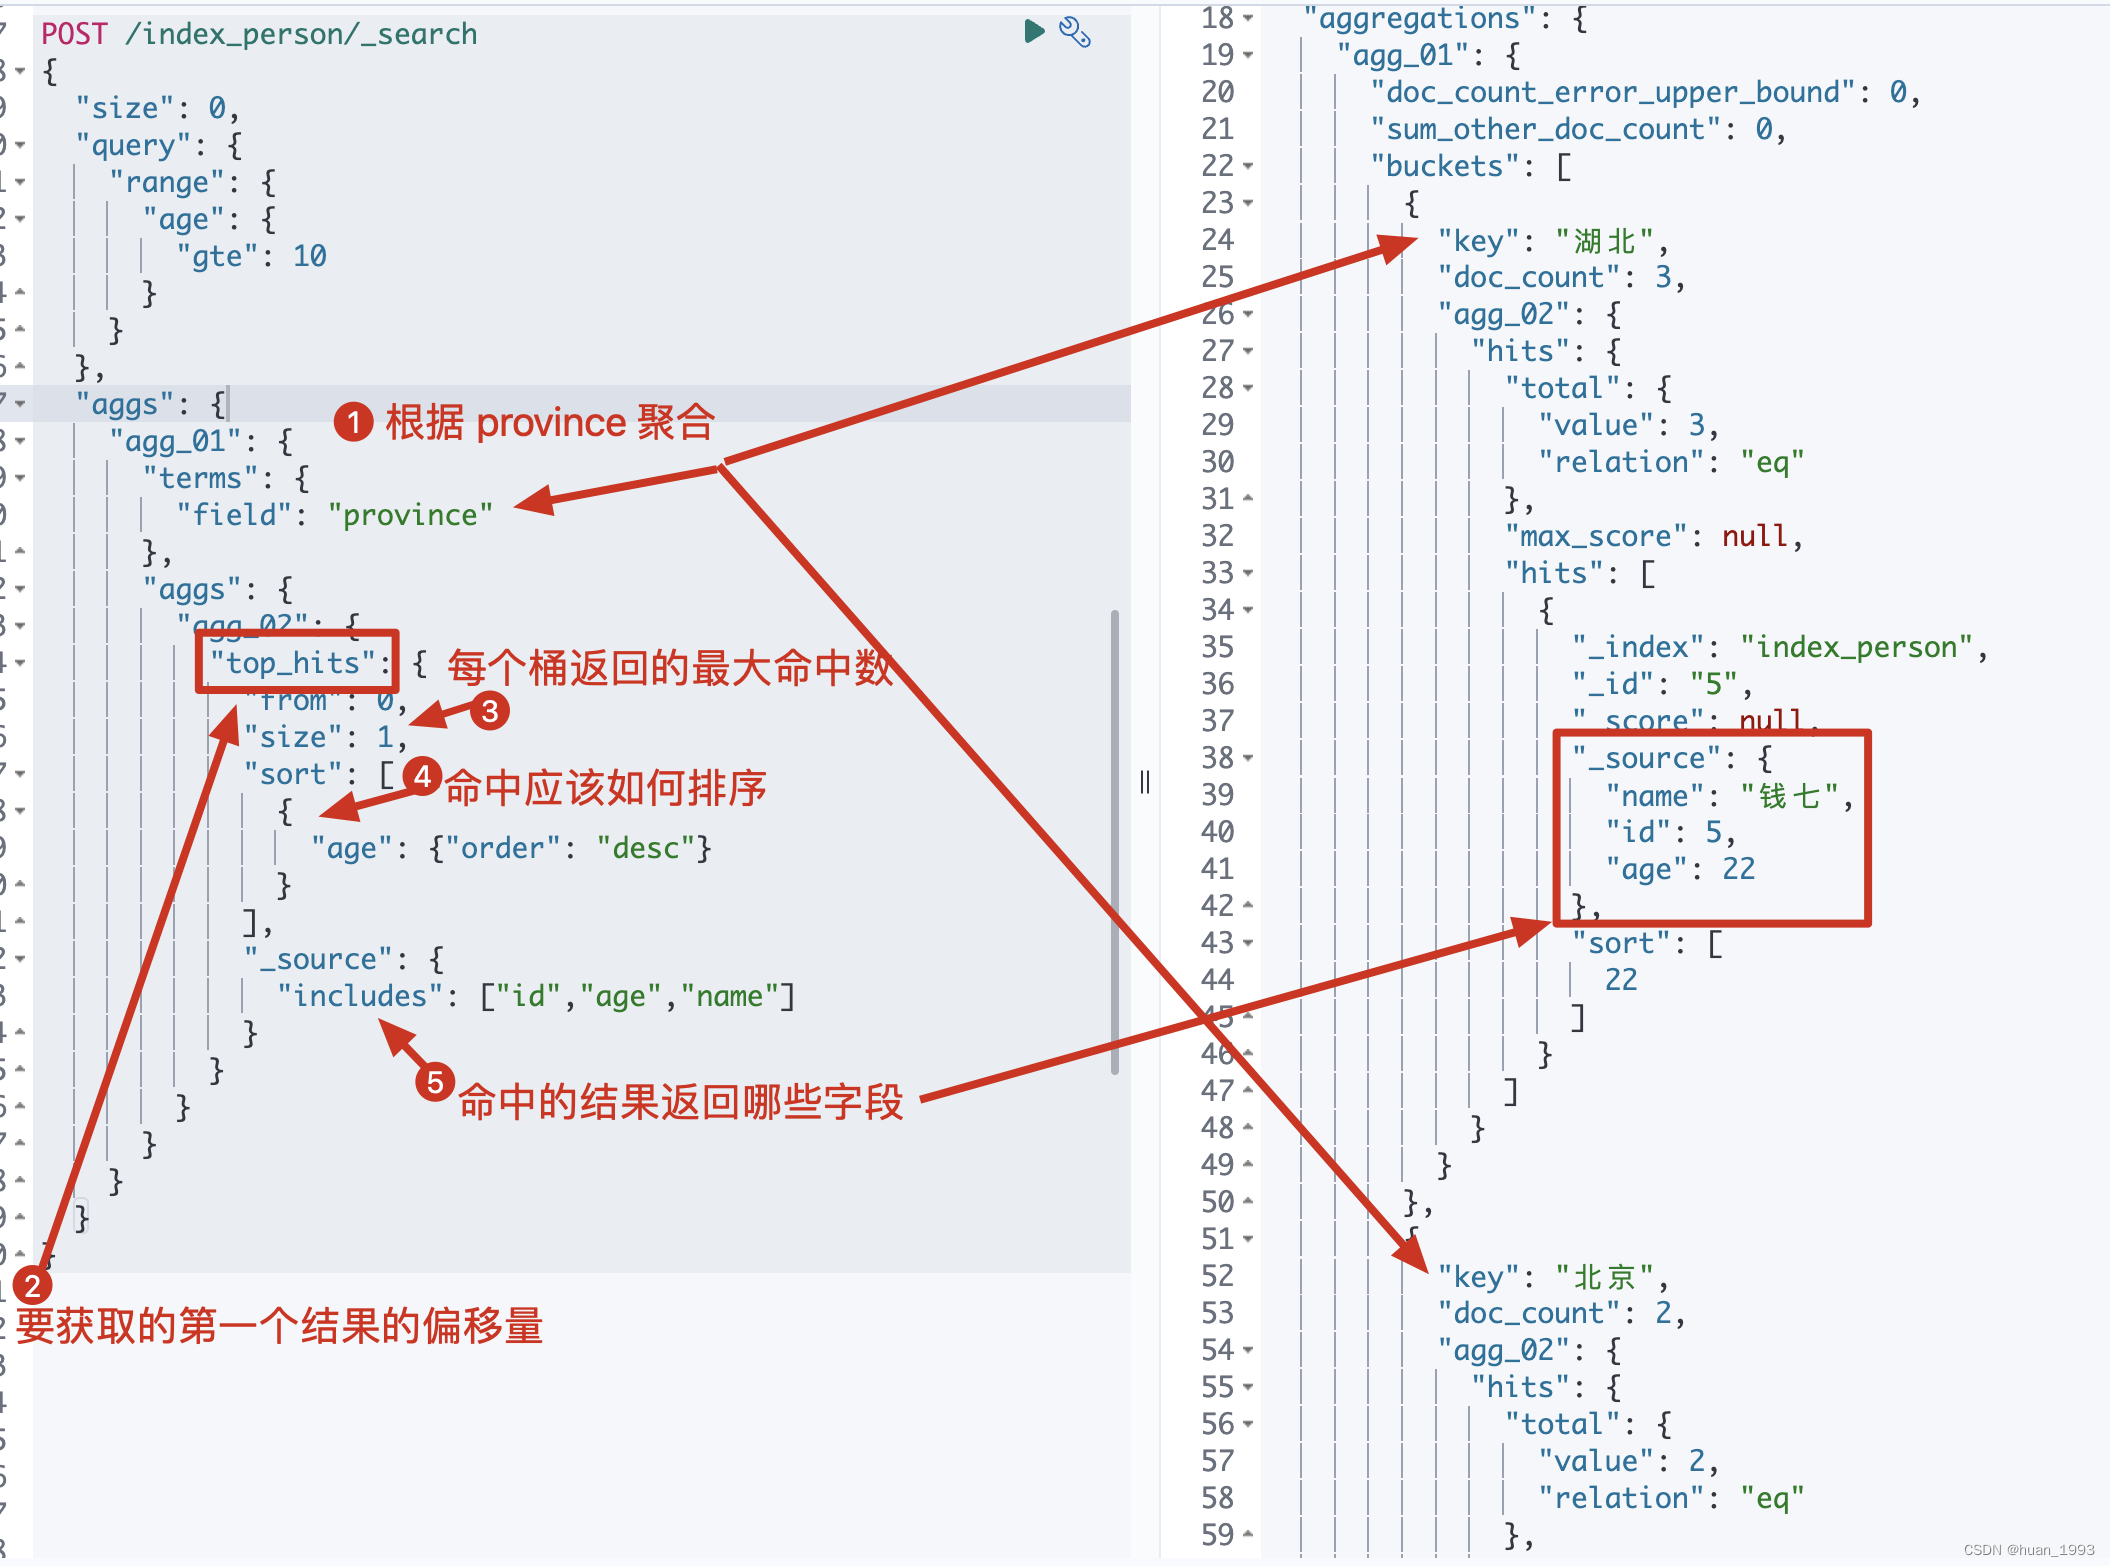
根据 province进行terms聚合,然后获取每个terms聚合 age最大的那个文档。
3.8.2 dsl
POST /index_person/_search

{

  "size": 0,

  "query": {

    "range": {

      "age": {

        "gte": 10

      }

    }

  },

  "aggs": {

    "agg_01": {

      "terms": {

        "field": "province"

      },

      "aggs": {

        "agg_02": {

          "top_hits": {

            "from": 0,

            "size": 1,

            "sort": [

              {

                "age": {"order": "desc"}

              }

            ],

            "_source": {

              "includes": ["id","age","name"]

            }

          }

        }

      }

    }

  }

}
3.8.3 java
@Test

@DisplayName("top hits 聚合")

public void test01() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_person")

                    .size(0)

                    .query(query -> query.range(range -> range.field("age").gt(JsonData.of(10))))

                    .aggregations("agg_01", agg ->

                            agg.terms(terms ->

                                            terms.field("province")

                                    )

                                    .aggregations("agg_02", subAgg ->

                                            subAgg.topHits(topHits ->

                                                    topHits.from(0)

                                                            .size(1)

                                                            .sort(sort -> sort.field(field -> field.field("age").order(SortOrder.Desc)))

                                                            .source(source -> source.filter(filter -> filter.includes(Arrays.asList("id", "age", "name"))))

                                            )

                                    )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}
3.8.4 运行结果
4、完整代码
5、参考文档
elasticsearch之metric聚合的更多相关文章
- Elasticsearch(8) --- 聚合查询(Metric聚合)
Elasticsearch(8) --- 聚合查询(Metric聚合) 在Mysql中,我们可以获取一组数据的 最大值(Max).最小值(Min).同样我们能够对这组数据进行 分组(Group).那么 ...
- ElasticSearch实战系列五: ElasticSearch的聚合查询基础使用教程之度量(Metric)聚合
Title:ElasticSearch实战系列四: ElasticSearch的聚合查询基础使用教程之度量(Metric)聚合 前言 在上上一篇中介绍了ElasticSearch实战系列三: Elas ...
- Elasticsearch Metric聚合
首先查看index文档信息 $ curl -XGET "http://172.16.101.55:9200/_cat/indices?v" 输出 health status ind ...
- java使用elasticsearch分组进行聚合查询(group by)-项目中实际应用
java连接elasticsearch 进行聚合查询进行相应操作 一:对单个字段进行分组求和 1.表结构图片: 根据任务id分组,分别统计出每个任务id下有多少个文字标题 .SQL:select id ...
- elasticsearch 权威指南聚合阅读笔记(七)
count(1) select clssId,count(1) from student group by classId { "size":0, "aggs" ...
- 读《深入理解Elasticsearch》点滴-聚合-top_hits
以下是官网手册(部分)(v5.1) 直接直接看官网手册 https://www.elastic.co/guide/en/elasticsearch/reference/5.1/search-aggre ...
- python 使用 elasticsearch 常用方法(聚合)
#记录聚合查询方法 from elasticsearch import Elasticsearch es = Elasticsearch(['xx.xx.xx.xx:9200']) #获取最小的年龄r ...
- 小试牛刀ElasticSearch大数据聚合统计
ElasticSearch相信有不少朋友都了解,即使没有了解过它那相信对ELK也有所认识E即是ElasticSearch.ElasticSearch最开始更多用于检索,作为一搜索的集群产品简单易用绝对 ...
- Elasticsearch强大的聚合功能Facet
在常规数据库中,我们都知道有一个sql就是group,分组.如果主表只有对应的一个列记录的分组的ID,那么还好统计,比如说每本书book表,有一个分类catId,记录是属于哪一类的书,那么直接按照ca ...
- elasticsearch按范围聚合
范围聚合适用于对数据按照指定范围进行分类聚合的应用场景,from和to表示范围起始值的半开半闭区间(包含from值不包含to值),key表示别名 如 {:key=>"2h", ...
随机推荐
- Redis核心设计原理(深入底层C源码)
Redis 基本特性 1. 非关系型的键值对数据库,可以根据键以O(1) 的时间复杂度取出或插入关联值 2. Redis 的数据是存在内存中的 3. 键值对中键的类型可以是字符串,整型,浮点型等,且键 ...
- python实验报告(第五周)
一.实验目的和要求 学会使用字符串的常用操作方法和正确应用正则表达式. 二.实验环境 软件版本:Python 3.10 64_bit 三.实验过程 1.实例1:使用字符串拼接输出一个关于程序员的笑话 ...
- 关于maven插件在Myeclipse中的使用
出现了如下几个错误: 1.访问不到maven的中央仓库,插件下载失败,无法使用插件启动tomcat命令. 解决方法到 maven的配置文件中,一般在我的文档中的.m2文件中的settting.xml中 ...
- Taurus.MVC 微服务框架 入门开发教程:项目部署:7、微服务节点的监控与告警。
系统目录: 本系列分为项目集成.项目部署.架构演进三个方向,后续会根据情况调整文章目录. 开源地址:https://github.com/cyq1162/Taurus.MVC 本系列第一篇:Tauru ...
- C语言------循环结构I
文章目录 1 .实训名称 2 .实训目的及要求 3 .源代码及运行截图 4 .小结 1 .实训名称 实训5:循环结构I 2 .实训目的及要求 1 .熟练掌握while.do-while和for语句实现 ...
- 如何实现一个SQL解析器
作者:vivo 互联网搜索团队- Deng Jie 一.背景 随着技术的不断的发展,在大数据领域出现了越来越多的技术框架.而为了降低大数据的学习成本和难度,越来越多的大数据技术和应用开始支持SQL进 ...
- Codeforces Round #751 (Div. 2)/CodeForces1602
CodeForces1602 Two Subsequences 解析: 题目大意 给你一个字符串 \(s\).你需要两个非空字符串 \(a\) 和 \(b\) 并且满足下面的条件: 字符串 \(a\) ...
- 解决ffmpeg的播放摄像头的延时优化问题(项目案例使用有效)
在目前的项目中使用了flv的播放摄像头的方案,但是延时达到了7-8秒,所以客户颇有微词,没有办法,只能开始优化播放延时的问题,至于对接摄像头的方案有好几种,这种咱们以后在聊,今天只要聊聊聊优化参数的问 ...
- LVS综合实验
LVS综合实验 1.环境准备 提前准备:Mysql8.0.30安装包.Mysql安装脚本.shopxo2.3.0安装包.DNS脚本 服务器 IP地址 作用 系统版本 Mysql-master 10.0 ...
- Kafka 架构和原理机制 (图文全面详解)
目录 一:Kafka 简介 二:Kafka 基本架构 三:Kafka 基本原理 四:Zookeeper 在 kafka 的作用 五:Kafka 的特性 六:Kafka 的应用场景 一:Kafka 简介 ...