
lec-5-Policy Gradients
直接策略微分
- Goal:
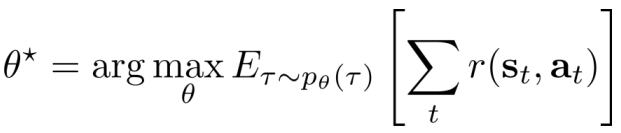
- idea:求最大值:直接求导
- tip:利用log导数等式进行变换
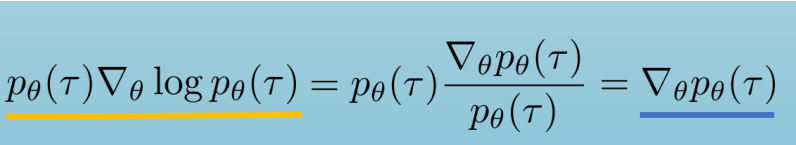
- 具体推导:
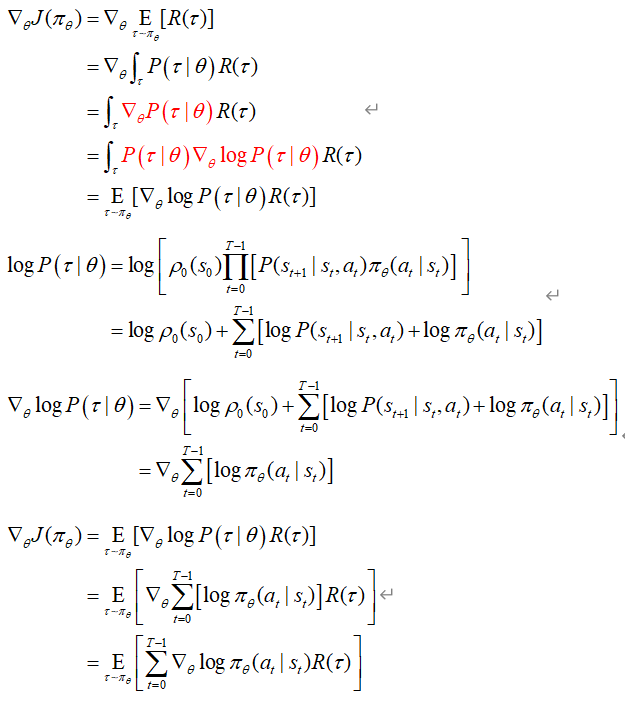
理解策略梯度
假定开始policy服从高斯分布,采样得到回报,计算梯度,根据reward增加动作概率,改变policy分布
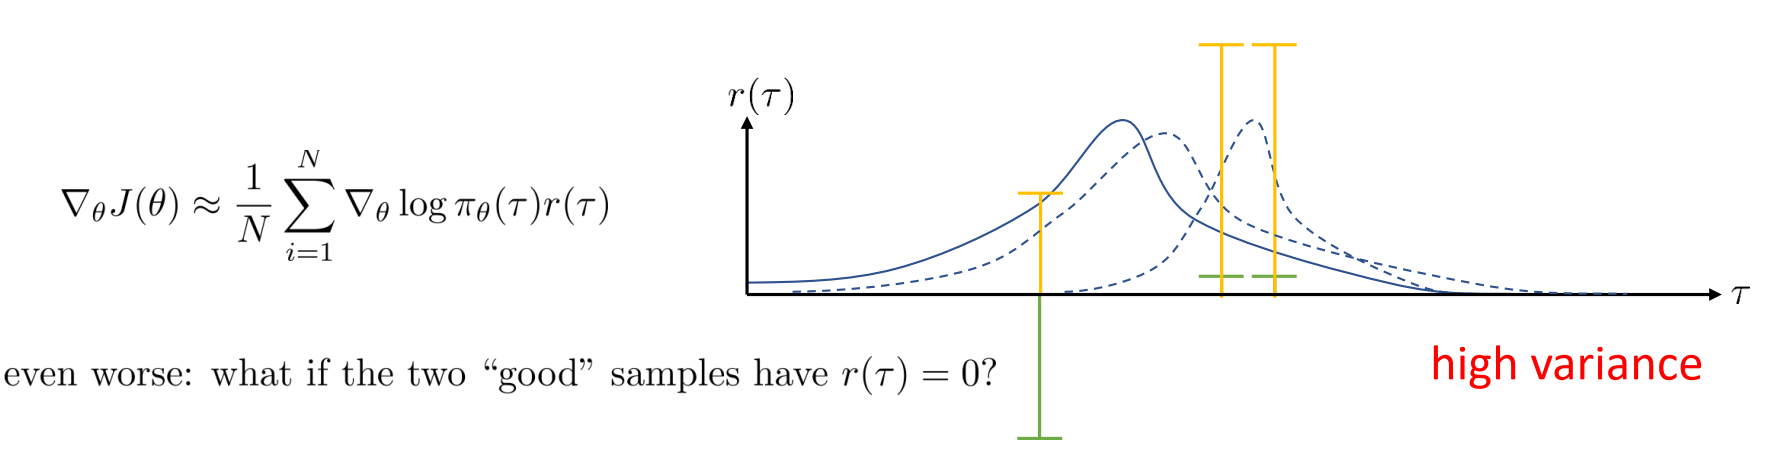
- 会发生的错误:高方差
- 当采样有负奖励样本的时候(绿色奖励),原本policy改变向右移动更多(最右边的虚曲线);改变奖励(添加常量),变为正奖励(黄色奖励),向右移动的少了(中间虚曲线),从而这导致了高差异(相比于之前的曲线)。
- 如果对于无限样本,不会导致差异。
- 如果回报为0,那么它们的policy梯度就不重要。
减少方差
- 因果关系:放弃过去的回报,policy不会影响t之前的回报
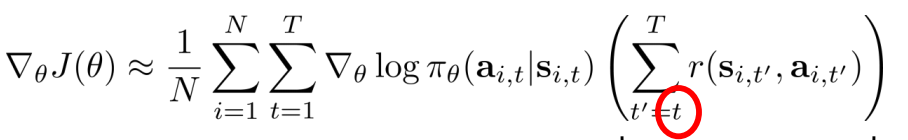
- Baselines:不会改变期望值,会改变方差
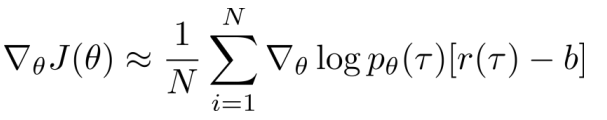
一般取b为回报均值: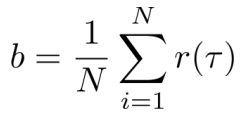 【but使得方差最小(即方差为0)的b不是回报均值】
Off-policy PG
- REINFORCE algorithm(on-policy)
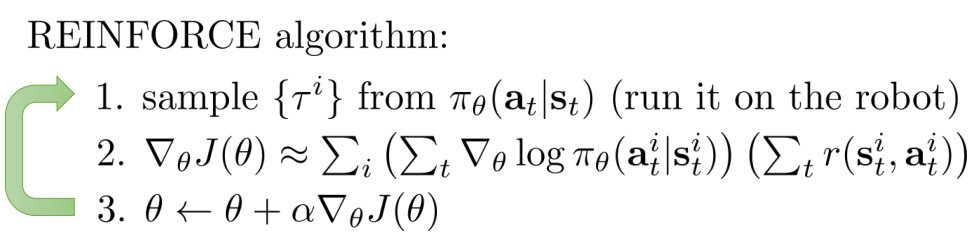
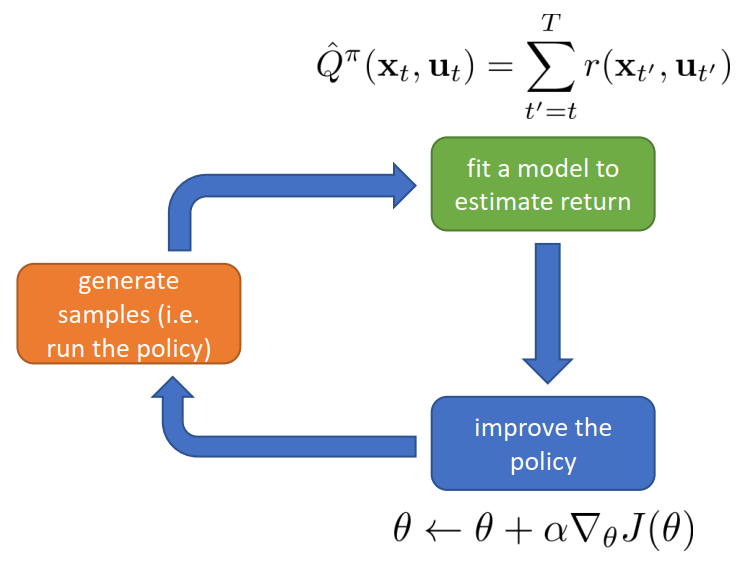
- 缺点:每次改进参数都要扔掉样本(样本利用率低);单步梯度更新
- 在基本RL过程中的表示:
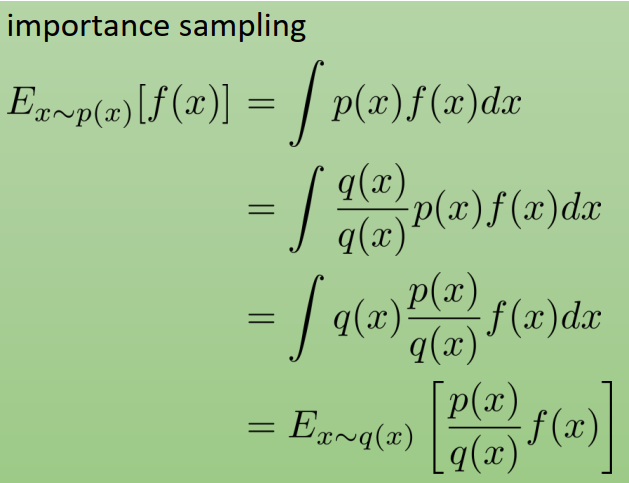
- 重要性采样原理(IS):实现从on-policy到off-policy
- 原理:
- 应用于RL:重用以前的policy(用 旧policy 进行采样,然后改进参数)
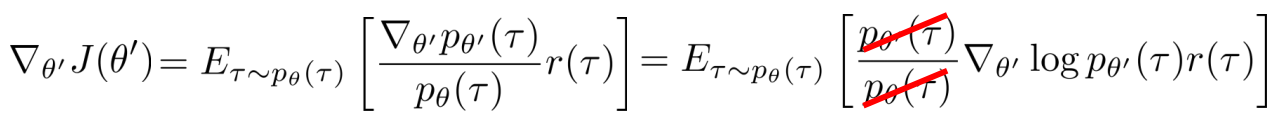
- 原理:
- 应用
- 使用自动差分器:伪loss进行反向传播
- 实际要考虑
- 梯度的高方差
- 批量学习batch size
- 学习率的调整learning rate
- 优化器的选择optimizers
Advanced PG
- 学习率的难题
policy参数服从高斯分布,梯度总会趋向于更小的方差的方向移动,方差就成了决定性因素,均值就不动了,梯度速度就慢了,继而收敛慢了。故学习率调整的难题,如果 速度小,学习率大,会使得policy在均值方向上很快不动。 - 自然梯度
- 自动步长调整
.....
Resource:CS285官网资料
版权归原作者 Lee_ing 所有
未经原作者允许不得转载本文内容,否则将视为侵权;转载或者引用本文内容请注明来源及原作者
lec-5-Policy Gradients的更多相关文章
- (zhuan) Deep Deterministic Policy Gradients in TensorFlow
Deep Deterministic Policy Gradients in TensorFlow AUG 21, 2016 This blog from: http://pemami49 ...
- 几句话总结一个算法之Policy Gradients
强化学习与监督学习的区别在于,监督学习的每条样本都有一个独立的label,而强化学习的奖励(label)是有延后性,往往需要等这个回合结束才知道输赢 Policy Gradients(PG)计算某个状 ...
- Policy Gradient Algorithms
Policy Gradient Algorithms 2019-10-02 17:37:47 This blog is from: https://lilianweng.github.io/lil-l ...
- (转)RL — Policy Gradient Explained
RL — Policy Gradient Explained 2019-05-02 21:12:57 This blog is copied from: https://medium.com/@jon ...
- (转) How to Train a GAN? Tips and tricks to make GANs work
How to Train a GAN? Tips and tricks to make GANs work 转自:https://github.com/soumith/ganhacks While r ...
- (转) Deep Learning Research Review Week 2: Reinforcement Learning
Deep Learning Research Review Week 2: Reinforcement Learning 转载自: https://adeshpande3.github.io/ad ...
- (转) Deep Reinforcement Learning: Pong from Pixels
Andrej Karpathy blog About Hacker's guide to Neural Networks Deep Reinforcement Learning: Pong from ...
- [Reinforcement Learning] 强化学习介绍
随着AlphaGo和AlphaZero的出现,强化学习相关算法在这几年引起了学术界和工业界的重视.最近也翻了很多强化学习的资料,有时间了还是得自己动脑筋整理一下. 强化学习定义 先借用维基百科上对强化 ...
- 花十分钟,让你变成AI产品经理
花十分钟,让你变成AI产品经理 https://www.jianshu.com/p/eba6a1ca98a4 先说一下你阅读本文可以得到什么.你能得到AI的理论知识框架:你能学习到如何成为一个AI产品 ...
- 学习笔记TF037:实现强化学习策略网络
强化学习(Reinforcement Learing),机器学习重要分支,解决连续决策问题.强化学习问题三概念,环境状态(Environment State).行动(Action).奖励(Reward ...
随机推荐
- jQuery下载步骤以及相关使用
jQuery下载 进入相关网址执行下载操作,网址在这里:http://www.jq22.com/jquery-info122 进入页面之后,页面的左侧,会有这样的显示: 我们需要自主在这里选择自己需要 ...
- operator简介
原理 operator 是一种 kubernetes 的扩展形式,利用自定义资源对象(Custom Resource)来管理应用和组件,允许用户以 Kubernetes 的声明式 API 风格来管理应 ...
- PMP常见会议小结
转载请注明出处: 会议是吸引项目团队和其他干系人参与的重要方式.它们是整个项目的主要沟通方式. 一. 项目启动会 召开时间:是启动阶段结束时召开的会议. 主要任务:发布项目章程,并任命项目经理,赋予项 ...
- MyBatis中的#和$有什么区别
什么是MyBatis MyBatis是一款优秀的持久层框架,特别是在国内(国外据说还是 Hibernate 的天下)非常的流行,我们常说的SSM组合中的M指的就是#mybatis#. MyBatis支 ...
- ros系统(1)
在虚拟机上安装好ros系统之后,打开终端,启动ROS Master,输入roscore命令,结果如下: 再启动小海龟仿真器,输入命令:rosrun turtlesim turtlesim_node,结 ...
- 快速傅里叶变换应用(FFT Applications)
1. 3-SUM 1.1 问题描述 Given three sets \(X\), \(Y\), and $Z $ of \(n\) integers each, determine whether ...
- MySQL 主从复制的问题及解决方案
更多内容,前往 IT-BLOG 复制功能是构建 MySQL 的大规模.高性能的基础,也就是所谓的 "水平扩展" 架构.我们可以通过为服务器配置一个或多个备库.同时,复制也是高可用性 ...
- Zookeeper 从入门到精通
更多内容,前往IT-BLOG 一.Zookeeper概述 Zookeeper是一个开源的分布式的,为分布式应用提供协调服务的Apache项目.Zookeeper从设计模式角度来理解:是一个基于观察者模 ...
- 鼎捷ERP二维码整体解决方案 Tiptop GP条码管理系统 鼎捷ERP移动解决方案 鼎捷条码扫描 鼎捷WMS仓库移动扫码 鼎捷安卓PDA扫码方案 Tiptop 出入库盘点出货条码扫码 提供源码
本人在ERP实施公司做顾问四五年,参与企业实施ERP十多个项目,非常熟悉企业ERP流程,在实施过程遇到众多问题,提出了不少根据企业具体情况的解决方案. 最近定制开发了一套适合企业的条码扫码平台,基于鼎 ...
- [JavaScript]Promise:异步编程
1 文由 某项目的需求:先要请求API1,再以API1的结果请求API2. var n, a; //var r = window.md5; var r = function (password, us ...