
Hadoop集群搭建-05安装配置YARN
先保证集群5台虚拟机,
| nn1 | nn2 | s1 | s2 | s3 | |
|---|---|---|---|---|---|
| hadoop | 是 | 是 | 是 | 是 | 是 |
| zookeeper | 是 | 是 | 是 | ||
| namenode | 是 | 是 | |||
| jouralnode | 是 | 是 | |||
| datanode | 是 | 是 | 是 |
1.然后启动yarn在nn1机器上:
[hadoop@nn1 hadoop]$ start-yarn.sh
然后查看各节点信息
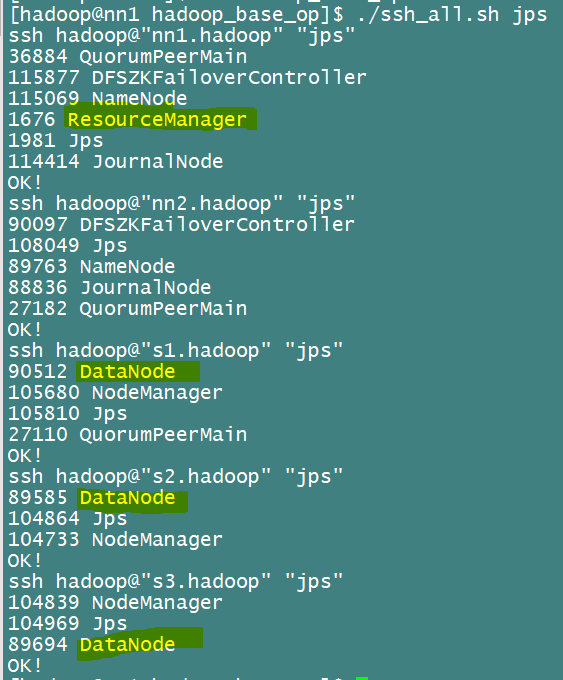
2.配置yarn的HA高可用
高可用就是好几台机器,一台突然挂掉了,其他机器就补上去,刚刚只启动了nn1作为yarn服务器,只有一台,所以这里要在nn2也开一台,来做简单的高可用
###############在nn2控制台操作####################

[hadoop@nn2 ~]$ yarn-daemon.sh start resourcemanager
如图查看jps
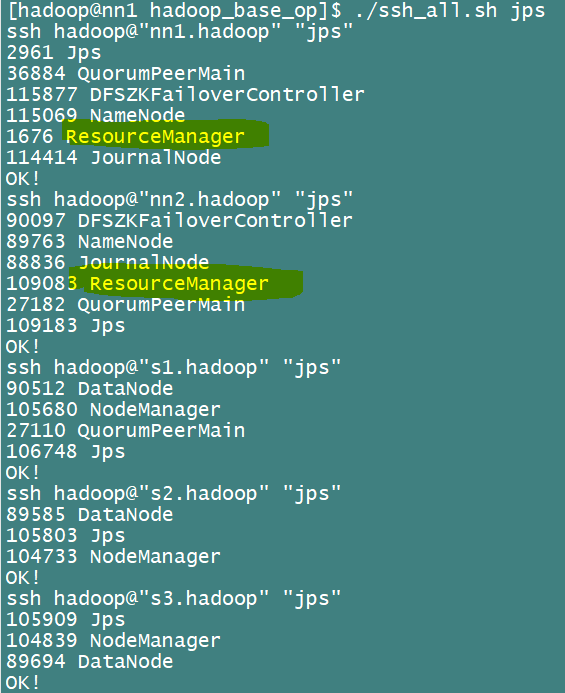
这里相比第一张图,在nn2多了一个resourceManager
##########查看状态############

[hadoop@nn1 hadoop_base_op]$ yarn rmadmin -getServiceState rm1

active

[hadoop@nn1 hadoop_base_op]$ yarn rmadmin -getServiceState rm2

standby
打开网页查看http://192.168.10.6:8088/cluster
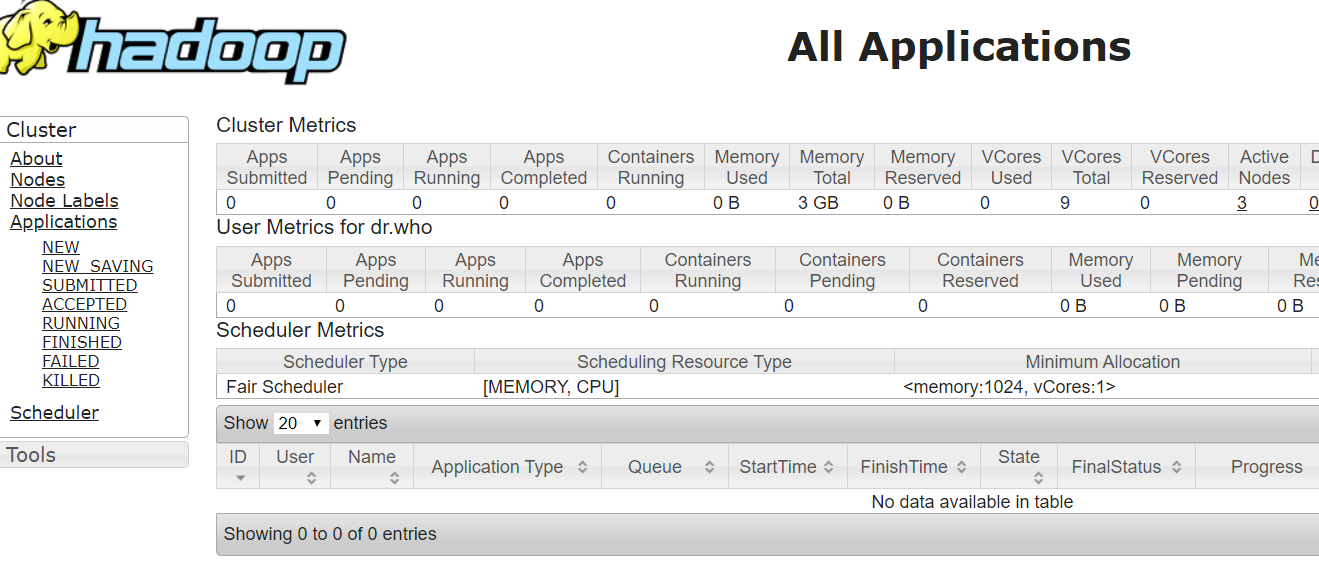
出现hadoop页面就是成功了,这时候因为nn1是active状态,所以你输入http://192.168.10.7:8088/cluster的话,或自动跳转到active机器,也就是自动跳转到nn1的ip上。
启动成功
来,跑个任务试试
用这个集群进行简单的wordcount任务
创建两个文件
vim abc1

aa bbb abc

aa aa

aa bb

aa cc aa

vim abc2

张三 张 三

张

三 张
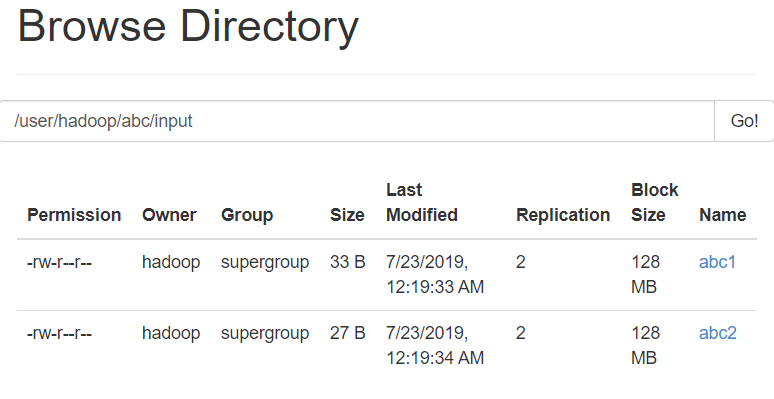
把这两个文件上传到hadoop的hdfs上
[hadoop@nn1 ~]$ hadoop fs -mkdir -p /user/hadoop/abc/input

[hadoop@nn1 ~]$ hadoop fs -put ./abc* /user/hadoop/abc/input
查看网页端:
扔到MR里执行下
[hadoop@nn1 ~]$ hadoop jar /usr/local/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.3.jar wordcount /user/hadoop/abc/input /user/hadoop/abc/output
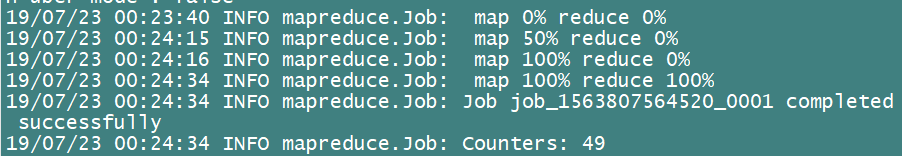
查看网页端的状态展示:
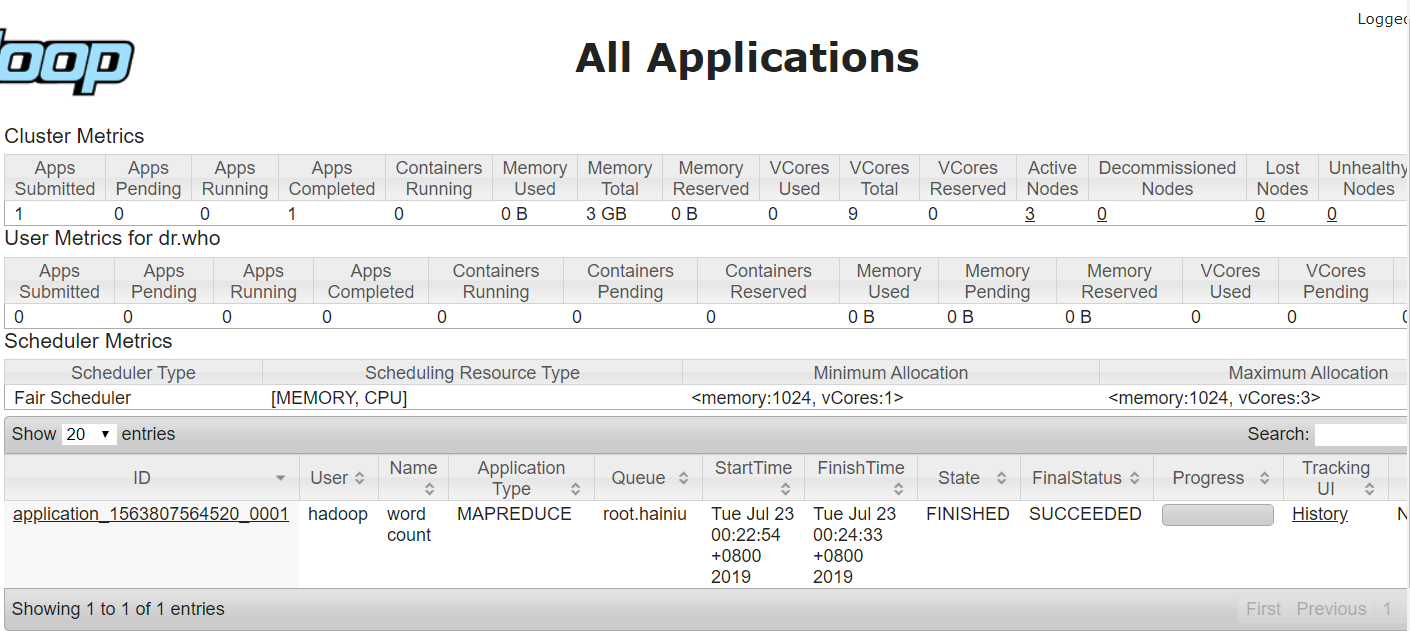
然后我们去hadoop那里查看结果文件
[hadoop@nn1 ~]$ hadoop fs -cat /user/hadoop/abc/output/part-r-00000
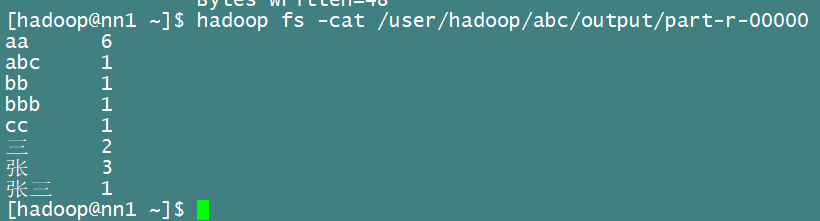
大功告成!!!
Hadoop集群搭建-05安装配置YARN的更多相关文章
- Hadoop集群搭建-04安装配置HDFS
Hadoop集群搭建-05安装配置YARN Hadoop集群搭建-04安装配置HDFS Hadoop集群搭建-03编译安装hadoop Hadoop集群搭建-02安装配置Zookeeper Hado ...
- Hadoop集群搭建-02安装配置Zookeeper
Hadoop集群搭建-05安装配置YARN Hadoop集群搭建-04安装配置HDFS Hadoop集群搭建-03编译安装hadoop Hadoop集群搭建-02安装配置Zookeeper Hado ...
- 基于Hadoop集群搭建Hive安装与配置(yum插件安装MySQL)---linux系统《小白篇》
用到的安装包有: apache-hive-1.2.1-bin.tar.gz mysql-connector-java-5.1.49.tar.gz 百度网盘链接: 链接:https://pan.baid ...
- Linux下Hadoop集群环境的安装配置
1)安装Ubuntu或其他Linux系统: a)为减少错误,集群中的主机最好安装同一版本的Linux系统,我的是Ubuntu12.04. b)每个主机的登陆用户名也最好都一样,比如都是hadoop,不 ...
- Hadoop集群搭建(六)~安装JDK
前面集群的准备工作都做完了,本篇记录安装JDK,版本位1.8 1,在opt目录下创建software和module文件夹:software用来放安装包,module为安装目录 2,把JDK和hadoo ...
- Hadoop集群搭建的密钥配置SSH实现机制的配置(2)
[hadoop@weekend110 ~]$ ssh-keygen -t rsa 用来生产密钥对 Generating public/private rsa key pair. Enter file ...
- Hadoop集群搭建-虚拟机安装(转)(一)
1.软件准备 a).操作系统:CentOS-7-x86_64-DVD-1503-01 b).虚拟机:VMware-workstation-full-9.0.2-1031769(英文原版先安装) VM ...
- Hadoop集群搭建的密钥配置SSH实现机制
- Hadoop集群搭建-03编译安装hadoop
Hadoop集群搭建-05安装配置YARN Hadoop集群搭建-04安装配置HDFS Hadoop集群搭建-03编译安装hadoop Hadoop集群搭建-02安装配置Zookeeper Hado ...
随机推荐
- [Luogu] 无线网络发射器选址
https://www.luogu.org/problemnew/show/P2038 二维前缀和 #include <iostream> #include <cstdio> ...
- Codeforces 1009 F. Dominant Indices(长链剖分/树上启发式合并)
F. Dominant Indices 题意: 给一颗无向树,根为1.对于每个节点,求其子树中,哪个距离下的节点数量最多.数量相同时,取较小的那个距离. 题目: 这类题一般的做法是树上的启发式合并,复 ...
- Error creating bean with name 'persistenceExceptionTranslationPostProcessor' defined in class path resource [org/springframework/boot/autoconfigure/dao/PersistenceExceptionTranslationAutoConfiguration
dubbo 包和SpringBoot 冲突,注释就可以正常启动
- LVS之ipvsadm命令
目录: 安装 基本描述 用法 命令选项 示例 [安装] 可使用yum安装或者从官网下载安装包源码安装,两种方式皆可 先检查是否已经安装ipvsadm [root@v_machine1 ~]# yum ...
- volatile写读的内存语义
1,当写一个volatile变量时,JMM(java内存模型)会把该线程本地内存中的所有共享变量刷新到主内存中去 2,当读取一个volatile变量时,该线程会将本地内存置为无效,线程将从主内存中读取 ...
- jetbrains 2019 激活 error 1653219 解决办法
我以前用PyCharm按照http://idea.lanyus.com/上的激活码直接可激活. 后来用到IDEA(最新版)了之后激活报错.错误代码为1653219. 后参考博客 解决办法: 把host ...
- 用单元测试来调试SilverFish AI
[TestFixture] public class AiTest { [Test] public void Test() { Settings.Instance.LogFolderPath = @& ...
- react-hook设定定时器的方法
const useInterval = (callback, delay) => { const savedCallback = useRef(); // 保存新回调 useEffect(() ...
- mysql数据库索引和引擎
1. 数据库索引 1.1 索引作用 当我们在数据库表中查询数据时,若没有索引,会逐个遍历表格中的所有记录,表格中数据记录量大时很耗时.建立索引就像创建目录一样,直接通过索引找到数据存储位置,加快查找. ...
- 查一张表占多少空间Bytes
SELECT SUM(BYTES)/1024/1024||'MB' 占用空间 FROM dba_segments WHERE segment_name = '表名' AND owner = '用户名' ...