
Python-选择器Xpath,Css,Re
正则表达式(特殊字符)
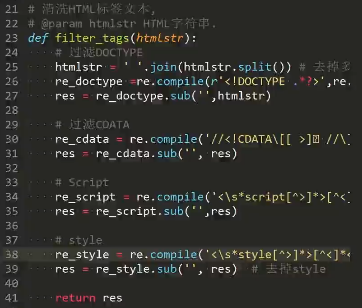
chrome控制台搜索:$x('//*[@id="body_container"]/div[3]/div[2]/div/div/a[1]/@href')
^                            开头  '^b.*'----以b开头的任意字符

$                            结尾  '^b.*3$'----以b开头,3结尾的任意字符

*                            任意长度(次数),≥0

?                            非贪婪模式,非贪婪模式尽可能少的匹配所搜索的字符串  '.*?(b.*?b).*'----从左至右第一个b和的二个b之间的内容(包含b)

+                            一次或多次

{2}                          指定出现次数2次

{2,}                         出现次数≥2次

{2,5}                        出现次数2≤x≤5

|                            或   “z|food”----能匹配“z”或“food”(此处请谨慎)。“[z|f]ood”----则匹配“zood”或“food”或"zood"

[]                           括号中任意一个符合即可(中括号里面没有分转义字符)  '[abc]ooby123'----只要开头符合[]中任意一个即可

[^]                          只要不出现[]的即可

[a-Z]                        从小a到大Z

.                            任意字符

\s                           匹配不可见字符 \n \t  '你\s好'----可以匹配‘你 好’

\S                           匹配可见字符,即普通字符

\w                           匹配下划线在内的任何单词字符

\W                           和上一个相反

[\u4E00-\u9FA5]              只能匹配汉字

()                           要取出的信息就用括号括起来

\d                           数字
寻找2个字或者3个字的XX市或者XXX区 
re.findall(re.compile('([\u4e00-\u9fa5]{2}市|[\u4e00-\u9fa5]{2}区|[\u4e00-\u9fa5]{3}市|[\u4e00-\u9fa5]{3}区)', re.S),
[\u4e00-\u9fa5]过滤中文
Xpath
article                      选取所有article元素的所有子节点

/article                     选取根元素article

article/a                    选取所有属于article的子元素的a元素

//div                        选取所有div子元素(不论出现在文档任何地方)

article//div                 选取所有属于article元素的后代的div元素不管它出现在article之下的任何位置

//@class                     选取所有名为class的属性

/article/div[1]              选取属于srticle子元素的第一个div所有子节点

/article/div[last()]         选取属于article子元素的最后一个div所有子节点

/article/div[last()-1]       选取属于article子元素的倒数第二个div所有子节点

//div[@lang]                 选取所有拥有lang属性的div元素

//div[@lang='eng']           选取所有lang属性为eng的div元素

/div/*                       选取属于div元素的所有子节点

//*                          选取所有元素

//div[@*]                    选取所有带属性的div元素

//div/a | //div/p            选取所有div元素的a个p元素

//span | //ul                选取文档中的span和ul元素

article/div/p | //span       选取所有属于article元素的div元素和所有的span元素
1. 取得文章标题

>>> title = response.xpath('//div[@class="entry-header"]/h1/text()')

>>> title

[<Selector xpath='//div[@class="entry-header"]/h1/text()' data='2016 腾讯软件开发面试题(部分)'>]

>>> title.extract()

['2016 腾讯软件开发面试题(部分)']

>>> title.extract()[0]

'2016 腾讯软件开发面试题(部分)'

>>> title.extract_first()

'2016 腾讯软件开发面试题(部分)'
>>> response.xpath("//p[@class='entry-meta-hide-on-mobile']/text()").extract()[0].strip().replace("·","").strip()

'2017/02/18'
>>> response.xpath("//span[contains(@class, 'vote-post-up')]/h10/text()").extract()

['2']

>>> response.xpath("//span[contains(@class, 'vote-post-up')]/h10/text()").extract()[0]

'2'

>>> int(response.xpath("//span[contains(@class, 'vote-post-up')]/h10/text()").extract()[0])

2
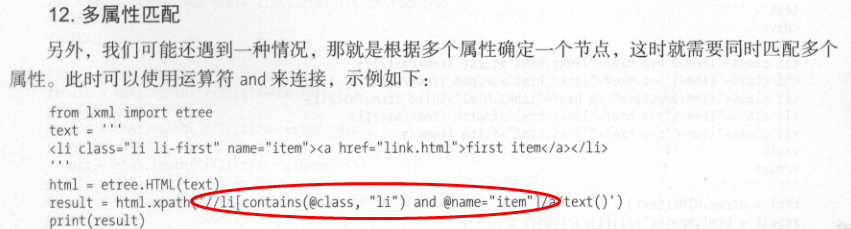
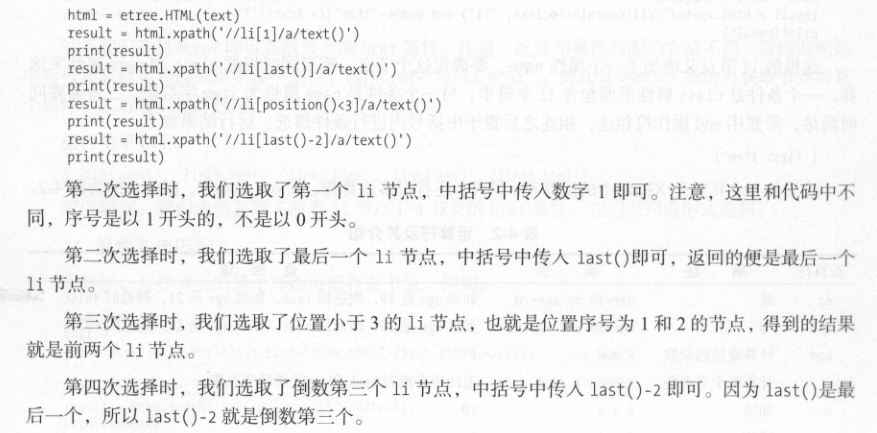
Xpath函数
>>> response.xpath("//span[contains(@class, 'bookmark-btn')]/text()").extract()[0]

' 28 收藏'

>>> string = response.xpath("//span[contains(@class, 'bookmark-btn')]/text()").extract()[0]

>>> import re

>>> pattern = re.match(".*?(\d+).*", string)

>>> pattern.group(1)

'28'
可以简写为
>>> response.xpath("//span[contains(@class, 'bookmark-btn')]/text()").re('.*?(\d+).*')

['28']

>>> response.xpath("//span[contains(@class, 'bookmark-btn')]/text()").re('.*?(\d+).*')[0]

'28'
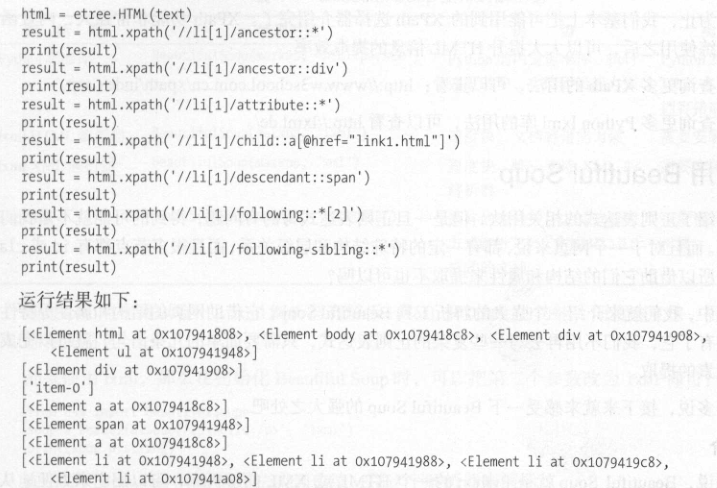
节点轴选择
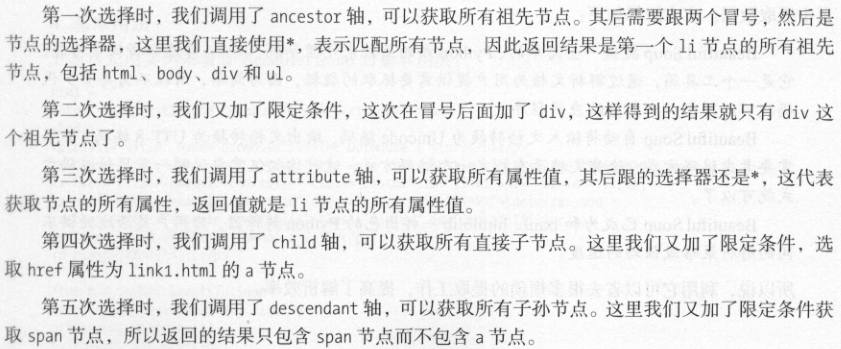
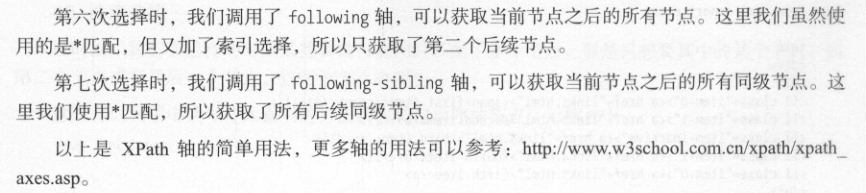
找到不是以"评论"结尾的元素

>>> response.xpath("//p[@class='entry-meta-hide-on-mobile']/a/text()").extract()

['职场', ' 9 评论 ', '面试']

>>> tag_list = response.xpath("//p[@class='entry-meta-hide-on-mobile']/a/text()").extract()

>>> [element for element in tag_list if not element.strip().endswith("评论")]

['职场', '面试']

>>> tag_choose=[element for element in tag_list if not element.strip().endswith("评论")]

>>> tags=",".join(tag_choose)

>>> tags

'职场,面试'
- Element类型是'lxml.etree._Element',某种意义来说同时是一个列表
- 列表的需要使用tag\attrib\text三个不同的属性来获取我们需要的东西
- 变量.tag获取到的是标签名是---字符串
- 变量.attrib获取到的是节点标签a的属性---字典
- 变量.text获取到的是标签文本--字符串
xpath表格中取值
Ptable_items = response.xpath("//div[@class='Ptable']/div[@class='Ptable-item']/dl/dl")

        others = {}

        for item in Ptable_items:

            dt = item.xpath("./dt/text()").extract_first().strip()

            dd = item.xpath("./dd/text()").extract_first().strip()

            if "机身内存" in dt:

                if not one.get("capacity", ""):

                    one["capacity"] = dd

            elif "颜色分类" in dt:

                if not one.get("color", ""):

                    one["color"] = dd
Xpath string()提取多个子节点中的文本
<div>

    <ul class="show">

        <li>275万购昌平邻铁三居 总价20万买一居</li>

        <li>00万内购五环三居 140万安家东三环</li>

        <li>北京首现零首付楼盘 53万购东5环50平</li>

        <li>京楼盘直降5000 中信府 公园楼王现房</li>

    </ul>

</div>
我想要把所有li标签中的文本提取出来,并且放到一个字符串中.
在网上查了下发现使用xpath的string()函数可以实现(string()和text()的区别请自行google)
先看下常见的方法:
>>> from lxml import etree

...

>>> result = html.xpath("//div/ul[@class='show']")[0]

>>> result.xpath('string(.)')

 '                 275万购昌平邻铁三居 总价20万买一居                 00万内购五

环三居 140万安家东三环                 北京首现零首付楼盘 53万购东5环50平

  京楼盘直降5000 中信府 公园楼王现房             '
这是我查到的多数人使用的方法,还有人使用了concat()函数,更麻烦就不提了.
但是上面的匹配明显感觉可以写到一条xpath里面的,为什么非要分开写!忍不住吐槽一下
xpath string()函数的调用写法:
>>> html.xpath("string(//div/ul[@class='show'])")

'                 275万购昌平邻铁三居 总价20万买一居                 00万内购五

环三居 140万安家东三环                 北京首现零首付楼盘 53万购东5环50平

京楼盘直降5000 中信府 公园楼王现房 '再吐槽下上面那种写法.在xpath语法里面,点(.)表示当前节点,当前节点不就是html.xpath("//div/ul[@class='show']")[0]取到的节点元素吗!!!
Css
*                            选取所有节点

#container                   选取id为container的节点

.container                   选取所有class包含container的节点

li a                         选取所有li下的所有a节点

ul+p                         选取ul后面的第一个p元素

div#container > ul           选取id为container的div的第一个ul子元素

ul ~ p                       选取与ul相邻的所有p元素

a[title]                     选取所有有title属性的a元素

a[href="http://jobbole.com"] 选取所有href属性为jobbole.com

a[href*="jobole"]            选取所有href属性包含jobbole的a元素

a[href^="http"]              选取所有href属性值以http开头的a元素

a[href$=".jpg"]              选取所有href属性值以.jpg结尾的a元素

input[type=radio]:checked    选取选中的radio的元素

div:not(#container)          选取所有id非container的div元素

li:nth-child(3)              选取第三个li元素

tr:nth-child(2n)             第偶数个tr元素
^ 开头 '^b.*'----以b开头的任意字符$ 结尾 '^b.*3$'----以b开头,3结尾的任意字符 * 任意长度(次数),≥0? 非贪婪模式,非贪婪模式尽可能少的匹配所搜索的字符串 '.*?(b.*?b).*'----从左至右第一个b和的二个b之间的内容(包含b)+ 一次或多次{2} 指定出现次数2次{2,} 出现次数≥2次{2,5} 出现次数2≤x≤5| 或 “z|food”----能匹配“z”或“food”(此处请谨慎)。“[z|f]ood”----则匹配“zood”或“food”或"zood"[] 括号中任意一个符合即可(中括号里面没有分转义字符) '[abc]ooby123'----只要开头符合[]中任意一个即可[^] 只要不出现[]的即可[a-Z] 从小a到大Z. 任意字符\s 匹配不可见字符 \n \t '你\s好'----可以匹配‘你 好’\S 匹配可见字符,即普通字符\w 匹配下划线在内的任何单词字符\W 和上一个相反[\u4E00-\u9FA5] 只能匹配汉字() 要取出的信息就用括号括起来\d 数字Python-选择器Xpath,Css,Re的更多相关文章
- scrapy简单入门及选择器(xpath\css)
简介 scrapy被认为是比较简单的爬虫框架,资料比较齐全,网上也有很多教程.官网上介绍了它的四种安装方法,PyPI.Conda.APT.Source,我们只介绍最简单的安装方法. 安装 Window ...
- Python中Scrapy框架元素选择器XPath的简单实例
原文标题:<Python网络爬虫-Scrapy的选择器Xpath> 对原文有所修改和演绎 优势 XPath相较于CSS选择器,可以更方便的选取 没有id class name属性的标签 属 ...
- CSS选择器 + Xpath + 正则表达式整理(有空再整理)
选择器 例子 例子描述 CSS .class .intro 选择 class="intro" 的所有元素. 1 #id #firstname 选择 id="firstna ...
- 【Python全栈-CSS】CSS入门
CSS入门教程 参考: http://www.cnblogs.com/yuanchenqi/articles/5977825.html http://www.ruanyifeng.com/blog/2 ...
- python beautifulsoup/xpath/re详解
自己在看python处理数据的方法,发现一篇介绍比较详细的文章 转自:http://blog.csdn.net/lingojames/article/details/72835972 20170531 ...
- Web自动化测试:xpath & CSS Selector定位
Xpath 和 CSS Selector简介 CSS Selector CSS Selector和Xpath都可以用来表示XML文档中的位置.CSS (Cascading Style Sheets)是 ...
- CSS选择器优先级 CSS权值
计算指定选择器的优先级:重新认识CSS的权重 标签的权值为 0,0,0,1 类的权值为 0,0,1,0 属性选择的权值为 0,0,1,1 ID的权值为 0,1,0,0 important的权值为最高 ...
- CSS active选择器与CSS hover选择器
<!DOCTYPE HTML> <html lang="en-US"> <head> <meta charset="UTF-8& ...
- [Selenium] 在Chrome的开发者工具中验证检查XPath/CSS selectors
Evaluate and validate XPath/CSS selectors in Chrome Developer Tools Method 1 : From Elements panel U ...
- python爬虫xpath的语法
有朋友问我正则,,okey,其实我的正则也不好,但是python下xpath是相对较简单的 简单了解一下xpath: XPath 是一门在 XML 文档中查找信息的语言.XPath 可用来在 XML ...
随机推荐
- springboot 出现 Connection refused: connect
总结网上的方法再结合我自己的方法 1. springCloud com.sun.jersey.api.client.ClientHandlerException: java.net.ConnectEx ...
- hdu 3037——Saving Beans
Saving Beans Time Limit: 6000/3000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others)Tota ...
- 使用nginx部署网站
前面的话 如果服务器只需要放置一个网站程序,解析网站到服务器的网站,网站程序监听80端口就可以了.如果服务器有很多应用,借助nginx不仅可以实现端口的代理,还可以实现负载均衡.本文将详细介绍前端及n ...
- Win10 + Ubuntu双系统,删除Ubuntu系统
之前在电脑上装了win10 + ubuntu的双系统,偶尔会出问题,所以还是选择将ubuntu系统删掉. 正所谓“请神容易送神难”,安装ubuntu的时候,过程还算顺利,但是在删除Ubuntu的过程中 ...
- kubernetes 创建用户配置文件来访问集群API
创建一个账号 kubectl create serviceaccount def-ns-admin 绑定集群权限 kubectl create rolebinding def-ns-admin --c ...
- 【Spring】Spring Data JPA
原始JDBC操作数据库 传统JDBC方式实现数据库操作 package com.imooc.util; import java.io.InputStream; import java.sql.*; i ...
- 题解 UVA1567 【A simple stone game】
题目大意 一堆石子有n个,首先第一个人开始可以去1~
- Java中String连接性能的分析【转】
[转]http://www.blogjava.net/javagrass/archive/2010/01/24/310650.html 总结:如果String的数量小于4(不含4),使用String. ...
- Redis配置sentinel模式
Redis配置sentinel模式 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 哨兵(sentinel)主要是完成三个功能:监控,通知,自动故障转移功能.sentinel是安装R ...
- NLP相关问题中文本数据特征表达初探
1. NLP问题简介 0x1:NLP问题都包括哪些内涵 人们对真实世界的感知被成为感知世界,而人们用语言表达出自己的感知视为文本数据.那么反过来,NLP,或者更精确地表达为文本挖掘,则是从文本数据出发 ...