
Lucene 05 - 使用Lucene的Java API实现分页查询
1 Lucene的分页查询
搜索内容过多时, 需要考虑分页显示, 像这样:
说明: Lucene的分页查询是在内存中实现的.
2 代码示例
/**

 * 检索索引(实现分页)

 * @throws Exception

 */

@Test

public void searchIndexByPage() throws Exception {

    // 1. 创建分析器对象(Analyzer), 用于分词

    // Analyzer analyzer = new StandardAnalyzer();

    // 使用ik中文分词器

    Analyzer analyzer = new IKAnalyzer();

    // 2. 创建查询对象(Query)

    // bookName:lucene

    // 2.1 创建查询解析器对象

    // 参数一: 指定一个默认的搜索域

    // 参数二: 分析器

    QueryParser queryParser = new QueryParser("bookName", analyzer);

    // 2.2 使用查询解析器对象, 实例化Query对象

    // 参数: 查询表达式

    Query query = queryParser.parse("bookName:lucene");

    // 3. 创建索引库目录位置对象(Directory), 指定索引库的位置

    Directory directory = FSDirectory.open(new File("/Users/healchow/Documents/index"));

    // 4. 创建索引读取对象(IndexReader), 用于读取索引

    IndexReader reader = DirectoryReader.open(directory);

    // 5. 创建索引搜索对象(IndexSearcher), 用于执行搜索

    IndexSearcher searcher = new IndexSearcher(reader);

    // 6. 使用IndexSearcher对象, 执行搜索, 返回搜索结果集TopDocs

    // search方法: 执行搜索

    // 参数一: 查询对象

    // 参数二: n - 指定返回排序以后的搜索结果的前n个

    TopDocs topDocs = searcher.search(query, 10);

    // 7. 处理结果集

    // 7.1 打印实际查询到的结果数量

    System.out.println("实际查询的结果数量: "+topDocs.totalHits);

    // 7.2获取搜索的结果数组

    // ScoreDoc中: 有我们需要的文档的id, 有我们需要的文档的评分

    ScoreDoc[] scoreDocs = topDocs.scoreDocs;

    // 增加分页实现 ========= start

    // 当前页

    int page = 2;

    // 每页的大小

    int pageSize = 2;

    // 计算记录起始数

    int start = (page - 1) * pageSize;

    // 计算记录终止数 -- 得到数据索引与实际结果数量中的最小值, 防止数组越界

    // 数据索引: start + pageSize

    // 实际的结果数量: scoreDocs.length

    int end = Math.min(start + pageSize, scoreDocs.length);

    // 增加分页实现 ========= end

    for(int i = start; i < end; i++){

        System.out.println("= = = = = = = = = = = = = = = = = = =");

        // 获取文档Id和评分

        int docId = scoreDocs[i].doc;

        float score =scoreDocs[i].score;

        System.out.println("文档Id: " + docId + " , 文档评分: " + score);

        // 根据文档Id, 查询文档数据 -- 相当于关系数据库中根据主键Id查询

        Document doc = searcher.doc(docId);

        System.out.println("图书Id: " + doc.get("bookId"));

        System.out.println("图书名称: " + doc.get("bookName"));

        System.out.println("图书价格: " + doc.get("bookPrice"));

        System.out.println("图书图片: " + doc.get("bookPic"));

        System.out.println("图书描述: " + doc.get("bookDesc"));

    }

    // 8. 释放资源

    reader.close();

}
3 分页查询结果
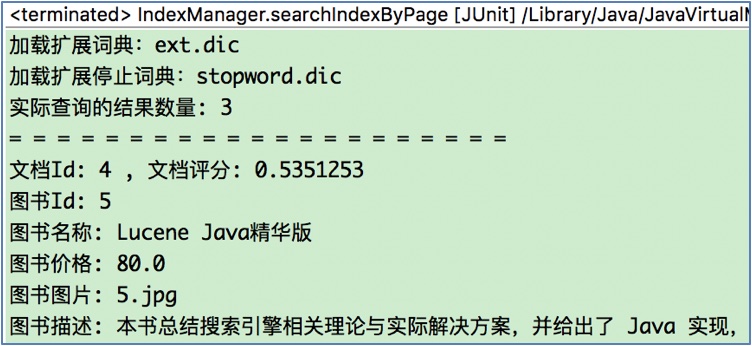
这里查询到的结果共有3条, 所以第2页只有一条结果:
版权声明
作者: 马瘦风
出处: 博客园 马瘦风的博客
您的支持是对博主的极大鼓励, 感谢您的阅读.
本文版权归博主所有, 欢迎转载, 但请保留此段声明, 并在文章页面明显位置给出原文链接, 否则博主保留追究相关人员法律责任的权利.
Lucene 05 - 使用Lucene的Java API实现分页查询的更多相关文章
- HDFS 05 - HDFS 常用的 Java API 操作
目录 0 - 配置 Hadoop 环境(Windows系统) 1 - 导入 Maven 依赖 2 - 常用类介绍 3 - 常见 API 操作 3.1 获取文件系统(重要) 3.2 创建目录.写入文件 ...
- ElasticSearch AggregationBuilders java api常用聚会查询
以球员信息为例,player索引的player type包含5个字段,姓名,年龄,薪水,球队,场上位置.index的mapping为: "mappings": { "pl ...
- 【java】在分页查询结果中对最后的结果集List进行操作add()或remove()操作,报错:java.lang.UnsupportedOperationException
场景: 在分页查询结果中对最后的结果集List进行操作add()或remove()操作,报错:java.lang.UnsupportedOperationException 错误: java.lang ...
- Java GUI+mysql+分页查询
1.要求 : 创建一个学生信息管理数据库 2.实现分页查询 代码如下: a)学生实体类: /** * @author: Annie * @date:2016年6月23日 * @description: ...
- Java基础94 分页查询(以MySQL数据库为例)
1.概述 分页查询,也可叫做分批查询,基于数据库的分页语句(不同数据库是不同的). 本文使用的事MySql数据库. 假设:每页显示10条数据. Select * from c ...
- java开发之分页查询
工具类 package com.luer.comm.utils; import java.util.List; public class PageBean<T> { //已知数据 priv ...
- Elasticsearch Java API—多条件查询(must)
多条件设置 //多条件设置 MatchPhraseQueryBuilder mpq1 = QueryBuilders .matchPhraseQuery("pointid",&qu ...
- [ElasticSearch]Java API 之 词条查询(Term Level Query)
1. 词条查询(Term Query) 词条查询是ElasticSearch的一个简单查询.它仅匹配在给定字段中含有该词条的文档,而且是确切的.未经分析的词条.term 查询 会查找我们设定的准确值 ...
- Dynamics CRM2016 Web Api之分页查询
在dynamics crm web api还没出现前,我们是通过fetchxml来实现的,当然这种方式依旧可行,那既然web api来了我们就拥抱新的方式. web api中我们通过指定查询的条数来实 ...
随机推荐
- 用Sklearn画一颗决策树
小伙伴们大家好~o( ̄▽ ̄)ブ,首先声明一下,我的开发环境是Jupyter lab,所用的库和版本大家参考: Python 3.7.1(你的版本至少要3.4以上 Scikit-learn 0.20.0 ...
- Linux之环境搭建(二)
上一节介绍了PC机安装Ubuntu,本节来看看Ubuntu下安装VMWare,以及在VMWare中安装Windows10. 原本想使用免费的VMware Workstation Player 15,但 ...
- iOS开发之图片压缩实现
使用下面两个方法,先按尺寸重绘图片,然后再降低品质上传图片data #pragma mark 裁剪照片 -(UIImage *)scaleToSize:(UIImage *)image size:(C ...
- 推荐多线程下载工具axel替代wget
在爬数据的时候很多时候需要下载文件比如压缩文件,音频,视频,图片等等,这些文件通常有一个请求的url,这个时候使用request模块或者urllib模块都很慢,而且很不稳定,这个时候使用wget或者a ...
- PageHelper分页插件的使用
大家好!今天写ssm项目实现分页的时候用到pageHelper分页插件,在使用过程中出现了一些错误,因此写篇随笔记录下整个过程 1.背景:在项目的开发的过程中,为了实现所有的功能. 2.目标:实现分页 ...
- socket 套接字服务器端和客户端发送信息
import socket import threading host='' port=6889 def cilenThred(conn,addr): print("成功接受客户端{}的连接 ...
- UI自动化项目搭建(selenium+testng+java+maven)
一 工具准备 selenium chormDriver 二 环境准备 三搭建步骤
- 开启IIS Express可以调试X64项目
//来源:https://blog.csdn.net/ma_jiang/article/details/52679431 现在项目开发时总有时需要在X64下开发,这样我们就需要IIS Express中 ...
- 使用 python 实现π的计算
1.π的神奇 π是一个无数人追随的真正的神奇数字.我不是很清楚一个永远重复的无理数的迷人之处.在我看来,我乐于计算π,也就是计算π的值.因为π是一个无理数,它是无限的.这就意味着任何对π的计算都仅仅是 ...
- Python练手例子(14)
79.字符串排序. #python3.7 if __name__ == '__main__': str1 = input('Input string:\n') str2 = input('Input ...