
urllib库的应用及简单爬虫的编写
1、urllib库基础
1.1爬虫的异常处理
常见状态码及含义
301 Moved Permanently:重定向到新的URL,永久性
302 Found:重定向到临时的URL,非永久性
304 Not Modified:请求的资源未更新
400 Bad Request:非法请求
401 Unauthorized:请求未经授权
403 Forbidden:禁止访问
404 Not Found:没有找到对应页面
500 Internal Server Error:服务器内部出现错误
501 Not Implemented:服务器不支持实现请求所需要的功能
URLError与HTTPError都是异常处理的类,HTTPError是URLError的子类,HTTPError有异常状态码与异常原因,URLError没有异常状态码。不能用URLError直接代替HTTPError,如果要代替,必须要判断是否有状态码属性。
URLError:
1、连不上服务器
2、远程的URL不存在
3、本地没有网络
4、触发了HTTPError(因为HTTPError是它的子类)

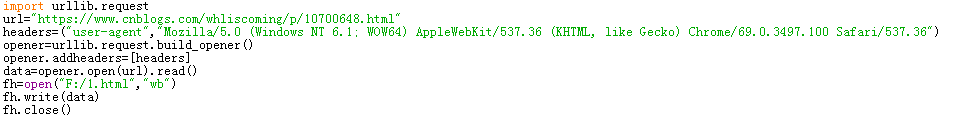
1.2爬虫的浏览器伪装技术
想要伪装成浏览器,必须为爬虫添加报头信息。打开浏览器进入网页,F12中network中找到user-agent及其后面的内容,然后创建opener对象,把opener添加为全局(urllib.request.install_opener(opener))。
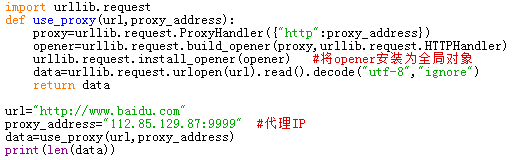
1.3设置代理服务器
2、爬虫实战
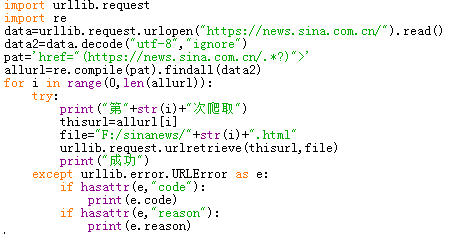
2.1将新浪新闻首页的所有新闻都爬到本地
进入新浪新闻首页,查看网页源代码,根据每个新闻链接的相似度,构造求新闻链接的正则表达式,接着再将网页全部写入到本地。
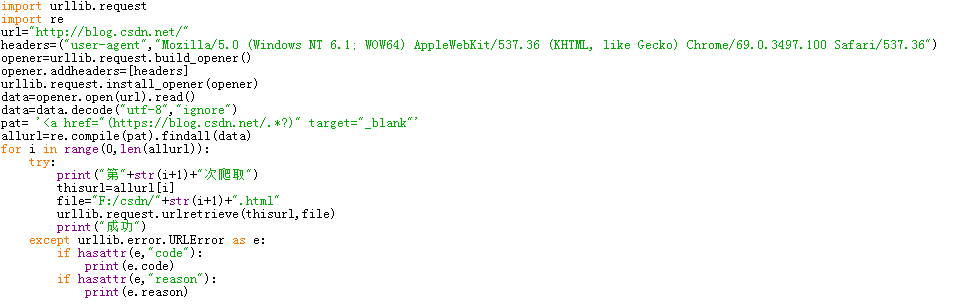
2.2爬取CSDN博客(http://blog.csdn.net/)首页显示的所有文章,每个文章内容单独生成一个本地网页存到本地中。
利用浏览器伪装技术,先爬首页,通过正则表达式筛选出所有文章的url,然后通过循环把这些url下载到本地。
3、爬取网站图片
3.1爬取淘宝网任意搜索目录下高清图
本次爬取淘宝的搜索关键词为“短裙”,在淘宝搜索短裙进入搜索结果页面。对该页面网址及下几页网址进行分析,找出url构造规律。对源代码中进行分析,注意找到图片的url,此时要特别注意图片必须要高清而不是略缩图,这同样需要注意图片地址。利用正则表达式对提取到的信息进行筛选,最后将得到的图片编号存储到本地。
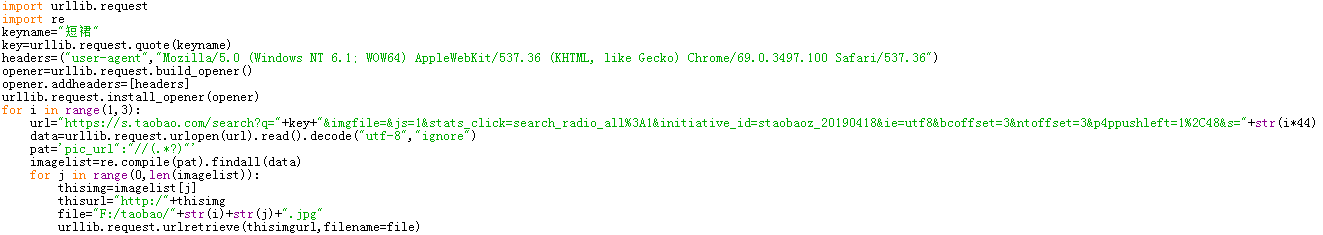
由于是爬取多页的信息,如果对循环不太熟悉的话,可以先爬取一页的图片,然后找出循环的规律在对规定的页数进行循环爬取图片。
3.2对千图网任一类图片进行爬取
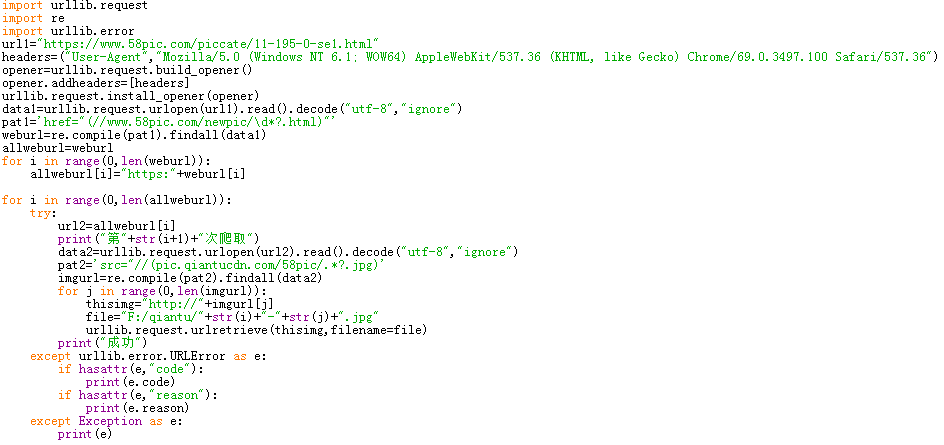
一定要进行异常处理,不然程序很容易崩。尽量每次爬取后都输出一些文字提示,以此来了解进度。
urllib库的应用及简单爬虫的编写的更多相关文章
- 对于python爬虫urllib库的一些理解(抽空更新)
urllib库是Python中一个最基本的网络请求库.可以模拟浏览器的行为,向指定的服务器发送一个请求,并可以保存服务器返回的数据. urlopen函数: 在Python3的urllib库中,所有和网 ...
- 爬虫之urllib库
一.urllib库简介 简介 Urllib是Python内置的HTTP请求库.其主要作用就是可以通过代码模拟浏览器发送请求.它包含四个模块: urllib.request :请求模块 urllib.e ...
- python爬虫 urllib库基本使用
以下内容均为python3.6.*代码 学习爬虫,首先有学会使用urllib库,这个库可以方便的使我们解析网页的内容,本篇讲一下它的基本用法 解析网页 #导入urllib from urllib im ...
- 第三百二十七节,web爬虫讲解2—urllib库爬虫—基础使用—超时设置—自动模拟http请求
第三百二十七节,web爬虫讲解2—urllib库爬虫 利用python系统自带的urllib库写简单爬虫 urlopen()获取一个URL的html源码read()读出html源码内容decode(& ...
- Python爬虫学习笔记-1.Urllib库
urllib 是python内置的基本库,提供了一系列用于操作URL的功能,我们可以通过它来做一个简单的爬虫. 0X01 基本使用 简单的爬取一个页面: import urllib2 request ...
- Python做简单爬虫(urllib.request怎么抓取https以及伪装浏览器访问的方法)
一:抓取简单的页面: 用Python来做爬虫抓取网站这个功能很强大,今天试着抓取了一下百度的首页,很成功,来看一下步骤吧 首先需要准备工具: 1.python:自己比较喜欢用新的东西,所以用的是Pyt ...
- 六 web爬虫讲解2—urllib库爬虫—基础使用—超时设置—自动模拟http请求
利用python系统自带的urllib库写简单爬虫 urlopen()获取一个URL的html源码read()读出html源码内容decode("utf-8")将字节转化成字符串 ...
- 网络爬虫必备知识之urllib库
就库的范围,个人认为网络爬虫必备库知识包括urllib.requests.re.BeautifulSoup.concurrent.futures,接下来将结合爬虫示例分别对urllib库的使用方法进行 ...
- 爬虫入门之urllib库详解(二)
爬虫入门之urllib库详解(二) 1 urllib模块 urllib模块是一个运用于URL的包 urllib.request用于访问和读取URLS urllib.error包括了所有urllib.r ...
随机推荐
- 51nod 1228、1258 序列求和
这里一次讲两题...貌似都是板子? 所以两题其实可以一起做 [雾 noteskey 总之就是伯努利数的两道入门题啦,就是第二道有点鬼畜了,居然要任意模数的!(好吧是 1e9+7 但也没什么区别了) 伯 ...
- 帆软报表(finereport) 复选框多值查询
定义数据集 SELECT * FROM 库存 设计模板 设置控件:控件名称 XX 要与 单元格中 取值公式 =$XX 对应,控件值可更改 下拉复选框控件: 设置控件名称(与模板中=$选仓库 ...
- 根据SQL_ID查询并杀会话
Oracle 根据SQL_ID查询并杀会话,清空执行计划缓冲池2018年09月06日 10:31:40 小学生汤米 阅读数:4731. 查询最近五分钟内最高频次SQL,查看event select t ...
- 初识Vue
Vue.js介绍 Vue是一套用于构建用户界面的渐进式框架.与其它大型框架不同的是,Vue 被设计为可以自底向上逐层应用.Vue 的核心库只关注视图层,不仅易于上手,还便于与第三方库或既有项目整合.另 ...
- 使用 Sonar 检测代码质量
经历了一段时间的加班赶项目进度之后,今天终于闲下来了.忽然不知道干啥.于是,想着做点什么吧.突然想起了码云上面有个代码分析的功能,用的是 Sonar 于是想来玩玩这个. 一.下载Sonar,和初始化, ...
- 一起学爬虫——通过爬取豆瓣电影top250学习requests库的使用
学习一门技术最快的方式是做项目,在做项目的过程中对相关的技术查漏补缺. 本文通过爬取豆瓣top250电影学习python requests的使用. 1.准备工作 在pycharm中安装request库 ...
- Codeforces 715B. Complete The Graph 最短路,Dijkstra,构造
原文链接https://www.cnblogs.com/zhouzhendong/p/CF715B.html 题解 接下来说的“边”都指代“边权未知的边”. 将所有边都设为 L+1,如果dis(S,T ...
- 网页布局之grid
学习网格布局时,你可能会在网络上看到很多文章,内容不同,属性不同,真是让人摸不着头脑,到底哪个才是正确的?看了本篇文章,我想你会豁然开朗.比如,一会儿用grid-rows,一会儿用grid-defin ...
- [BOI2007]Mokia 摩基亚
Description: 摩尔瓦多的移动电话公司摩基亚(Mokia)设计出了一种新的用户定位系统.和其他的定位系统一样,它能够迅速回答任何形如"用户C的位置在哪?"的问题,精确到毫 ...
- HTML入门6
这篇将简单会编写网页整体网站架构,通过HTML来表示网站结构. 标题<header>,通常顶部有个大标题或图标,是网站的主要常见信息,存在于每个网页 导航<nav>,通常包含菜 ...