
SparkSQL学习进度9-SQL实战案例
Spark SQL 基本操作
将下列 JSON 格式数据复制到 Linux 系统中,并保存命名为 employee.json。
{ "id":1 , "name":" Ella" , "age":36 }
{ "id":2, "name":"Bob","age":29 }
{ "id":3 , "name":"Jack","age":29 }
{ "id":4 , "name":"Jim","age":28 }
{ "id":4 , "name":"Jim","age":28 }
{ "id":5 , "name":"Damon" }
{ "id":5 , "name":"Damon" }
为 employee.json 创建 DataFrame,并写出 Scala 语句完成下列操作:
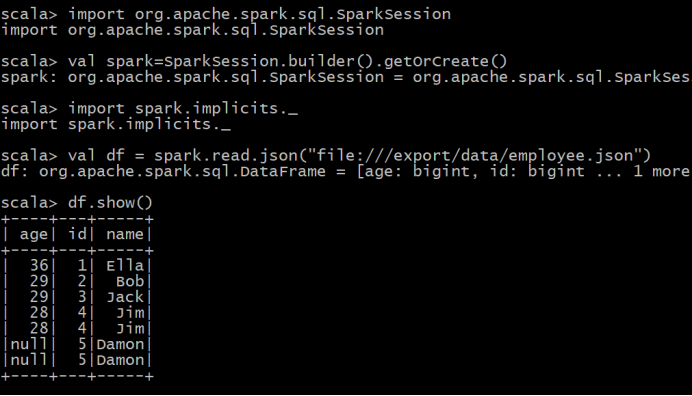
(1) 查询所有数据;
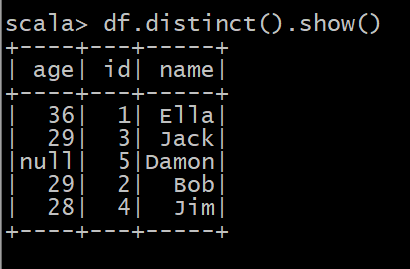
(2) 查询所有数据,并去除重复的数据;
(3) 查询所有数据,打印时去除 id 字段;

(4) 筛选出 age>30 的记录;

(5) 将数据按 age 分组;

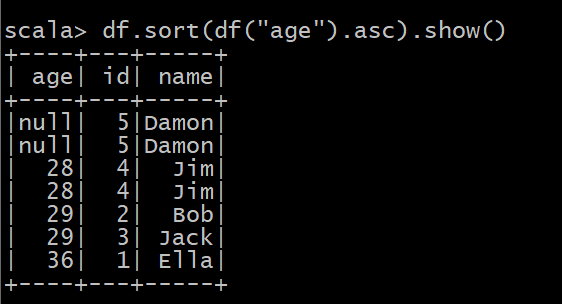
(6) 将数据按 name 升序排列;
(7) 取出前 3 行数据;

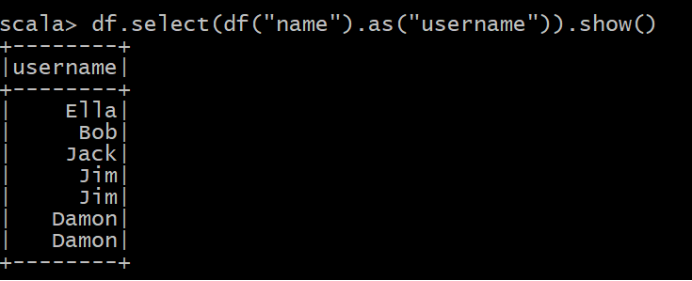
(8) 查询所有记录的 name 列,并为其取别名为 username;
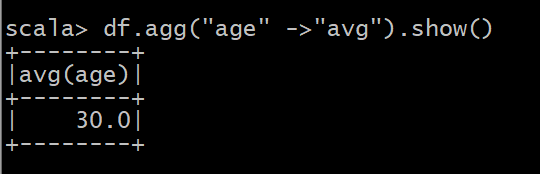
(9) 查询年龄 age 的平均值;
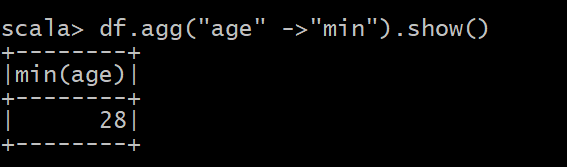
(10) 查询年龄 age 的最小值。
编程实现将 RDD 转换为 DataFrame
源文件内容如下(包含 id,name,age):
1,Ella,36
2,Bob,29
3,Jack,29
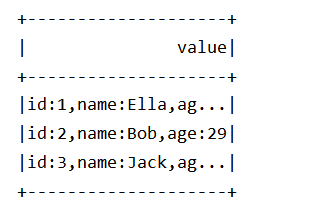
请将数据复制保存到 Linux 系统中,命名为 employee.txt,实现从 RDD 转换得到DataFrame,并按“id:1,name:Ella,age:36”的格式打印出 DataFrame 的所有数据。请写出程序代码。
package cn.itcast.spark.mook

import org.apache.spark.sql.SparkSession

import org.junit.Test

class RDDtoDataFrame {

  @Test

  def test(): Unit ={

    val spark=SparkSession.builder()

      .appName("datafreame1")

      .master("local[6]")

      .getOrCreate()

    import spark.implicits._

    val df=spark.sparkContext.textFile("dataset/employee.txt").map(_.split(","))

      .map(item => Employee(item(0).trim.toInt,item(1),item(2).trim.toInt))

      .toDF()

    df.createOrReplaceTempView("employee")

    val dfRDD=spark.sql("select * from employee")

    dfRDD.map(it => "id:"+it(0) +",name:"+it(1)+",age:"+it(2) )

      .show()

  }

}

case class Employee(id:Int,name:String,age:Long)
编程实现利用 DataFrame 读写 MySQL 的数据
(1)在 MySQL 数据库中新建数据库 sparktest,再创建表 employee,包含如表 6-2 所示的两行数据。
表 6-2 employee 表原有数据
id name gender Age
1 Alice F 22
2 John M 25

(2)配置 Spark 通过 JDBC 连接数据库 MySQL,编程实现利用 DataFrame 插入如表 6-3 所示的两行数据到 MySQL 中,最后打印出 age 的最大值和 age 的总和。
表 6-3 employee 表新增数据
id name gender age
3 Mary F 26
4 Tom M 23
package cn.itcast.spark.mook

import org.apache.spark.sql.{SaveMode, SparkSession}

import org.apache.spark.sql.types.{FloatType, IntegerType, StringType, StructField, StructType}

object MysqlOp {

  def main(args: Array[String]): Unit = {

    val spark = SparkSession

      .builder()

      .appName("mysql example")

      .master("local[6]")

      .getOrCreate()

    val schema = StructType(

      List(

        StructField("id", IntegerType),

        StructField("name", StringType),

        StructField("gender", StringType),

        StructField("age", IntegerType)

      )

    )

    val studentDF = spark.read

      //分隔符:制表符

      .option("delimiter", ",")

      .schema(schema)

      .csv("dataset/stu")

    studentDF.write

      .format("jdbc")

      .mode(SaveMode.Append)

      .option("url", "jdbc:mysql://hadoop101:3306/spark02")

      .option("dbtable", "employee")

      .option("user", "spark")

      .option("password", "fengge666")

      .save()

    spark.read

      .format("jdbc")

      .option("url", "jdbc:mysql://hadoop101:3306/spark02")

      .option("dbtable","(select max(age),SUM(age) from employee) as emp")

      .option("user", "spark")

      .option("password", "fengge666")

      .load()

      .show()

  }

}
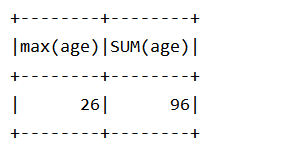
SparkSQL学习进度9-SQL实战案例的更多相关文章
- Salesforce学习之路-developer篇(五)一文读懂Aura原理及实战案例分析
1. 什么是Lightning Component框架? Lightning Component框架是一个UI框架,用于为移动和台式设备开发Web应用程序.这是一个单页面Web应用框架,用于为Ligh ...
- 大数据学习day20-----spark03-----RDD编程实战案例(1 计算订单分类成交金额,2 将订单信息关联分类信息,并将这些数据存入Hbase中,3 使用Spark读取日志文件,根据Ip地址,查询地址对应的位置信息
1 RDD编程实战案例一 数据样例 字段说明: 其中cid中1代表手机,2代表家具,3代表服装 1.1 计算订单分类成交金额 需求:在给定的订单数据,根据订单的分类ID进行聚合,然后管理订单分类名称, ...
- 【大数据】SparkSql学习笔记
第1章 Spark SQL概述 1.1 什么是Spark SQL Spark SQL是Spark用来处理结构化数据的一个模块,它提供了2个编程抽象:DataFrame和 DataSet,并且作为分布式 ...
- 基于SpringCloud的Microservices架构实战案例-架构拆解
自第一篇< 基于SpringCloud的Microservices架构实战案例-序篇>发表出来后,差不多有半年时间了,一直也没有接着拆分完,有如读本书一样,也是需要契机的,还是要把未完成的 ...
- 【Redis3.0.x】实战案例
Redis3.0.x 实战案例 简介 <Redis实战>的学习笔记和总结. 书籍链接 初识 Redis Redis 简介 Redis 是一个速度非常快的键值对存储数据库,它可以存储键和五种 ...
- Shell高级编程视频教程-跟着老男孩一步步学习Shell高级编程实战视频教程
Shell高级编程视频教程-跟着老男孩一步步学习Shell高级编程实战视频教程 教程简介: 本教程共71节,主要介绍了shell的相关知识教程,如shell编程需要的基础知识储备.shell脚本概念介 ...
- 跟着老男孩一步步学习Shell高级编程实战
原创作品,允许转载,转载时请务必以超链接形式标明文章 原始出处 .作者信息和本声明.否则将追究法律责任.http://oldboy.blog.51cto.com/2561410/1264627 本sh ...
- SQL反模式学习笔记21 SQL注入
目标:编写SQL动态查询,防止SQL注入 通常所说的“SQL动态查询”是指将程序中的变量和基本SQL语句拼接成一个完整的查询语句. 反模式:将未经验证的输入作为代码执行 当向SQL查询的字符串中插入别 ...
- SQL注入(SQL Injection)案例和防御方案
sql注入(SQL Injection):就是通过把SQL命令插入到Web表单递交或输入域名或页面请求的查询字符串,最终达到欺骗服务器执行恶意的SQL命令. SQL注入攻击的主要危害包括:非法读取.篡 ...
随机推荐
- caffe源码 全连接层
图示全连接层 如上图所示,该全链接层输入n * 4,输出为n * 2,n为batch 该层有两个参数W和B,W为系数,B为偏置项 该层的函数为F(x) = W*x + B,则W为4 * 2的矩阵,B ...
- CentOS 用户请关注,你期待的 CentOS Linux 9 再也不会来了
2020年12月晚上红帽官网发布了一条公告,宣布了几件事情: 将不会发行 CentOS Linux 9 CentOS Linux 8 的更新支持持续到2021年12月31日 CentOS Linux ...
- uni-app中封装统一请求函数
封装统一请求函数有利于项目的维护 整体功能简单实用,但小编遇到一个巨坑,项目中在vue文件使用跳转方法,url参数输入 "/" 后工具提示的路径为 "/pages/log ...
- C++ 虚函数表与多态 —— 虚函数表的内存布局
C++面试经常会被问的问题就是多态原理.如果对C++面向对象本质理解不是特别好,问到这里就会崩. 下面从基本到原理,详细说说多态的实现:虚函数 & 虚函数表. 1. 多态的本质: 形 ...
- Ubuntu18 安装 MySQL 8.0.22
Ubuntu18 安装 MySQL 8.0.22 网上教程都比旧,也不是第一次安装了,但依然还是花了比较多的时间,特此记录本次安装过程.因是安装完毕后回忆记录,或有错漏. 第一步: 下载 mysql ...
- oracle 11g调优常用语句
1.查询表的基数及选择性 select a.column_name, b.num_rows, a.num_distinct cardinality, round( ...
- MySQL-实体映射关系和连接查询
一 数据库实体的映射关系 1. 一对一:学生表和学生档案表,一个学生只有一个对应的档案. 2. 一对多/多对一:一个球队友多个球员(一对多),多个球员属于一个球队(多对一) 3. 多对多:一个学生可 ...
- SQL注入fuzz字典
length Length + handler likeLiKe selectSeleCT sleepSLEEp databaseDATABASe delete having oroR asAs -~ ...
- sqoop用法之mysql与hive数据导入导出
目录 一. Sqoop介绍 二. Mysql 数据导入到 Hive 三. Hive数据导入到Mysql 四. mysql数据增量导入hive 1. 基于递增列Append导入 1). 创建hive表 ...
- 同学你会hello world吗? 给我讲清楚点
少点代码,多点头发 本文已经收录至我的GitHub,欢迎大家踊跃star 和 issues. https://github.com/midou-tech/articles 面试官超级喜欢问hello ...