
mysql 不同版本下 group by 组内排序的差异
建表语句:


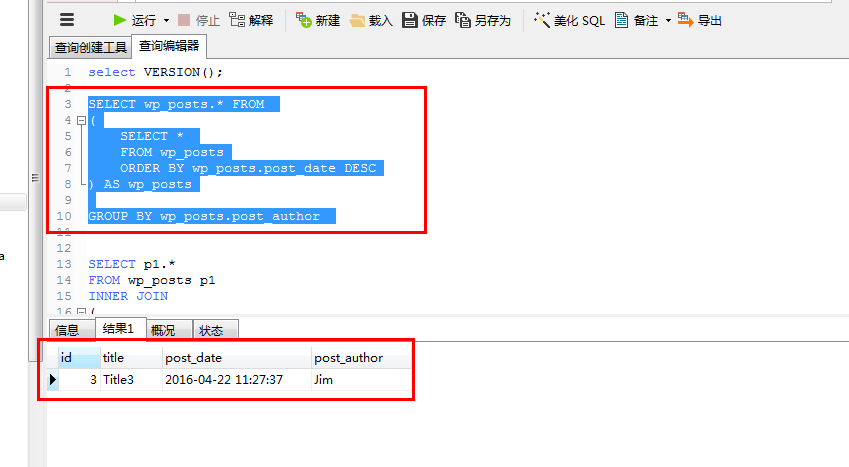
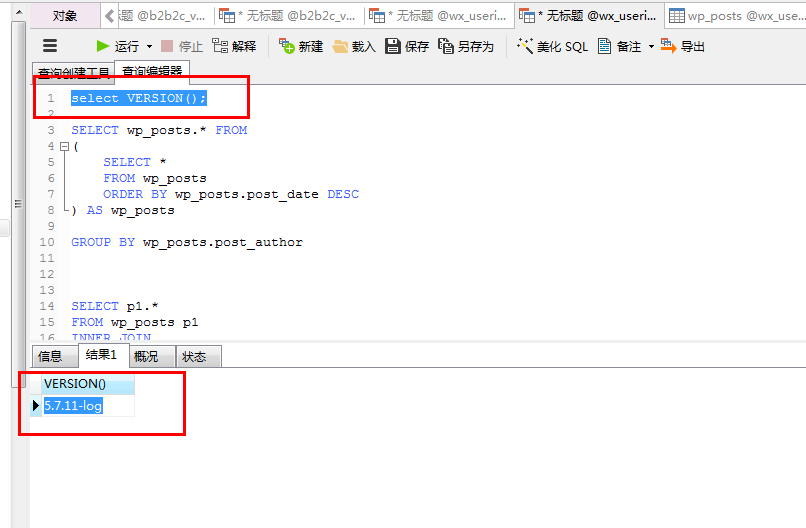


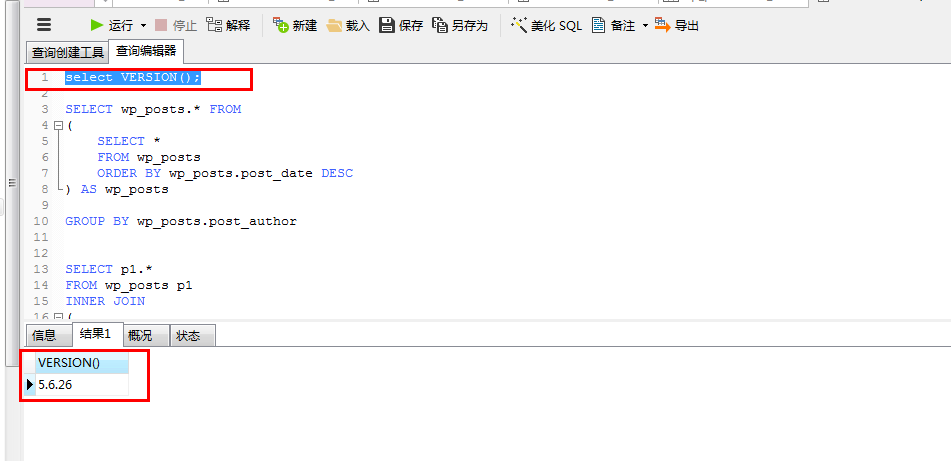


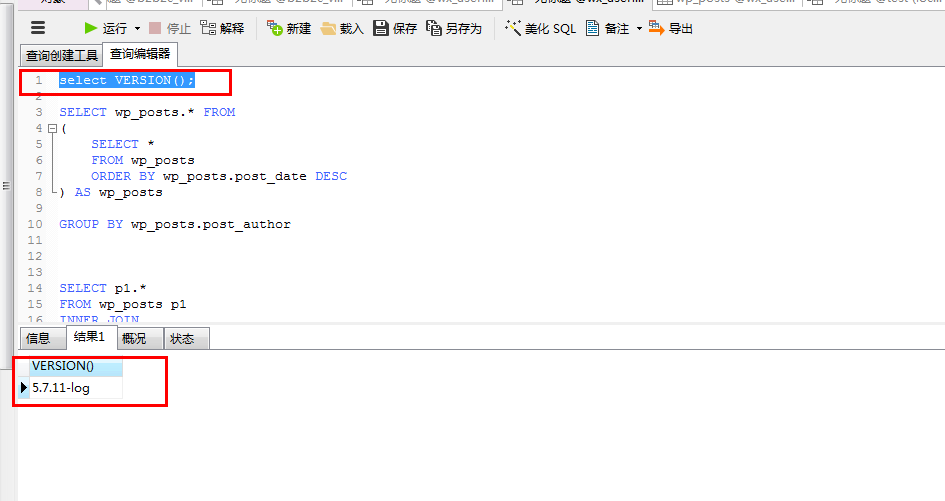


在版本5.6.26和版本5.7.11-log中结果是一样的(其他版本我没试过)。
mysql 不同版本下 group by 组内排序的差异的更多相关文章
- mysql group by组内排序
mysql group by组内排序: 首先是组外排序: SELECT z.create_time,z.invoice_id from qf_invoice_log z where z ...
- mysql group by 组内排序 group by 原理
mysql group by 组内排序 SELECT * FROM (SELECT MAX(id) AS t,wukong_uid, 1 AS tag FROM toutiao_uid_gath ...
- MySQL学习笔记:三种组内排序方法
由于MySQ没有提供像Oracle的dense_rank()或者row_number() over(partition by)等函数,来实现组内排序,想实现这个功能,还是得自己想想办法,最终通过创建行 ...
- mysql多表查询及其 group by 组内排序
//多表查询:得到最新的数据后再执行多表查询 SELECT *FROM `students` `st` RIGHT JOIN( //先按时间排序查询,然后分组(GROUP BY ) SELECT * ...
- mysql group by 组内排序
有数据表 comments------------------------------------------------| id | newsID | comment | theTime |---- ...
- mysql5.7.10和mysql5.5.39两个版本对于group by函数的处理差异
原理还是没有搞清楚,在官网上看了一下,看的不是很清楚.一并都记录一下. 问题描述: 存在如下数据结构 sql: 求用户最近更新的那条记录 思路: 按照modify_time排序后按照user_id分组 ...
- Groovy在不同JDK版本下的性能差异
Groovy作为一种动态语言,性能和JAVA比肯定是差不少,根据网友的测试,由于测试环境,场景和编译参数的不同,大概有差2到7倍的差距 那么同样的Groovy,在不同的JDK版本下,会有着怎样的差异呢 ...
- MySQL 5.7.17 Group Relication(组复制)搭建手册【转】
本博文介绍了Group Replication的两种工作模式的架构.并详细介绍了Single-Master Mode的部署过程,以及如何切换到Multi-Master Mode.当然,文末给出了Gro ...
- mysql在linux下的安装(5.7版本以后)
1.添加mysql组和mysql用户,用于设置mysql安装目录文件所有者和所属组. ①groupadd mysql ②useradd -r -g mysql mysql 2.将二进制文件解压到指定的 ...
随机推荐
- python-监控服务
最近写了一个web测试程序,因为部署在其他地方,所以想弄个监控的进程去看服务是不是还在,要是不在好发邮件,就用python简单的写了一个. 想法是这样的,单独运行一个monitor的脚本,每隔一段时间 ...
- Spring之基于注解的注入
对于DI使用注解,将不再需要在Spring配置文件中声明Bean实例.Spring中使用注解,需要在原有Spring运行环境基础上再做一些改变,完成以下三个步骤. (1)导入AOP的Jar包.因为注解 ...
- http协议内容展示以及如何用telnet发送请求
1.http协议组成: 报文首部:状态行(请求行) 请求首部字段 通用字段 其他信息 空行 报文主体 GET请求头: GET /test.php?a=1 HTTP/1.1 Host: localhos ...
- 实现h5公众号分享功能(vue项目也适用)
在vue项目中我们先npm install weixin-js-sdk --save下载下来在main.js文件中引入 import wx from 'weixin-js-sdk';//引入 Vue. ...
- oracle 和 mysql 常用语句对比汇总
文章目录 一.数据库管理 1.1 用户管理 1.1.1 mysql用户.权限管理 1.1.2 oracle 用户.角色.权限管理 二.DQL 语句 2.1 基础查询 1.常量查询的区别: 2.字符串拼 ...
- feign之间传递oauth2-token的问题和解决
在微服务架构里,服务与服务之间的调用一般用feign就可以实现,它是一种可视化的rpc,并且集成了ribbon的负载均衡能力,所以很受欢迎. 授权服务 在授权服务里,用户通过用户名密码,或者手机和验证 ...
- Java8新特性——lambda表达式.(案例:词频统计)
需求:读入一个文本文件,确定所有单词的使用频率并从高到低排序,打印出所有单词及其频率的排序列表 先用传统方法解: package cn._1.wordfrequency; import java.ut ...
- python argparse模块的使用
import argparse def get_parse(): # 初始化 parse = argparse.ArgumentParser() # 添加选项,类型为str,默认为空 parse.ad ...
- Oracle基础学习笔记
Oracle基础学习笔记 最近找到一份实习工作,有点头疼的是,有阶段性考核,这...,实际想想看,大学期间只学过数据库原理,并没有针对某一数据库管理系统而系统的学习,这正好是一个机会,于是乎用了三天时 ...
- DStream转为DF的两种方式(突破map时元组22的限制)
在进行Spark Streaming的开发时,我们常常需要将DStream转为DataFrame来进行进一步的处理, 共有两种方式,方式一: val spark = SparkSession.buil ...