
Kafaka 总结

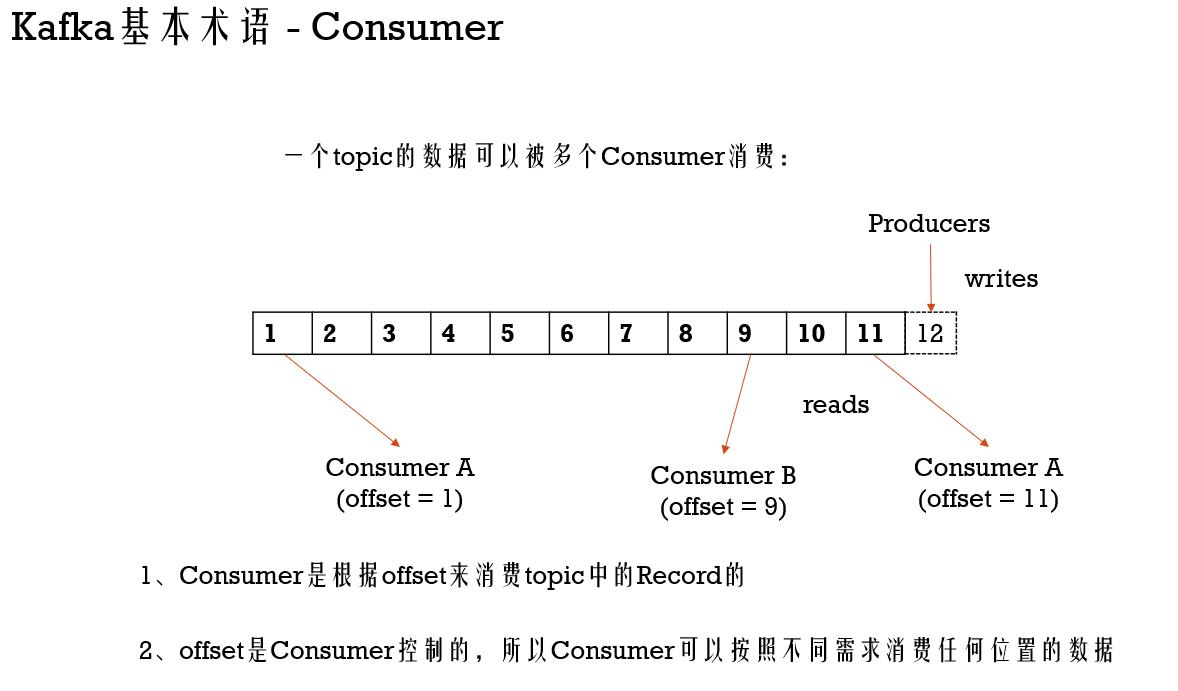
Kafka基本术语 - Consumer

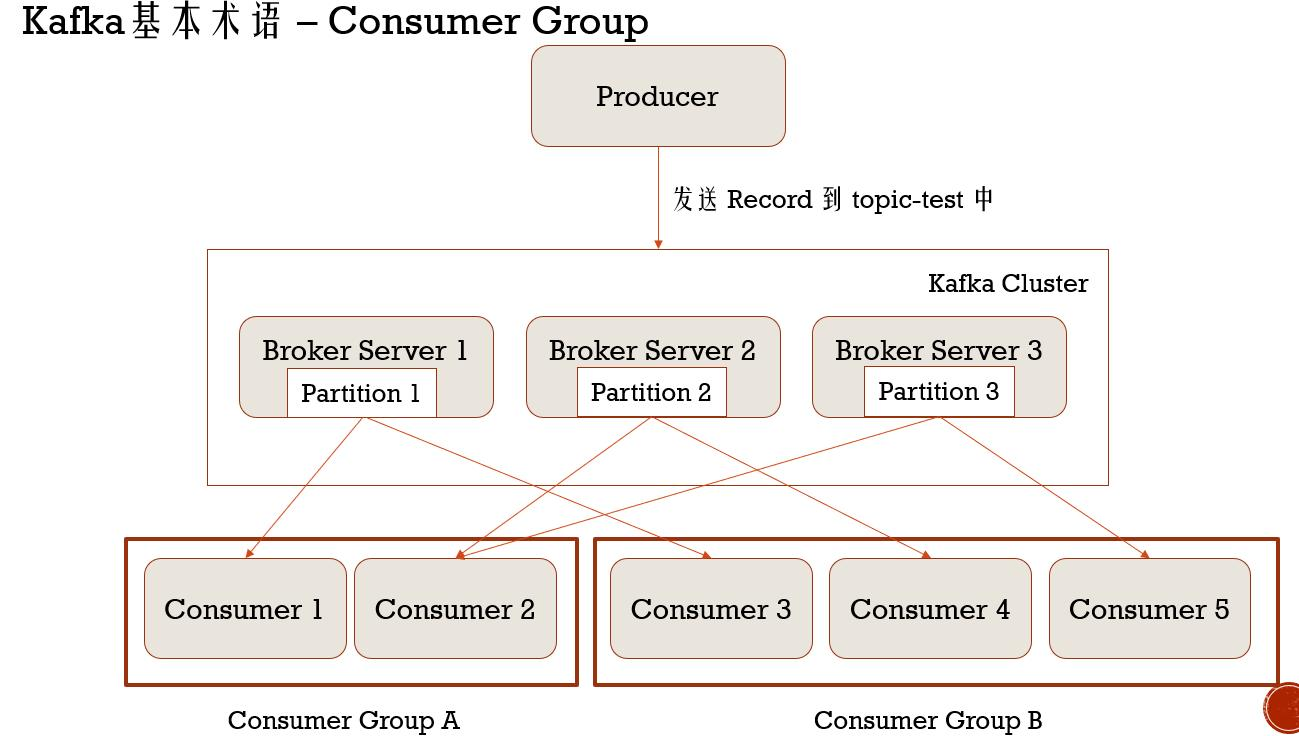
import org.apache.kafka.clients.consumer.ConsumerRecord;

import org.apache.kafka.clients.consumer.ConsumerRecords;

import org.apache.kafka.clients.consumer.KafkaConsumer;

import java.util.Arrays;

import java.util.Properties;

/**

 * Created by tangweiqun on 2017/12/23.

 */

public class SimpleComsumerGroup1 {

    public static void main(String[] args) {

        Properties props = new Properties();

        props.put("bootstrap.servers", "master:9092");

        props.put("group.id", "group1");

        props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        KafkaConsumer<String, String> consumer = new KafkaConsumer<String, String>(props);

        consumer.subscribe(Arrays.asList("test-group"));

        while (true) {

            ConsumerRecords<String, String> records = consumer.poll(100);

            for (ConsumerRecord<String, String> record : records) {

                System.out.printf("offset = %d, key = %s, value = %s, topic = %s, partition = %d",

                        record.offset(), record.key(), record.value(), record.topic(), record.partition());

                System.out.println();

            }

        }

    }

}
import org.apache.kafka.clients.consumer.ConsumerRecord;

import org.apache.kafka.clients.consumer.ConsumerRecords;

import org.apache.kafka.clients.consumer.KafkaConsumer;

import java.util.Arrays;

import java.util.Properties;

/**

 * Created by tangweiqun on 2017/12/23.

 */

public class SimpleComsumerGroup2 {

    public static void main(String[] args) {

        Properties props = new Properties();

        props.put("bootstrap.servers", "master:9092");

        props.put("group.id", "group2");

        props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        KafkaConsumer<String, String> consumer = new KafkaConsumer<String, String>(props);

        consumer.subscribe(Arrays.asList("test-group"));

        while (true) {

            ConsumerRecords<String, String> records = consumer.poll(100);

            for (ConsumerRecord<String, String> record : records) {

                System.out.printf("offset = %d, key = %s, value = %s, topic = %s, partition = %d",

                        record.offset(), record.key(), record.value(), record.topic(), record.partition());

                System.out.println();

            }

        }

    }

}
import org.apache.kafka.clients.producer.KafkaProducer;

import org.apache.kafka.clients.producer.Producer;

import org.apache.kafka.clients.producer.ProducerRecord;

import java.util.Properties;

public class SimpleProducer {

    public static void main(String[] args) {

        Properties props = new Properties();

        props.put("bootstrap.servers", "master:9092");

        props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");

        props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");

        props.put("batch.size", "10");

        Producer<String, String> producer = new KafkaProducer<>(props);

        for (int i = 0; i < 100; i++) {

            producer.send(new ProducerRecord<String, String>("test-group",

                    Integer.toString(i), Integer.toString(i)));

        }

        producer.close();

    }

}
Kafaka 总结的更多相关文章
- centos单机安装zookeeper+kafaka
环境如下: CentOS-7-x86_64zookeeper-3.4.11kafka_2.12-1.1.0 一.zookeeper下载与安装1)下载zookeeper [root@localhost ...
- Kafaka高可用集群环境搭建
zk集群环境搭建:https://www.cnblogs.com/toov5/p/9897868.html 三台主机每台的Java版本1.8 下面kafka集群的搭建: 3台虚拟机均进行以下操作: ...
- spring cloud 2.x版本 Spring Cloud Stream消息驱动组件基础教程(kafaka篇)
本文采用Spring cloud本文为2.1.8RELEASE,version=Greenwich.SR3 本文基于前两篇文章eureka-server.eureka-client.eureka-ri ...
- kafka?kafaka! kafka...
kafka?kafaka! Kafka... kafka是什么? 答:Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写.Kafka是一种高吞吐量的分布式发布订阅 ...
- windows环境下配置Kafaka
一.安装Zookeeper(Kafaka依赖于zookeeper进行服务注册和管理) 1. 1 下载zookeeper:http://mirror.bit.edu.cn/apache/zookee ...
- kafaka quickstart
http://kafka.apache.org/ http://kafka.apache.org/downloads cd /root/kafuka/kafka_2.12-0.11.0.0 nohup ...
- kafka 分区和副本以及kafaka 执行流程,以及消息的高可用
1.Kafka概览 Apache下的项目Kafka(卡夫卡)是一个分布式流处理平台,它的流行是因为卡夫卡系统的设计和操作简单,能充分利用磁盘的顺序读写特性.kafka每秒钟能有百万条消息的吞吐量,因此 ...
- kafaka可视化工具
许多中间件系统都提供了良好的可视化系统.MySQL有workbench,navcat,php版的mysqladmin等可视化程序.Redis.MongoDB也有开源的可视化程序.只要官方提供了探索数据 ...
- kafaka学习
创建一个topic: [root@hdp1 bin]# ./kafka-topics. --replication-factor --partitions --topic justin Created ...
- kafaka安装
wget https://mirrors.cnnic.cn/apache/kafka/2.0.0/kafka_2.11-2.0.0.tgz 解压 Tar -xvf kafka_2.11-2.0.0.t ...
随机推荐
- linux减少服务器带宽的方法
linux减少服务器带宽的方法用百度静态资源公共库http://cdn.code.baidu.com/ 不仅可以不使用服务器流量 而且还有cdn加速比方说http://apps.bdimg.com/l ...
- golang(三)
map(声明.初始化和 make) 1. 概念2.map 容量3. 用切片作为 map 的值 概念 map 是引用类型,可以使用如下声明: var map1 map[keytype]valuetype ...
- go编译运行说明
二 编译运行说明 1.1 编译 1)有了go源文件,通过编译器将其编译成机器可以识别的二进制码文件. 2)在该源文件目录下,通过 go build 对hello.go 文件进行编译.可以指定生成的可 ...
- checkbox之全选和反选
先导入jquery组件 <input type="checkbox" id="checkall">全选<input type="ch ...
- CF704D Captain America 上下界网络流
传送门 现在相当于说每一个条件都有一个染成红色的盾牌的数量限制\([l,r]\),需要满足所有限制且染成红色的盾牌数量最小/最大. 注意到一个盾牌染成红色对于一行和一列都会产生影响.如果选中一个物品对 ...
- git学习笔记 --分支管理策略
通常,合并分支时,如果可能,Git会用Fast forward模式,但这种模式下,删除分支后,会丢掉分支信息. 如果要强制禁用Fast forward模式,Git就会在merge时生成一个新的comm ...
- KEPServerEX 6 配置连接 Allen-Bradley MicroLogix 1400
=============================================== 2019/7/28_第1次修改 ccb_warlock == ...
- 计数数据存入Mysql
引用dll MySql.Data.dll 建一个数据连接静态类 public static class mysql{public static string constr = "databa ...
- 4.matplotlib绘制直方图
  # coding=utf-8 from matplotlib import pyplot as plt from matplotlib import font_manager a=[131, ...
- eyoucms 模板
https://www.oschina.net/p/eyoucms 下载模板 https://www.eyoucms.com/doc/operation/ 学习手册