
入门大数据---Hbase的SQL中间层_Phoenix
一、Phoenix简介
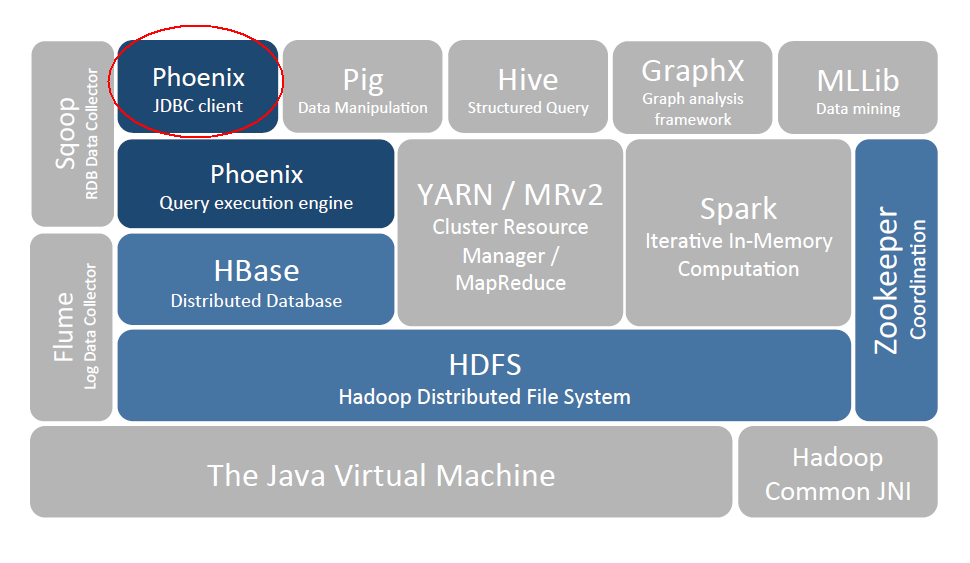
Phoenix 是 HBase 的开源 SQL 中间层,它允许你使用标准 JDBC 的方式来操作 HBase 上的数据。在 Phoenix 之前,如果你要访问 HBase,只能调用它的 Java API,但相比于使用一行 SQL 就能实现数据查询,HBase 的 API 还是过于复杂。Phoenix 的理念是 we put sql SQL back in NOSQL,即你可以使用标准的 SQL 就能完成对 HBase 上数据的操作。同时这也意味着你可以通过集成 Spring Data JPA 或 Mybatis 等常用的持久层框架来操作 HBase。
其次 Phoenix 的性能表现也非常优异,Phoenix 查询引擎会将 SQL 查询转换为一个或多个 HBase Scan,通过并行执行来生成标准的 JDBC 结果集。它通过直接使用 HBase API 以及协处理器和自定义过滤器,可以为小型数据查询提供毫秒级的性能,为千万行数据的查询提供秒级的性能。同时 Phoenix 还拥有二级索引等 HBase 不具备的特性,因为以上的优点,所以 Phoenix 成为了 HBase 最优秀的 SQL 中间层。
二、Phoenix安装
我们可以按照官方安装说明进行安装,官方说明如下:
- download and expand our installation tar
- copy the phoenix server jar that is compatible with your HBase installation into the lib directory of every region server
- restart the region servers
- add the phoenix client jar to the classpath of your HBase client
- download and setup SQuirrel as your SQL client so you can issue adhoc SQL against your HBase cluster
2.1 下载并解压
官方针对 Apache 版本和 CDH 版本的 HBase 均提供了安装包,按需下载即可。官方下载地址: http://phoenix.apache.org/download.html
# 下载

wget http://mirror.bit.edu.cn/apache/phoenix/apache-phoenix-4.14.0-cdh5.14.2/bin/apache-phoenix-4.14.0-cdh5.14.2-bin.tar.gz

# 解压

tar tar apache-phoenix-4.14.0-cdh5.14.2-bin.tar.gz
2.2 拷贝Jar包
按照官方文档的说明,需要将 phoenix server jar 添加到所有 Region Servers 的安装目录的 lib 目录下。
这里由于我搭建的是 HBase 伪集群,所以只需要拷贝到当前机器的 HBase 的 lib 目录下。如果是真实集群,则使用 scp 命令分发到所有 Region Servers 机器上。
cp /usr/app/apache-phoenix-4.14.0-cdh5.14.2-bin/phoenix-4.14.0-cdh5.14.2-server.jar /usr/app/hbase-1.2.0-cdh5.15.2/lib
2.3 重启 Region Servers
# 停止Hbase

stop-hbase.sh

# 启动Hbase

start-hbase.sh
2.4 启动Phoenix
在 Phoenix 解压目录下的 bin 目录下执行如下命令,需要指定 Zookeeper 的地址:
- 如果 HBase 采用 Standalone 模式或者伪集群模式搭建,则默认采用内置的 Zookeeper 服务,端口为 2181;
- 如果是 HBase 是集群模式并采用外置的 Zookeeper 集群,则按照自己的实际情况进行指定。
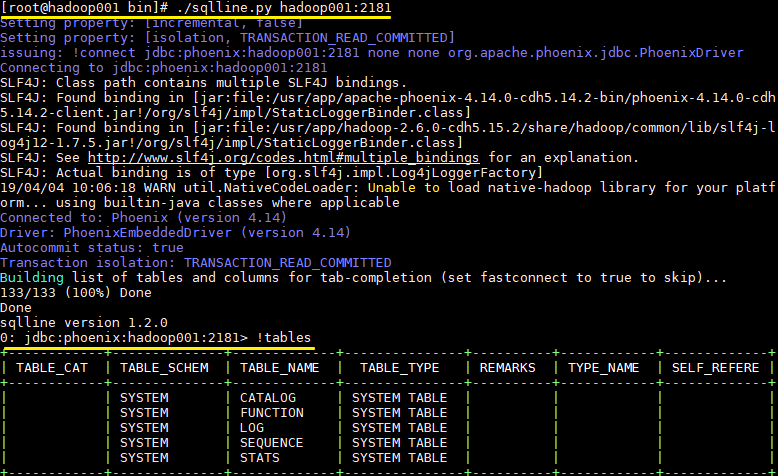
# ./sqlline.py hadoop001:2181
2.5 启动结果
启动后则进入了 Phoenix 交互式 SQL 命令行,可以使用 !table 或 !tables 查看当前所有表的信息
三、Phoenix 简单使用
3.1 创建表
CREATE TABLE IF NOT EXISTS us_population (

      state CHAR(2) NOT NULL,

      city VARCHAR NOT NULL,

      population BIGINT

      CONSTRAINT my_pk PRIMARY KEY (state, city));

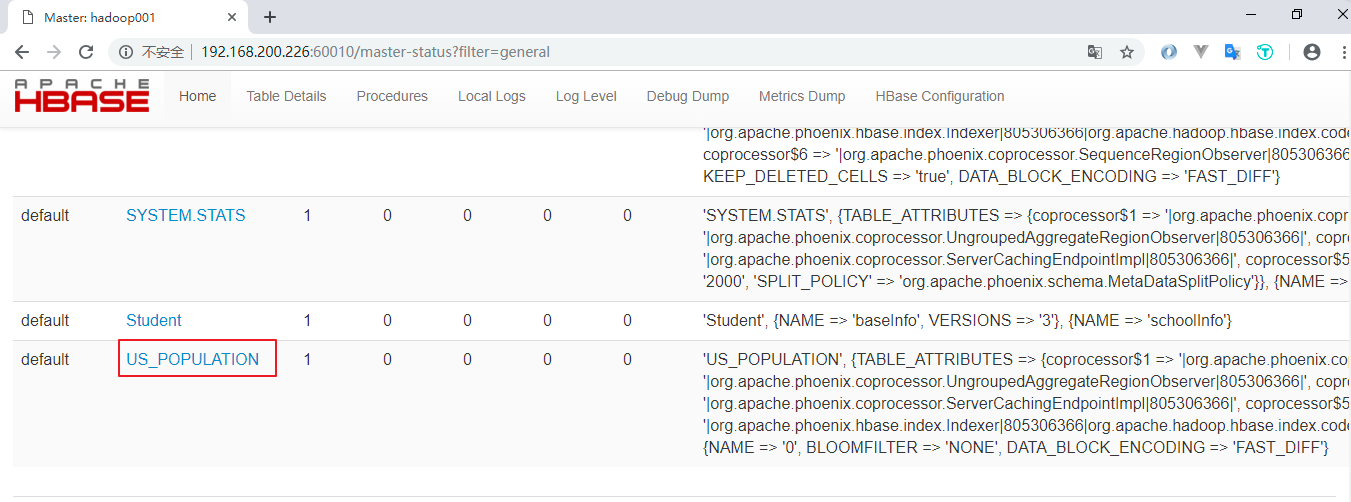
新建的表会按照特定的规则转换为 HBase 上的表,关于表的信息,可以通过 Hbase Web UI 进行查看:
3.2 插入数据
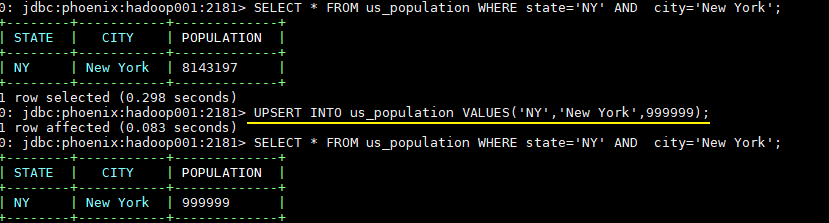
Phoenix 中插入数据采用的是 UPSERT 而不是 INSERT,因为 Phoenix 并没有更新操作,插入相同主键的数据就视为更新,所以 UPSERT 就相当于 UPDATE+INSERT
UPSERT INTO us_population VALUES('NY','New York',8143197);

UPSERT INTO us_population VALUES('CA','Los Angeles',3844829);

UPSERT INTO us_population VALUES('IL','Chicago',2842518);

UPSERT INTO us_population VALUES('TX','Houston',2016582);

UPSERT INTO us_population VALUES('PA','Philadelphia',1463281);

UPSERT INTO us_population VALUES('AZ','Phoenix',1461575);

UPSERT INTO us_population VALUES('TX','San Antonio',1256509);

UPSERT INTO us_population VALUES('CA','San Diego',1255540);

UPSERT INTO us_population VALUES('TX','Dallas',1213825);

UPSERT INTO us_population VALUES('CA','San Jose',912332);
3.3 修改数据
-- 插入主键相同的数据就视为更新

UPSERT INTO us_population VALUES('NY','New York',999999);
3.4 删除数据
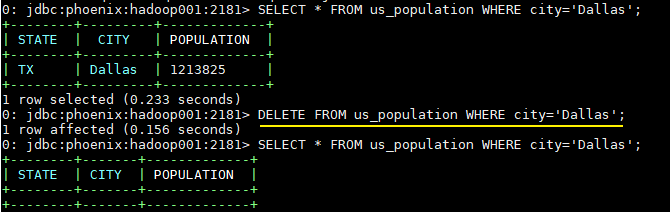
DELETE FROM us_population WHERE city='Dallas';
3.5 查询数据
SELECT state as "州",count(city) as "市",sum(population) as "热度"

FROM us_population

GROUP BY state

ORDER BY sum(population) DESC;

3.6 退出命令
!quit
3.7 扩展
从上面的操作中可以看出,Phoenix 支持大多数标准的 SQL 语法。关于 Phoenix 支持的语法、数据类型、函数、序列等详细信息,因为涉及内容很多,可以参考其官方文档,官方文档上有详细的说明:
语法 (Grammar) :https://phoenix.apache.org/language/index.html
函数 (Functions) :http://phoenix.apache.org/language/functions.html
数据类型 (Datatypes) :http://phoenix.apache.org/language/datatypes.html
序列 (Sequences) :http://phoenix.apache.org/sequences.html
联结查询 (Joins) :http://phoenix.apache.org/joins.html
四、Phoenix Java API
因为 Phoenix 遵循 JDBC 规范,并提供了对应的数据库驱动 PhoenixDriver,这使得采用 Java 语言对其进行操作的时候,就如同对其他关系型数据库一样,下面给出基本的使用示例。
4.1 引入Phoenix core JAR包
如果是 maven 项目,直接在 maven 中央仓库找到对应的版本,导入依赖即可:
 <!-- https://mvnrepository.com/artifact/org.apache.phoenix/phoenix-core -->

    <dependency>

      <groupId>org.apache.phoenix</groupId>

      <artifactId>phoenix-core</artifactId>

      <version>4.14.0-cdh5.14.2</version>

    </dependency>
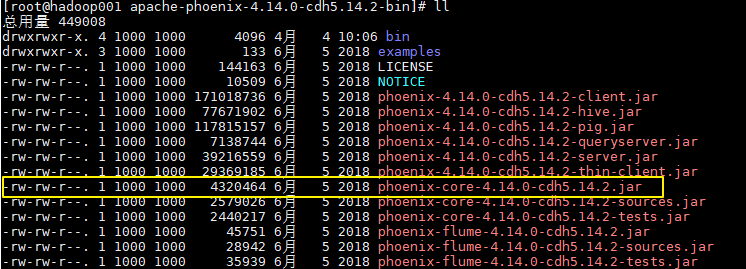
如果是普通项目,则可以从 Phoenix 解压目录下找到对应的 JAR 包,然后手动引入:
4.2 简单的Java API实例
import java.sql.Connection;

import java.sql.DriverManager;

import java.sql.PreparedStatement;

import java.sql.ResultSet;

public class PhoenixJavaApi {

    public static void main(String[] args) throws Exception {

        // 加载数据库驱动

        Class.forName("org.apache.phoenix.jdbc.PhoenixDriver");

        /*

         * 指定数据库地址,格式为 jdbc:phoenix:Zookeeper 地址

         * 如果 HBase 采用 Standalone 模式或者伪集群模式搭建,则 HBase 默认使用内置的 Zookeeper,默认端口为 2181

         */

        Connection connection = DriverManager.getConnection("jdbc:phoenix:192.168.200.226:2181");

        PreparedStatement statement = connection.prepareStatement("SELECT * FROM us_population");

        ResultSet resultSet = statement.executeQuery();

        while (resultSet.next()) {

            System.out.println(resultSet.getString("city") + " "

                    + resultSet.getInt("population"));

        }

        statement.close();

        connection.close();

    }

}
结果如下:

实际的开发中我们通常都是采用第三方框架来操作数据库,如 mybatis,Hibernate,Spring Data 等。关于 Phoenix 与这些框架的整合步骤参见下一篇文章:Spring/Spring Boot + Mybatis + Phoenix
参考资料
入门大数据---Hbase的SQL中间层_Phoenix的更多相关文章
- 入门大数据---Hbase是什么?
一.Hbase是什么? Hbase属于NoSql的一种. NoSql数据库分为如下几类: Key-Value类型数据库 这类数据库主要会使用到一个哈希表,这个表有一个特定的键和一个指针指向特定的数据. ...
- 入门大数据---HBase Shell命令操作
学习方法 可以参考官方文档的简单示例来 点击查看 可以直接在控制台使用help命令查看 例如直接使用help命令: 从上图可以看到,表结构的操作,表数据的操作都展示了.接下来我们可以针对具体的命令使用 ...
- 入门大数据---Hbase 过滤器详解
一.HBase过滤器简介 Hbase 提供了种类丰富的过滤器(filter)来提高数据处理的效率,用户可以通过内置或自定义的过滤器来对数据进行过滤,所有的过滤器都在服务端生效,即谓词下推(predic ...
- 入门大数据---Hbase协处理器详解
一.简述 Hbase 作为列族数据库最经常被人诟病的特性包括:无法轻易建立"二级索引",难以执 行求和.计数.排序等操作.比如,在旧版本的(<0.92)Hbase 中,统计数 ...
- 入门大数据---Hbase容灾与备份
一.前言 本文主要介绍 Hbase 常用的三种简单的容灾备份方案,即CopyTable.Export/Import.Snapshot.分别介绍如下: 二.CopyTable 2.1 简介 CopyTa ...
- 入门大数据---Hbase搭建
环境介绍 tuge1 tuge2 tuge3 tuge4 NameNode NameNode DataNode DataNode ZooKeeper ZooKeeper ZooKeeper ZooKe ...
- 第五章:大数据 の HBase 进阶
本课主题 HBase 读写数据的流程 HBase 性能优化和最住实践 HBase 管理和集群操作 HBase 备份和复制 引言 前一篇 HBase 基础 (HBase 基础) 简单介绍了NoSQL是什 ...
- 第四章:大数据 の HBase 基础
本课主题 NoSQL 数据库介绍 HBase 基本操作 HBase 集群架构与设计介紹 HBase 与HDFS的关系 HBase 数据拆分和紧缩 引言 介绍什么是 NoSQL,NoSQL 和 RDBM ...
- 大数据hbase分布式安装及其部署。
大数据hbase分布式安装及其部署. 首先要启动Hadoop以及zookeeper,可以参考前面发布的文章. 将hbase的包上传至master节点 这里我使用的是1.3.6的版本,具体的根据自己的版 ...
随机推荐
- Java Word中的文本、图片替换功能
Word中的替换功能以查找指定文本然后替换为新的文本,可单个替换或全部替换.以下将要介绍的内容,除常见的以文本替换文本外,还将介绍使用不同对象进行替换的方法,具体可包括: 1. 指定字符串内容替换文本 ...
- Rocket - devices - CLINT
https://mp.weixin.qq.com/s/4LfZZDKCTQhiKIUjvbDKEg 简单介绍CLINT的实现. 1. 概述 CLINT即是Core Local Interrupter的 ...
- 最新 iOS 框架整体梳理(一)
前言 这段话其实是我差不多写完文章之后再回过头来写的,原本在写文章之前想写一下写的初衷的,但当我写完之后感觉初衷没有收获更真切一些.其实到这篇为止总结出来的也就三十多个,有些是比较新的框架,有些是我们 ...
- java方法句柄-----4.你所不知道的MethodHandle【翻译】
Method Handles in Java 1.介绍 在本文中,我们将探讨一个重要的API,它是在Java 7中引入的,并在Java 7版本之后更加完善:全限定名是:Java.lang.invoke ...
- Java实现 LeetCode 211 添加与搜索单词 - 数据结构设计
211. 添加与搜索单词 - 数据结构设计 设计一个支持以下两种操作的数据结构: void addWord(word) bool search(word) search(word) 可以搜索文字或正则 ...
- Java实现第十届蓝桥杯矩形切割
试题 B: 矩形切割 本题总分:5 分 [问题描述] 小明有一些矩形的材料,他要从这些矩形材料中切割出一些正方形. 当他面对一块矩形材料时,他总是从中间切割一刀,切出一块最大的正方 形,剩下一块矩形, ...
- python3 修改计算机名称GUI程序
from tkinter import *from tkinter import messageboximport tkinterimport winregimport osdef serch(): ...
- 容器技术之Docker私有镜像仓库harbor
前文我们聊到了docker的私有镜像仓库docker-distribution的搭建和简单的使用,回顾请参考https://www.cnblogs.com/qiuhom-1874/p/13058338 ...
- 数据结构与算法-python描述-双向链表
# coding:utf-8 # 双向链表的相关操作: # is_empty() 链表是否为空 # length() 链表长度 # travel() 遍历链表 # add(item) 链表头部添加 # ...
- k8s学习-Helm
4.9.Helm 4.9.1.简单使用 概念 文档:https://github.com/helm/helm/blob/master/docs/charts.md 阿里云apphub:https:// ...