
使用jsoup爬取所有成语
前几天看到有人在博问上求所有成语,想到刚好看了jsoup,就动手实践了一下,提问者给出了网站,一看很简单,就两种页面,一种是包含某个字的成语链接页面,一个是具体的包含某个字的成语的页面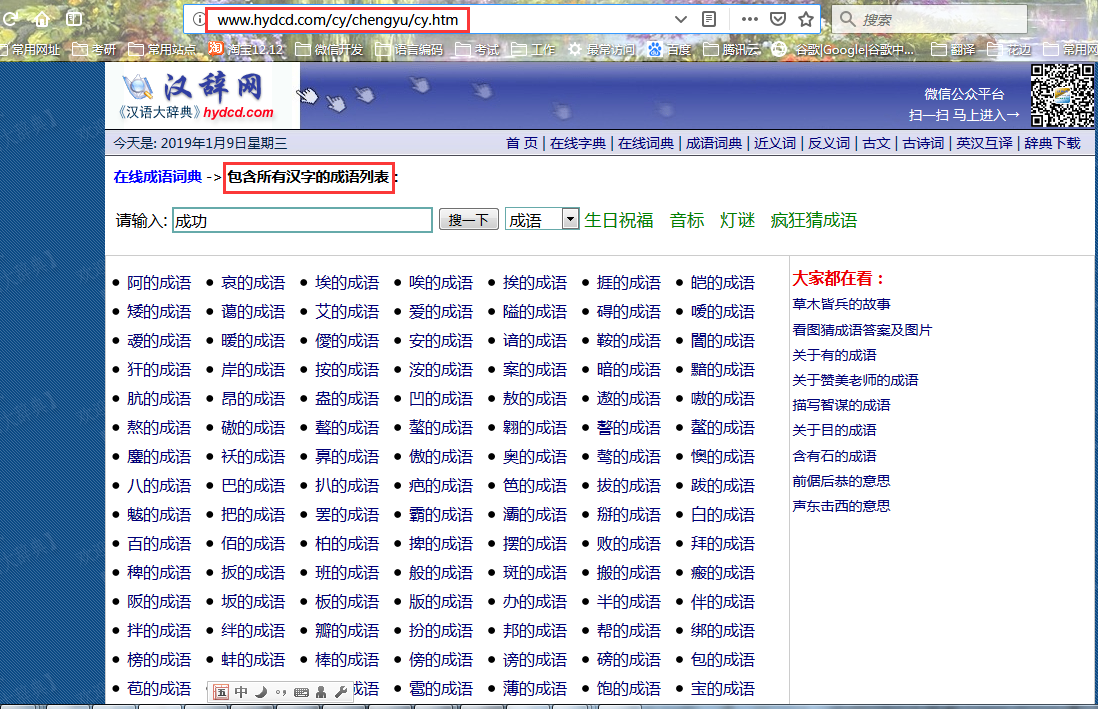
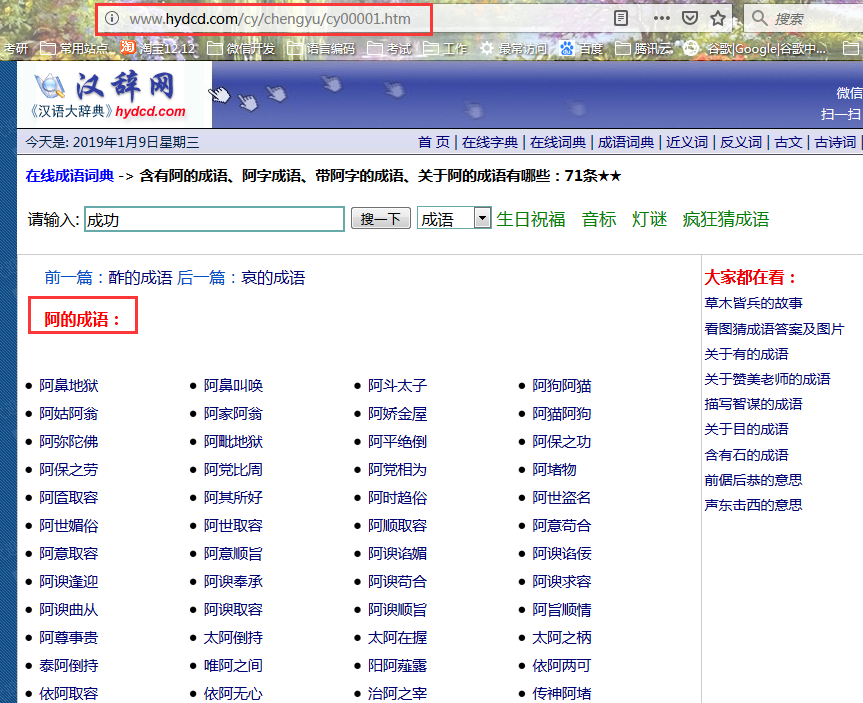
下面是我的代码,用到了jsoup的jar包
package cnblogs.spider;

import java.io.BufferedWriter;

import java.io.File;

import java.io.FileOutputStream;

import java.io.IOException;

import java.io.OutputStreamWriter;

import java.net.URL;

import java.util.ArrayList;

import java.util.List;

import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

public class IdiomScratch

{

    public static void main(String[] args)

    {

        final String url = "http://www.hydcd.com/cy/chengyu/cy.htm";

        final String urlSub = "http://www.hydcd.com/cy/chengyu/";

        BufferedWriter writer = null;

        try

        {

            Document doc = Jsoup.parse(new URL(url).openStream(), "gb18030", "http://www.hydcd.com");

            Element cyTable = doc.getElementById("table1");

            Elements aElements = cyTable.getElementsByTag("a");

            List<String> aHrefs = new ArrayList<String>();

            if(null != aElements && aElements.size() > 0)

            {

                for(int i = 0, size = aElements.size(); i < size; i++)

                {

                    aHrefs.add(urlSub + aElements.get(i).attr("href"));

                }

                File cytxt = new File("c://cengyu.txt");

                if(!cytxt.exists())

                {

                    cytxt.createNewFile();

                }

                writer = new BufferedWriter(new OutputStreamWriter(new FileOutputStream(cytxt)));

                String cy = null;

                for(int i = 0, size = aHrefs.size(); i < size; i++)

                {

                    doc = Jsoup.parse(new URL(aHrefs.get(i)).openStream(), "gb18030", "http://www.hydcd.com");

                    cyTable = doc.getElementById("table1");

                    aElements = cyTable.getElementsByTag("a");

                    if(null != aElements && aElements.size() > 0)

                    {

                        int b = 0;

                        for(int j = 0, size2 = aElements.size(); j < size2; j++)

                        {

                            cy = aElements.get(j).text();

                            writer.write(cy + " ");

                            b++;

                            if(b == 8)

                            {

                                b = 0;

                                writer.write("\r\n");

                            }

                        }

                        writer.write("\r\n");

                        if(b != 0)

                        {

                            writer.write("\r\n");

                        }

                        writer.flush();

                    }

                }

            }

        }

        catch(IOException e)

        {

            e.printStackTrace();

        }

        finally

        {

            if(null != writer)

            {

                try

                {

                    writer.close();

                }

                catch(IOException e)

                {

                    e.printStackTrace();

                }

            }

        }

    }

}
说一下碰到的坑,一开始没有注意编码问题,得到的txt结果中总有一些乱码,后来看网页源码显示编码是gb2312,就换成了gb2312,但还是不对,一想gb2312是简体字的,肯定不能包含所有的成语中的汉字啊,所有就查了一下汉字的编码,发现有gb18030,就用这个试了一下,果然没有乱码了
结果如下:
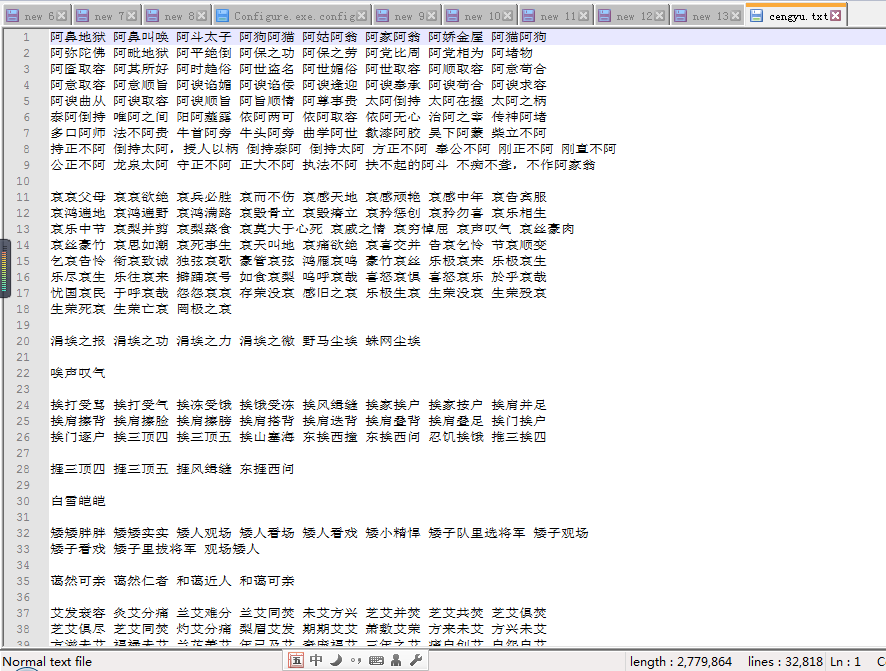
下面是所有成语的txt文件和代码:
使用jsoup爬取所有成语的更多相关文章
- Jsoup爬取带登录验证码的网站
今天学完爬虫之后想的爬一下我们学校的教务系统,可是发现登录的时候有验证码.因此研究了Jsoup爬取带验证码的网站: 大体的思路是:(需要注意的是__VIEWSTATE一直变化,所以我们每个页面都需要重 ...
- jsoup爬取某网站安全数据
jsoup爬取某网站安全数据 package com.vfsd.net; import java.io.IOException; import java.sql.SQLException; impor ...
- 使用Jsoup 爬取网易首页所有的图片
package com.enation.newtest; import java.io.File; import java.io.FileNotFoundException; import java. ...
- java爬虫入门--用jsoup爬取汽车之家的新闻
概述 使用jsoup来进行网页数据爬取.jsoup 是一款Java 的HTML解析器,可直接解析某个URL地址.HTML文本内容.它提供了一套非常省力的API,可通过DOM,CSS以及类似于jQuer ...
- 使用Jsoup爬取网站图片
package com.test.pic.crawler; import java.io.File; import java.io.FileOutputStream; import java.io.I ...
- 如何使用Jsoup爬取网页内容
前言: 这是一篇迟到很久的文章了,人真的是越来越懒,前一阵用jsoup实现了一个功能,个人觉得和selenium的webdriver原理类似,所以今天正好有时间,就又来更新分享了. 实现场景: 爬取博 ...
- 利用Jsoup爬取新冠疫情数据并存至数据库
需要用到的jar包(用来爬取的jsoup,htmlunit-2.37.0-bin以及连接数据库中的mysql.jar) 链接:https://pan.baidu.com/s/1VlylWmlhjd8K ...
- 利用jsoup爬取百度网盘资源分享连接(多线程)
突然有一天就想说能不能用某种方法把百度网盘上分享的资源连接抓取下来,于是就动手了.知乎上有人说过最好的方法就是http://pan.baidu.com/wap抓取,一看果然链接后面的uk值是一串数字, ...
- jsoup爬取网站图片
package com.ij34.JsoupTest; import java.io.File; import java.io.FileOutputStream; import java.io.Inp ...
随机推荐
- XHR HTTP 请求 get post请求解决方案
XHR请求的 测试方式, postman 64位下载地址: http://www.downza.cn/download?file=2017%2F01%2FPostmanwin64493.zip& ...
- [UE4]GameUserSettings
- C/C++ 与 Python 的通信
作者:Jerry Jho链接:https://www.zhihu.com/question/23003213/answer/56121859来源:知乎著作权归作者所有.商业转载请联系作者获得授权,非商 ...
- 逻辑运算符&逻辑短路
(1)and 逻辑与 全真则真,一假则假 print(True and True) #True print(False and True) #False print(False and False) ...
- HBase核心知识和应用案例
Hbase 热点问题? Hbase 预分区 Hbase Rowkey 设计原则 Hbase 常见避免热点问题方法 Hbase 总结 Hbase 连续查询的Rowkey设计 Hbase 随机查询的Row ...
- vue实现未登录跳转到登录页面
环境:vue 2.9.3; webpack;vue-router 目的:实现未登录跳转 例子:直接在url地址栏输入...../home,但是这个页面要求需要登陆之后才能进入,判断的值就通过登陆之后给 ...
- 浅析Redis 和MongoDB
今天来聊聊什么事nosql,一听nosql也许很多人会觉得很高大上的感觉,但其实接触过了也还觉得还行,随着当今数据的疯狂爆炸性的增长,传统的RDBMS也越来越暴露出他的不足之处,所以,作为一名合格的程 ...
- java list按照 对象 指定多个字段属性进行排序
ListUtils.Java---功能类 package PjectUtils; import java.lang.reflect.Field; import java.text.NumberForm ...
- js_字符转Unicode
在开发中总会遇到关于Unicode的转码和解码,每次都找工具转/解码很麻烦 ,今天在网上get到一个简单的转/解Unicode的函数. var UnicodeFun = { toUnicode: fu ...
- 【Linux】【secureCRT】下载,安装,激活攻略
以前公司使用的是SSH访问Linux服务器,今天争取了能看到数据,问了同事使用的是secureCRT,然后自己就装了一个. 下载地址:https://www.vandyke.com/download/ ...