
HBase笔记5(诊断)
阻塞急救:
RegionServer内存设置太小:
解决方案: 设置Region Server的内存要在conf/hbase-env.sh中添加export HBASE_REGIONSERVER_OPTS=" $HBASE_REGIONSERVER_OPTS -Xms8g -Xmx8g"
HFile达到允许的最大数量:
解决方案: 调大hbase.hstore.blockingStoreFiles
memstore大小达到阈值:
解决方案:略微调大hbase.hregion.memstore.flush.size*hbase.hregion.memstore.block
RegionServer上的Memstore总大小达到阈值:
解决方案:适当调大hbase.regionserver.global.memstore.size 调小hfile.block.cache.size
memstore 和 blockcache所占的内存总和《= 系统总内存的80%
朱丽叶暂停:
集群的region server任意一个出现宕机
发生原因:
1)Zookeeper长时间未接收到Region server响应,标记该节点宕机
2)HBase 是基于JVM,大概率遇上Full GC,GC时JVM会停止响应请求,长时间暂停造成zookeeper误认region server宕机
3)region server恢复后发现自己被标记为宕机,自己只能自杀了
解决方案:
1)查看内存是否够用
修改hbase-env.sh 中的HBASE_REGIONSERVER_OPTS选项,增加或调大-Xmx 和 -Xms值

2)调整zookeeper超时时间
在hbase-site.xml增加以下配置项zookeeper.session.timeout
<property>
<name>zookeeper.session.timeout</name>
<vaule>18000</value> 设置成180秒
</property>
确定最终超时时间: 1)先查看conf/zoo.cfg中tickTime=2000
2)计算最小minSessionTimeout=2 * tickTime =4 秒
3)计算最大maxSessionTimeout=20 * tickTime =40 秒
4) 若zookeeper.session.timeout < minSessionTimeout, 那SessionTimeout 采用 minSessionTimeout
若zookeeper.session.timeout > maxSessionTimeout ,那SessionTimeout采用 maxSessionTimeout
若果Session真的要调到180秒,需要调大tickTime
3)优化GC回收策略
JVM堆内存 < 4GB,那么使用参数 -XX:+UseParNewGC -XX:+UseConcMarkSweepGC
JVM堆内存介于4GB~32GB,使用参数 -XX:+UseParNewGC -XX:+UseConcMarkSweepGC 或-XX:+UseG1GC
JVM堆内存 > 32GB,使用-XX:+UseG1GC
4)配置MSLAB
hbase.hregion.memstore.mslab.enabled=true
hbase.hregion.memstore.chunkpool.maxsize=非0值,取值范围0-1
hbase.hregion.memstore.chunkpool.initialsize=非0值,取值范围0-1,代表预分配chunk占用chunk pool的比例
读性能调优
性能调优方面分为2部分: 调整API用法,调整系统配置
使用过滤器
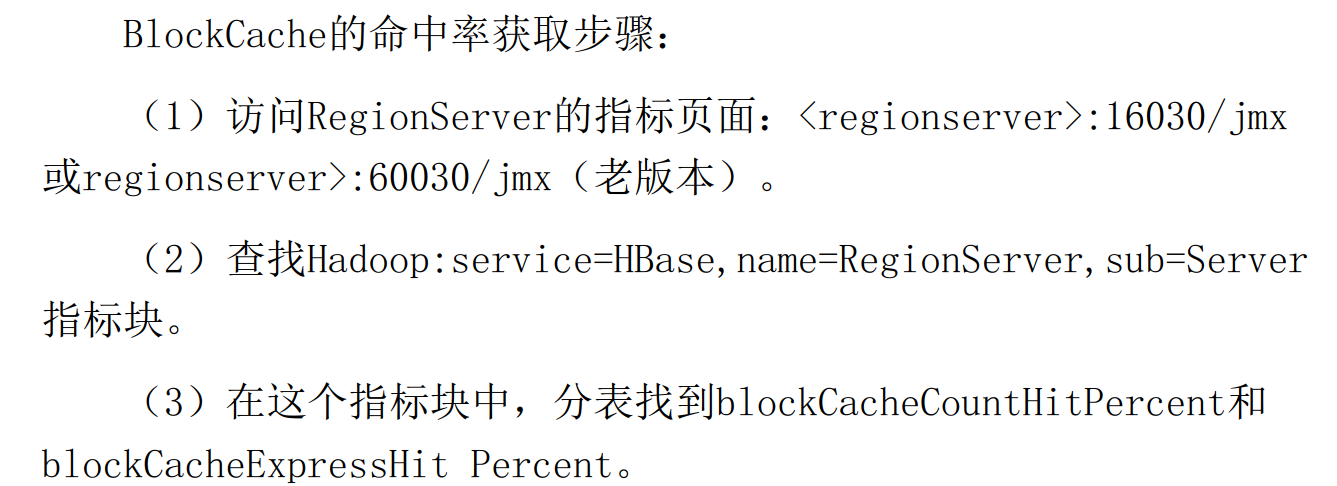
增加blockcache (若果缓存命中率较高,可以提高blockcache大小)
调整HFile合并策略
HBase笔记5(诊断)的更多相关文章
- HBase笔记:对HBase原理的简单理解
早些时候学习hadoop的技术,我一直对里面两项技术倍感困惑,一个是zookeeper,一个就是Hbase了.现在有机会专职做大数据相关的项目,终于看到了HBase实战的项目,也因此有机会搞懂Hbas ...
- Hbase笔记——RowKey设计
一).什么情况下使用Hbase 1)传统数据库无法承载高速插入.大量读取. 2)Hbase适合海量,但同时也是简单的操作. 3)成熟的数据分析主题,查询模式确立不轻易改变. 二).现实场景 1.电商浏 ...
- HBase笔记--自定义filter
自定义filter需要继承的类:FilterBase 类里面的方法调用顺序 方法名 作用 1 boolean filterRowKey(Cell cell) 根据row key过滤row.如果需要 ...
- HBase笔记--filter的使用
HBASE过滤器介绍: 所有的过滤器都在服务端生效,叫做谓语下推(predicate push down),这样可以保证被过滤掉的数据不会被传送到客户端. 注意: 基于字符串的比较器,如 ...
- HBase笔记--编程实战
HBase总结:http://blog.csdn.net/lifuxiangcaohui/article/details/39997205 (very good) Spark使用Java读取hbas ...
- HBase笔记--安装及启动过程中的问题
1.使用hbase shell的时候运行命令执行失败 例如:在shell下执行 status,失败. 可能的原因:节点之间的时间差距过大 解决方法调整两个节点的时间,使二者一致,这里用了个比较笨的方法 ...
- OCP读书笔记(9) - 诊断数据库
数据库恢复顾问 Data Recovery Advisor的命令行选项 1. 启动 RMAN 进程并连接到目标$ rman target=/ 2. 假设发生了某个错误,希望找出原因,使用 list f ...
- HBase笔记6 过滤器
过滤器 过滤器是GET或者SCAN时过滤结果用的,相当于SQL的where语句 HBase中的过滤器创建后会被序列化,然后分发到各个region server中,region server会还原过滤器 ...
- HBase笔记4(调优)
Master/Region Server调优 JVM调优 默认的RegionServer内存是1G,而Memstore默认占40%,即400M,实在是太小了,可以通过HBASE_HEAPSIZE参数修 ...
随机推荐
- 【nodejs】初识 NodeJS(二)
上一节我们构建了一个基础的 http 服务器,我们可以接收 http 请求,但是我们得做点什么吧 – 不同的 http 请求,服务器应该有不同的响应. 路由模块 处理不同的 http 请求在我们的代码 ...
- Java根据子节点递归父节点
先上数据库结构图和树形图: 项目中的一个需求是获取一个商品所属的二级分类名称. 思路分析,首先,我们是可以拿到当前商品所属的子分类的,比如说我买的是一个iPhone SE,对应的分类名称是 iPhon ...
- linux搭建FTP服务器并整合Nginx
操作系统:Centos7 1.1.服务器配置 # 关闭SELINUX,把SELINUX=enforcing改为SELINUX=disabled,reboot重启服务器生效 vim /etc/sysco ...
- HTTP 05 安全
TCP 打包时加密, 报文传输时 加密 通过证书来判断是否是可以访问的客户端/服务器. 公开秘钥 进行加密, 随便被人知道 私有秘钥 进行解密, 自己保留 http + 加密 + 认证 + 完整性保护 ...
- featureCounts 软件说明
featuresCounts 软件用于定量,不仅可以支持gene的定量,也支持exon, gene bodies, genomic bins, chromsomal locations的定量: 官网 ...
- MyBatis 配置多数据源
<?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.sp ...
- OpenGL 获取当前屏幕坐标的三维坐标(gluUnProject使用例子 Qt)
之前使用VS+glut实现了gluUnProject使用例子,用于渲染管道的逆过程,将屏幕坐标转换为opengl三维坐标,本文将尝试使用QT来实现. 代码如下: main.cpp 12345678 ...
- Aspose.Words使用技巧
咨询个问题啊,我在使用aspose生成word,遇到了两个问题,一个是用aspose自动生成的目录的字体与标题的字体一致,但是用户不想他们一致,如何修改:二是,用户只想在正文部分显示页码,目录等页面不 ...
- Dynamic attention in tensorflow
新代码在contrib\seq2seq\python\ops\attention_decoder_fn.py 和之前代码相比 不再采用conv的方式来计算乘,直接使用乘法和linear 给出了两种at ...
- H5常用技巧
工作每天都是接触移动的,特将平时工作中常用的技巧整理总结. 一.@support断定浏览器支持情况定义不同样式 @1像素边框 @supports (-webkit-backdrop-filter:bl ...