
zeppelin的安装与使用
想起马上就能回家了,心情是按捺不住的激动,唉,还是继续努力吧,其实不希望那么快就回家,感觉回去了就意味着马上就要回来了,人真的是神奇呀
今天我们来使用zeppelin,这个就是可以把我们查找的数据可以图形化的方式显示出来,好了,今天开始我们的任务吧
1.首先我们要下载zeppelin的压缩包,当我们解压之后(这一台主机上面已经安装过了java的环境)
2.修改配置环境
进入conf/
将zeppelin-env.sh.template修改为zeppelin-env.sh
将zeppelin-site.xml.template修改为zeppelin-site.xml

然后我们接下来修改conf/zeppelin-env.sh新增
export SPARK_MASTER_IP=192.168.109.136
export SPARK_LOCAL_IP=192.168.109.136
3.启动zeppelin
进入zeppelin:进入bin目录下执行./zeppelin-daemon.sh start
然后浏览器访问192.168.109.136:8080进入界面
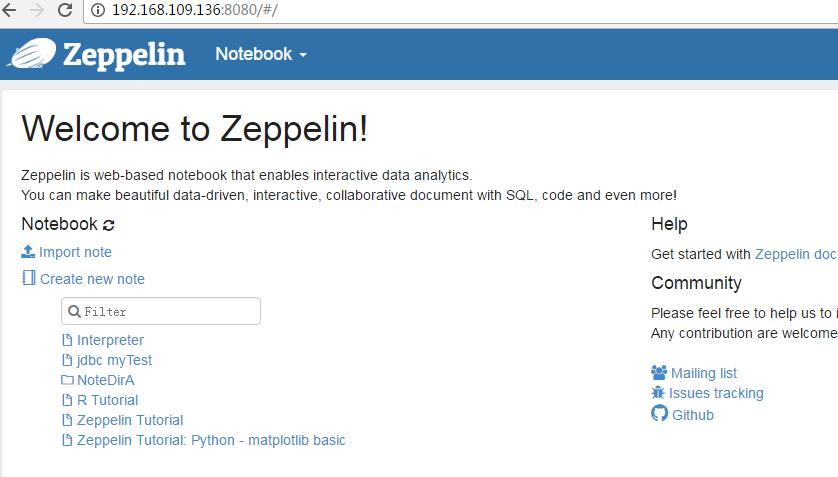
此时就启动成功
4.zeppelin简单实用
1.text
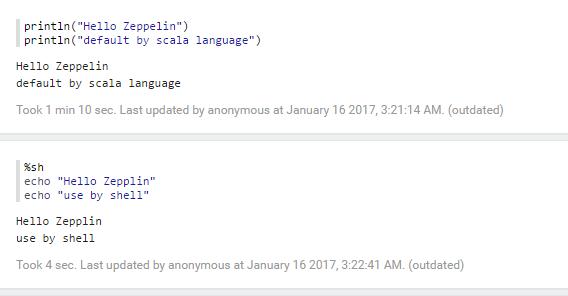
2.html

3.table
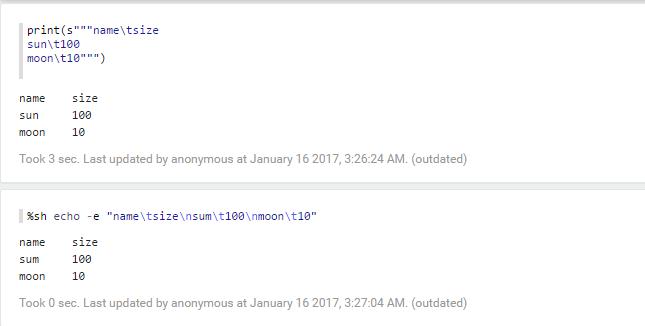

5.可以对数据进行分析
对于我做的最多的分析,就是基于学校的那个资料,我有学校里面的信息,这个里面的每一行的信息是以","
进行分隔,这个其中里面的民族,此时我们对这个民族进行分析
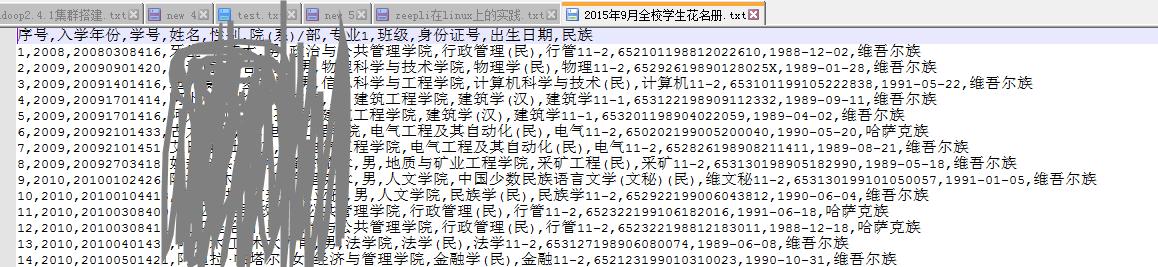
由于我们这个zeppelin是在linux里面的启动,所以我们必须把原有的数据放到linux的里面,此时zeppelin读的文件目录是linux里面的目录
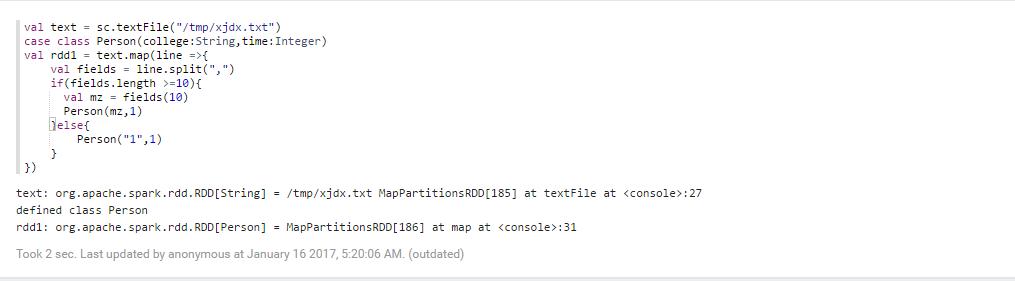
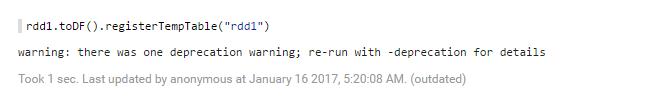


则此时我们就可以对数据库里面的东西进行视图分析,我们通过这个数据,我们发现通过读取数据
,以分组的方式,然后在查询数据有多少个,这样就可以对数据进行显示
a.
val text = sc.textFile("/tmp/xjdx.txt")

case class Person(college:String,time:Integer)

val rdd1 = text.map(line =>{

    val fields = line.split(",")

    if(fields.length >=){

      val mz = fields()

      Person(mz,)

    }else{

        Person("",)

    }

})
b.
rdd1.toDF().registerTempTable("rdd1")
c.
%sql select college,count() from rdd1 group by college
这个里面只是针对于存储介质是文件的形式,对于数据库的那个有问题,我会在以后的章节继续介绍的,敬请期待
zeppelin的安装与使用的更多相关文章
- Spark实战2:Zeppelin的安装和SparkSQL使用总结
zeppelin是spark的web版本notebook编辑器,相当于ipython的notebook编辑器. 一Zeppelin安装 (前提是spark已经安装好) 1 下载https://zepp ...
- Zeppelin的安装和SparkSQL使用总结
zeppelin是spark的web版本notebook编辑器,相当于ipython的notebook编辑器. 一Zeppelin安装 (前提是spark已经安装好) 1 下载https://zepp ...
- centos6.5中部署Zeppelin并配置账号密码验证
centos6.5中部署Zeppelin并配置账号密码验证1.安装JavaZeppelin支持的操作系统如下图所示.在安装Zeppelin之前,你需要在部署的服务器上安装Oracle JDK 1.7或 ...
- Ubuntu下基于Saprk安装Zeppelin
前言 Apache Zeppelin是一款基于web的notebook(类似于ipython的notebook),支持交互式地数据分析,即一个Web笔记形式的交互式数据查询分析工具,可以在线用scal ...
- 安装zeppelin
安装zeppelin 1.默认安装好spark集群 2.安装zeppelin 1.解压安装包 tar zxvf zeppelin-0.5.5-incubating-bin-all.tgz 2.配置环境 ...
- 数据可视化工具zeppelin安装
介绍 zeppelin主要有以下功能 数据提取 数据发现 数据分析 数据可视化 目前版本(0.5-0.6)之前支持的数据搜索引擎有如下 安装 环境 centOS 6.6 编译准备工作 sudo yum ...
- NoteBook学习(二)-------- Zeppelin简介与安装
Zeppelin官网地址: http://zeppelin.apache.org/ Github地址: https://github.com/apache/zeppelin (参照官网) 1.什么是z ...
- Zeppelin 学习笔记之 Zeppelin安装和elasticsearch整合
Zeppelin安装: Apache Zeppelin提供了web版的类似ipython的notebook,用于做数据分析和可视化.背后可以接入不同的数据处理引擎,包括spark, hive, taj ...
- zeppelin安装使用
官网:http://zeppelin-project.org/ 代码:https://github.com/NFLabs/zeppelin 使用:按照官网的视频操作一遍,应该就懂了http://y ...
随机推荐
- C++ 0x
- Conferences
中国学术会议在线 :http://www.meeting.edu.cn 中国会议网: http://www.chinameeting.com 香山科学会议:http://www.xssc.ac.cn/ ...
- Android Studio 导入 AOSP 源码
有了 AOSP 源码,接下来就是如何看了,可以直接文本看,可以用 Source Insight,我当然选择 Android Studio,Android Studio 是我熟悉且十分强大的工具.问题来 ...
- Unity3d开发集成Google Admob广告增加收入
在Unity游戏中植入广告是Unity 游戏产品增加收入的一种重要方式,常用的广告有谷歌Admob,百度ssp,腾讯广点通,unity公司的unityads等等,而使用的最多的应该属于谷歌Admob, ...
- iis 部署网站常见问题
环境IIS6.0,win2003server 首先打开iis,左边菜单选中”Web服务扩展“,讲Active Server Pages 和 ASP.NET v2.0.50727设置为允许 1.创建网站 ...
- Leetcode 78. Subsets (backtracking) 90 subset
using prev class Solution { List<List<Integer>> res = new ArrayList<List<Integer&g ...
- Apache2.4 authz_core_module模块使用
Description: Core Authorization Status: Base Moduledentifier: authz_core_module Sourceile: mod_authz ...
- testng失败重跑
重跑失败场景 1.要添加两个文件 背景:因为这里只是想单独展示失败的重跑的案例,所以先暂时把app这块的运行注释掉,只跑一个简单的demo,就一个简单类,类中就3个测试方法,失败重跑的原理是,运行方法 ...
- centos6.x yum 安装 mysql5.6 mysql5.7
先卸载低版本MYSQL yum remove mysql* rpm -ivh http://repo.mysql.com/mysql-community-release-el6.rpm yum ins ...
- C++STL之map映照容器
map映照容器 map映照容器的元素数据是由一个键值和一个映照数据组成的, 键值与映照数据之间具有一一映照关系. map映照容器的数据结构也是采用红黑树来实现的, 插入元素的键值不允许重复, 比较函数 ...