
SQL server 常用语句
SQL Server中常用的SQL语句
1、概述
名词
笛卡尔积、主键、外键
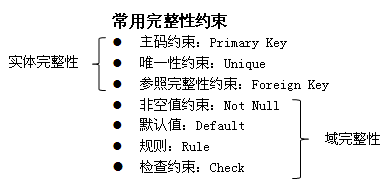
数据完整性
- 实体完整性:主属性不能为空值,例如选课表中学号和课程号不能为空
- 参照完整性:表中的外键取值为空或参照表中的主键
- 用户定义完整性:取值范围或非空限制,例如:性别(男女),年龄(0-130)
表连接
- 自然连接:与等值连接(a.id=b.id)相比,连接后的表只有一列id,而不是两列(a.id和b.id)。
- 半连接:与等值连接(a.id=b.id)相比,连接后的表只有A表的列,被B表“多次匹配”列会显示为一行。
- 左外连接:left join
- 右外连接:right join
- 全外连接:full join
- 全内连接:inner join
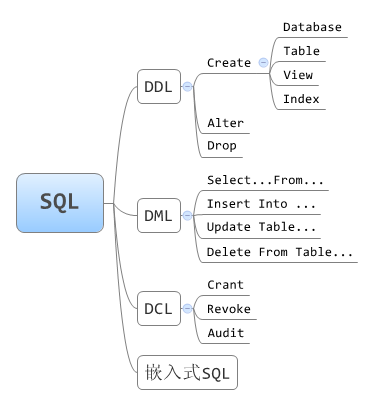
SQL语言的构成
- DDL语言:数据定义,定义基本表、视图、索引;
- DML语言:数据操纵,查询、增加、修改、删除
- DCL语言:权限
2、查询概述
查询包括:单表查询、连接查询、带有exists的相关子查询、集合操作四中。select...from常用语句执行过程
select…            ⑤    投影

from…              ①    table→内存

where…             ②    选取元组

group…             ③    分组

having…            ④    选择分组

[{union|…}         ⑥    查徇结果的集      合运算

select…  ]         ①~⑤

order by…          ⑦    排序输出
3、单表查询
group by 只有出现在group by子句中的属性,才可出现在select子句中。
用order by子句对查询结果按照一个或多个列的值进行升/降排列输出,升序为ASC;降序为desc,空值将作为最大值排序
having 与 where的区别
- where 决定哪些元组被选择参加运算,作用于关系中的元组
- having 决定哪些分组符合要求,作用于分组
4、连接查询
连接查询包括:多表连接查询、单表连接查询(自连接)、外连接查询、嵌套查询4种
连接条件一
[表名1.] 列名1 比较运算符 [表名2.]列名2
连接条件二
[表名1.]列名1 between [表名2.]列名2 and [表名2.]列名3
连接条件中的列名称为连接字段,对应的连接字段应是可比的。
执行过程:采用表扫描的方法,在表1中找到第一个元组,然后从头开始扫描表2,查找到满足条件的元组即进行串接并存入结果表中;再继续扫描表2,依次类推,直到表2末尾。再从表1中取第二个元组,重复上述的操作,直到表1中的元组全部处理完毕。
4.1 单表连接(自连接)
用表别名把一个表定义为两个不同的表进行连接。
例:查找至少选修了2号和4号课程的学生的学号
select FIRST.sno

from SC as FIRST, SC as SECOND

where FIRST.Sno=SECOND.Sno and FIRST.cno='s2' and SECOND.cno='4'
4.2 外连接查询
外连接查询包括:Left join、right join、full join
4.3 嵌套查询
- 在select … from … where语句结构的where子句中可嵌入一个select语句块
- 其上层查询称为外层查询或父查询,其下层查询称为内层查询或子查询
- SQL语言允许使用多重嵌套查询
- 在子查询中不允许使用order by子句
- 嵌套查询的实现一般是从里到外,即先进行子查询,再把其结果用于父查询作为条件
4.3.1 返回单个值的子查询
例:求与“刘力”同一个系的学生名,年龄
方法一:

select Sname, Sage

from student

where Sdept = (select sdept from student where  Sname = "刘力");

方法二:

select FIRST.Sname, FIRST.Sage

from Student FIRST, Student SECOND

where FIRST.Sdept = SECOND.Sdept AND SECOND.Sname = "刘力";
4.3.2 返回一组值的子查询
例:求选修“C6”课程且成绩超过90分的学生
方法一:

select * from

student

where sno IN (select sno from SC where Cno="C6" AND Grade>90);

方法二(连接查询 ):

select student.*

from student,SC

where Student.Sno=SC.Sno AND Cno="C6" AND Grade>90;
例:求比计算机系中某一学生年龄小的其他系的学生
方法一:

select *

from student

where

    sdept!="CS" AND

    sage < ANY (select Sage from Student where Sdept="CS");

方法二:

select  *

from Student

where

   Sdept!=’CS’ AND

   Sage < (select MAX(Sage) from Student where Sdept="CS");
4.3.3 多重子查询
例:求D01部门中工资与国贸系中任意职工相同的职工姓名和工资
表结构:

Teacher(tno, tname, salary, dno)

Department(dno, dname)

查询语句:

select Tname,Salary

from Teacher

where

    Dno = "D01" AND

    salary IN(

        select salary from  teacher

        where Dno =(select DNO from department where  Dname="国贸")

    );
例:求工资介于“张三”与“里司”两个之间的职工
select *

from teacher

where

    Salary >= (select MIN(Salary) from teacher where Tname IN ("张三", "里司")) AND

    Salary <= (select MAX(Salary) from teacher where Tname IN ("张三", "里司");
4.3.4 在from语句中使用子查询,对查询结果定义表名及列名
例:求平均成绩超过80分的学号及平均成绩
select Sno, avg_G

from (select Sno, avg(Grade) from SC group by Sno) AS RA(Sno, avg_G)

where avg_G > 80;
AS RA(Sno, avg_G),为查询作为定义表名(RA)和列名(Sno, avg_G)
5、带有exists的相关子查询
- 不相关子查询:子查询的查询条件不依赖于父查询的称为不相关子查询。
- 相关子查询:子查询的查询条件依赖于外层父查询的某个属性值的称为相关子查询,带exists 的子查询就是相关子查询
- exists表示存在量词,带有exists的子查询不返回任何记录的数据,只返回逻辑值“True” 或“False”
例:求所有选修了“C1”课程的学生名。
不相关子查询:

select Sname from student where sno IN ( select sno from SC where Cno = "C1" );

相关子查询

select Sname from student

where exists (select * from SC where student.sno=SC.sno AND Cno = "C1" );
相关子查询执行过程:先在外层查询中取student表的第一个元组(记录),用该记录的相关的属性值(在内层where子句中给定的)处理内层查询,若外层的where子句返回‘TRUE’值,则此元组送入结果的表中。然后再取下一个元组;重复上述过程直到外层表的记录全部遍历一次为止。
- 不关心子查询的具体内容,因此用 select *
- exists + 子查询用来判断该子查询是否返回元组
- 当子查询的结果集非空时,exists 为“True”;当子查询的结果集为空时,exists为“False”。
- not exists :若子查询结果为空,返回“TRUE”值,否则返回“FALSE”
例:查询选修了所有课程的学生的姓名(续)
select Sname

from student

where not exists (

    select *

    from Course

    where not exists (

        select * from SC where

        student.sno=SC.sno AND Course.Cno=SC.Cno

    )

);
例:查询至少选修了S1所选的全部课程的学生名
select Sname

from student

where not exists(

    select *

    from SC SCX

    where

        SCX.sno="s1" AND

        not exists (

            select *

            from SC SCY

            where student.sno=SCY.sno AND SCX.Cno=SCY.Cno

        )

);
6、SQL的集合操作
- 属性个数必须一致、对应的类型必须一致
- 属性名可以不一致, 最终结果集采用第一个结果的属性名
- 缺省为自动去除重复元组,除非显式说明ALL
- order by放在整个语句的最后
6.1 “并”操作,例:查询计算机系的学生或者年龄不大于19岁的学生,并按年龄倒排序。
select * from student where Sdept="CS"

UNION

select * from student where AGE <= 19

order by AGE desc
6.2 “交”操作,例:查询计算机系的学生并且年龄不大于19岁的学生,并按年龄倒排序。
(select * from student where Sdept = "CS")

INTERSECT

(select * from student where AGE <= 19)

order by AGE desc
6.3 “差”操作,例:查询选修课程1但没有选修课程2的学生。
select Sname, Sdept

from student

where sno IN (

    (select sno from SC where Cno="1")

    EXCEPT

    (select sno from SC where Cno="2")

)
7、插入操作
格式:insert into 表名[(列名1,…)] values (列值1,…)
插入一已知元组的全部列值
insert into student values("2003001", "陈冬", 18, "男", "电商", "管理学院", "徐州");
插入一已知元组的部分列值
insert into SC(Sno,Cno) values ("2003001", "C003");
插入子查询的结果
例:设关系S_G(Sno,avg_G),把平均成绩大于80的男生的学号及平均成绩存入S_G中
insert into S_G(sno,avg_G) (

    select sno, avg(GRADE)

    from SC

    where Sno IN (select Sno from Student where SEX="男")

    group  by  Sno

    having  avg(GRADE) > 80

);
8、删除操作
格式:

delete from 表名 [where 条件];
- 只能对整个元组操作,不能只删除某些属性上的值
- 只能对一个关系(表)起作用,若要从多个关系(表)中删除元组,则必须对每个关系分别执行删除命令
9、修改操作
update语句一次只能操作一个表。
格式1:

update 表名 [别名]

set 列名 = 表达式, ...

[where 条件];

格式2:

update 表名 [别名]

set (列名, ...) = (子查询)

[where 条件];
例:工种为SALESMEN的职工的工资改为工种平均工资的110%
update EMPLOYEE

set Salary = (select 1.1 * avg(Salary) from EMPLOYEE where JOB="SALESMEN")

where JOB="SALESMEN";
例:将所有学生的年龄增加1岁
update student set Sage=Sage+1;
10、数据定义
创建课程表
create table SC (

    sno CHAR(6) not null,

    Cno CHAR(6) not null,

    Grade smallint default null

)

primary key (sno,Cno)

foreign key (sno) references student(sno)

foreign key (Cno) references Course(Cno)

check (Grade between 0 AND 100);
常用的索引:唯一索引和聚簇索引
唯一索引
- 对于已含重复值的属性列不能建UNIQUE索引
- 对某个列建立UNIQUE索引后,插入新记录时DBMS会自动检查新记录在该列上是否取了重复值。这相当于增加了一个UNIQUE约束
create UNIQUE INDEX Stusno ON Student(Sno ASC);
聚簇索引
建立聚簇索引后,基表中数据也需要按指定的聚簇属性值的升序或降序存放。也即聚簇索引的索引项顺序与表中记录的物理顺序一致
create CLUSTER INDEX Stusname ON Student(Sname);
在Student表的Sname(姓名)列上建立一个聚簇索引,而且Student表中的记录将按照Sname值的升序存放。Sql server中的表示方式create clustered index。某些DMBS不支持聚簇索引,所以用前一定要查使用说明。
- 在一个基本表上最多只能建立一个聚簇索引
- 聚簇索引的用途:对于某些类型的查询,可以提高查询效率
- 聚簇索引的适用范围:很少对基表进行增删操作;很少对其中的变长列进行修改操作
删除索引
删除索引时,系统会从数据字典中删去有关该索引的描述。
DROP INDEX [表名.]<索引名>;
例:删除Student表的Stusname索引
DROP INDEX Student.Stusname;
11、视图
例:建立电商系学生的视图
create view ec_student

as

select sno, sname, age from student where dept="ec"
删除视图
DROP VIEW <视图名>
一个视图被删除后,由此视图导出的其他视图也将失效,用户应该使用DROP VIEW语句将他们一一删除
SQL server 常用语句的更多相关文章
- SQL Server常用语句
欢迎和大家交流技术相关问题: 邮箱: jiangxinnju@163.com 博客园地址: http://www.cnblogs.com/jiangxinnju GitHub地址: https://g ...
- sql server 常用的系统存储过程
系统存储过程 说明 sp_databases 列出服务上的所有数据库 sp_helpdb 报告有关指定数据库或所有数据库的信息 sp_renamedb 更改数据库的名称 sp_tables 返回当 ...
- SQL SERVER常用语法记录
用于记录SQL SERVER常用语法,以及内置函数. 以下语句包含: WITH 临时表语法 ROW_NUMBER()内置函数,我一般主要是用来分页.针对于查出来的所有数据做一个数字排序 分页的BETW ...
- 如何在SQL Server查询语句(Select)中检索存储过程(Store Procedure)的结果集?
如何在SQL Server查询语句(Select)中检索存储过程(Store Procedure)的结果集?(2006-12-14 09:25:36) 与这个问题具有相同性质的其他描述还包括:如何 ...
- SQL Server分页语句ROW_NUMBER,读取第4页数据,每页10条
SQL Server分页语句ROW_NUMBER,读取第4页数据,每页10条 SELECT Id,[Title],[Content],[Image] FROM ( SELECT ROW_NUMBER( ...
- SQL Server UPDATE语句的用法详解
SQL Server UPDATE语句用于更新数据,下面就为您详细介绍SQL Server UPDATE语句语法方面的知识,希望可以让您对SQL Server UPDATE语句有更多的了解. 现实应用 ...
- SQL Server中语句的自动参数化
原文:SQL Server中语句的自动参数化 use master go if exists(select * from sys.databases where name = 'test') drop ...
- sql server常用函数、常用语句
一.常用函数 1.字符串函数 : charindex(':','abc:123') --寻找一个字符在一段字符串中起始的位置 len('zhangsan') --获取一段字符串的长度 lef ...
- 自己整理的常用SQL Server 2005 语句、
--创建数据库 create database 数据库 go --打开数据库 use 数据库 --删除数据库 drop database 数据库 Go --创建数据表 create table 数据表 ...
随机推荐
- event.keyCode ,event.which ,event.charCode (2016-12-27 16:17:16)
javascript判断是否按回车键 <input id="chatMsg" name="chatMsg" type="text" s ...
- 日文xp系统中 日文键盘模式转英式键盘模式
键盘设备驱动早在Windows XP安装时就已经安装好了,但是系统却将日式键盘误识成了美式标准键盘,这会出现一些标点符号的实际输入与键盘标注不符的问题,对于用惯了英文键盘的人可 以盲打而不去理会,但对 ...
- amgular $q用法
amgular $q用法 在用JQuery的时候就知道 promise 是 Js异步编程模式的一种模式,但是不是很明白他跟JQuery的deferred对象有什么区别.随着公司项目的进行,要跟后台 ...
- SpringMVC框架下的拦截器
在eclipse的javaEE环境下:导包.... web.xml文件中的配置: <?xml version="1.0" encoding="UTF-8" ...
- Uva 1629 切蛋糕
题目链接:https://vjudge.net/contest/146179#problem/B 题意:一个矩形蛋糕上有好多个樱桃,现在要做的就是切割最少的距离,切出矩形形状的小蛋糕,让每个蛋糕上都有 ...
- Python 对目录中的文件进行批量转码(GBK>UTF8)
通过python实现对文件转码,其实处理很简单: 1.打开读取文件内容到一个字符串变量中,把gbk编码文件,对字符串进行decode转换成unicode 2.然后使用encode转换成utf-8格式. ...
- centos6安装python3.4和pip3
在安装了epel源的情况下,直接yum就可以安装python3.4 yum install python34 -ypython3 --version 没有自带pip3,从官网安装 wget --no- ...
- TensorFlow白皮书
TensorFlow [1] is an interface for expressing machine learning algorithms, and an implementation for ...
- Element is not currently interactable and may not be manipulated
Element is not currently interactable and may not be manipulated:元素当前不可交互,并且可能无法操作. 解决方法: 调用该方法,智能等待 ...
- Mysql Specified key was too long; max key length is 767 bytes
今天导入一个数据库时,看到以下报错信息: Specified key was too bytes 直译就是索引键太长,最大为767字节. 查看sql库表文件,发现有一列定义如下: 列 名:cont ...