
CentOS7+hadoop2.6.4+spark-1.6.1
环境:
CentOS7
hadoop2.6.4已安装两个节点:master、slave1
过程:
把下载的scala、spark压缩包拷贝到/usr/hadoop-2.6.4/thirdparty目录下。
安装scala:
$ sudo tar -zxvf scala-2.11..tgz
修改环境变量文件 /etc/profile,添加以下内容:
export SCALA_HOME=/usr/hadoop-2.6./thirdparty/scala-2.11.

export PATH=$PATH:$SCALA_HOME/bin
source 使之生效
$ source /etc/profile
验证 Scala 安装

slave1参照 master 机器安装步骤进行安装。
Spark 安装:
解压
$ sudo tar -zxvf spark-1.6.1-bin-hadoop2.6.tgz
修改环境变量文件 /etc/profile, 添加以下内容
export SPARK_HOME=/usr/hadoop-2.6./thirdparty/spark-1.6.-bin-hadoop2.

export PATH=$PATH:$SPARK_HOME/bin
source 使之生效
$ source /etc/profile
Spark 配置
进入 Spark 安装目录下的 conf 目录, 拷贝 spark-env.sh.template 到 spark-env.sh
$ cp spark-env.sh.template spark-env.sh
在其中添加以下配置信息:
export SCALA_HOME=/usr/hadoop-2.6./thirdparty/scala-2.10.

export JAVA_HOME=/usr/java/jdk1..0_101

export HADOOP_HOME=/usr/hadoop-2.6.

export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop

export SPARK_MASTER_IP=192.168.23.101

export SPARK_LOCAL_DIRS=/usr/hadoop-2.6./thirdparty/spark-1.6.-bin-hadoop2.

export SPARK_WORKER_MEMORY=512m
JAVA_HOME 指定 Java 安装目录;
SCALA_HOME 指定 Scala 安装目录;
SPARK_MASTER_IP 指定 Spark 集群 Master 节点的 IP 地址;
SPARK_WORKER_MEMORY 指定的是 Worker 节点能够分配给 Executors 的最大内存大小;
HADOOP_CONF_DIR 指定 Hadoop 集群配置文件目录。
SPARK_WORKER_MEMORY 根据主机内存设置spark运行内存大小。
slaves
将 slaves.template 拷贝到 slaves
$ sudo cp slaves.template slaves
编辑其内容为
master

slave1
设置spark安装目录的所有组/用户:
$ sudo chown -R hadoop:hadoop spark-1.6.-bin-hadoop2.
slave1参照 master 机器安装步骤进行安装。
启动 Spark 集群
启动 Hadoop 集群
$ start-dfs.sh
启动 Spark 集群
启动 Master 节点
运行 $SPARK_HOME/sbin 下面, start-master.sh
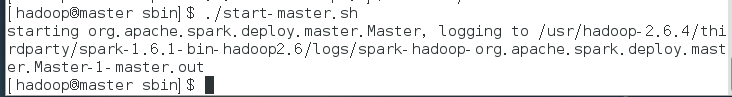
jps查看进程,多了一个Master进程

启动所有 Worker 节点
运行 $SPARK_HOME/sbin 下面,start-slaves.sh
jps查看进程,可以发现多了一个Work进程。
(由于虚拟机性能较差,因此后续步骤未实际验证,仅供参考)
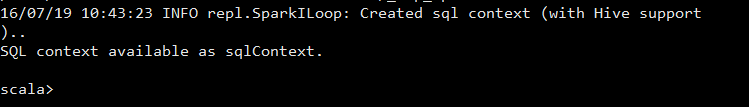
运行 spark-shell,可以进入 Spark 的 shell 控制台
浏览器访问 SparkUI
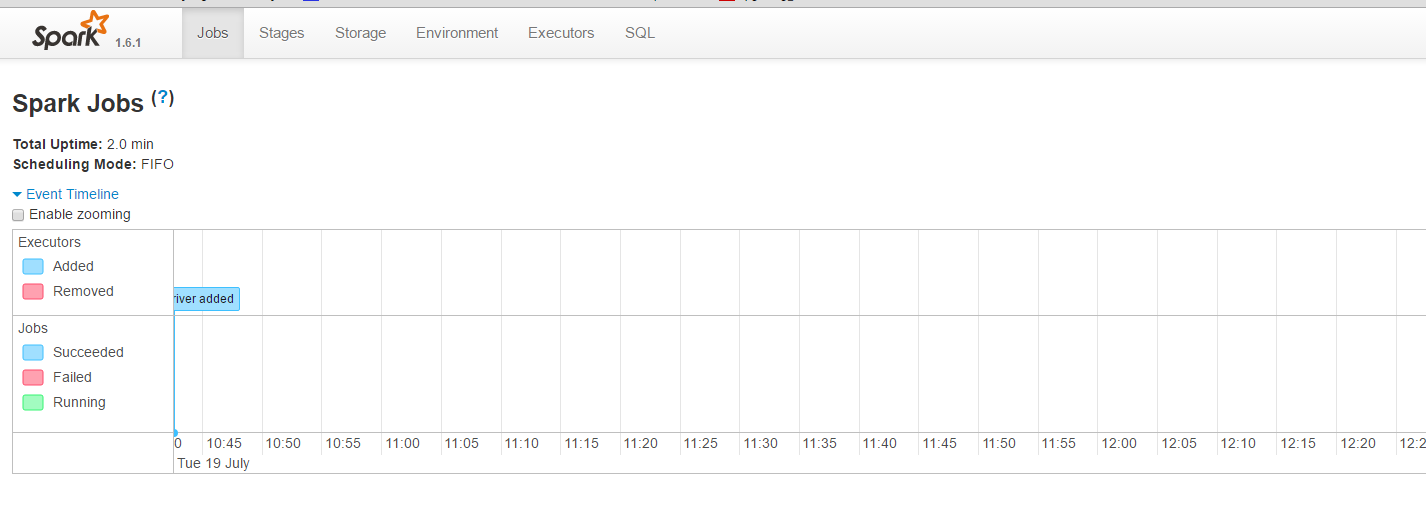
可以从 SparkUI 上查看一些 如环境变量、Job、Executor等信息。
至此,整个 Spark 分布式集群的搭建就到这里结束。
停止 Spark 集群
停止 Master 节点
运行$SPARK_HOME/sbin,下面的stop-master.sh 来停止 Master 节点。
停止 Slaves 节点
运行$SPARK_HOME/sbin,下面的stop-slaves.sh (注意是stop-slavers 有s) 可以停止所有的 Worker 节点
最后再停止 Hadoop 集群。
原文地址:http://blog.csdn.net/sa14023053/article/details/51953836
CentOS7+hadoop2.6.4+spark-1.6.1的更多相关文章
- Linux上安装Hadoop集群(CentOS7+hadoop-2.8.0)
1下载hadoop 2安装3个虚拟机并实现ssh免密码登录 2.1安装3个机器 2.2检查机器名称 2.3修改/etc/hosts文件 2.4 给3个机器生成秘钥文件 2.5 在hserver1上创建 ...
- Linux上安装Hadoop集群(CentOS7+hadoop-2.8.3)
https://blog.csdn.net/pucao_cug/article/details/71698903 1下载hadoop 2安装3个虚拟机并实现ssh免密码登录 2.1安装3个机器 2.2 ...
- Linux上安装Hadoop集群(CentOS7+hadoop-2.8.0)--------hadoop环境的搭建
Linux上安装Hadoop集群(CentOS7+hadoop-2.8.0)------https://blog.csdn.net/pucao_cug/article/details/71698903 ...
- 在虚拟机下安装hadoop集成环境(centos7+hadoop-2.6.4+jdk-7u79)
[1]64为win7系统,用virtualbox建立linux虚拟机时,为什么没有64位的选项? 百度 [2]在virtualbox上安装centos7 [3]VirtualBox虚拟机网络环境解析和 ...
- centos7安装Scala、Spark(伪分布式)
centos7安装spark(伪分布式) spark是由scala语言开发的,首先需要安装scala. Scala安装 下载scala-2.11.8,(与spark版本要对应) 命令:wget htt ...
- CentOS7+Hadoop2.7.2(HA高可用+Federation联邦)+Hive1.2.1+Spark2.1.0 完全分布式集群安装
1 2 2.1 2.2 2.3 2.4 2.5 2.6 2.7 2.8 2.9 2.9.1 2.9.2 2.9.2.1 2.9.2.2 2.9.3 2.9.3.1 2.9.3.2 2.9.3.3 2. ...
- Hadoop2.0/YARN深入浅出(Hadoop2.0、Spark、Storm和Tez)
随着云计算.大数据迅速发展,亟需用hadoop解决大数据量高并发访问的瓶颈.谷歌.淘宝.百度.京东等底层都应用hadoop.越来越多的企 业急需引入hadoop技术人才.由于掌握Hadoop技术的开发 ...
- Centos7+hadoop2.7.3+jdk1.8
修改主机名 1. 修改主机名 vi /etc/sysconfig/network ,改为 master , slave1 , slave2 2. source /etc/sy ...
- Linux中基于hadoop安装hive(CentOS7+hadoop2.8.0+hive2.1.1)
http://blog.csdn.net/pucao_cug/article/details/71773665
随机推荐
- CSS中margin与padding的区别
CSS边距属性定义元素周围的空间.通过使用单独的属性,可以对上.右.下.左的外边距进行设置.也可以使用简写的外边距属性同时改变所有的外边距.——W3School 边界(margin):元素周围生成额外 ...
- mysql安装方法
Window版本 1.下载 MySQL Community Server 5.7.16 http://dev.mysql.com/downloads/mysql/ 2.解压 如果想要让MySQL安装在 ...
- 《锋利的jQuery》读书笔记
jQuery理念:write less, do more! 第 一 章一:jQuery简介 a:轻量级 b:强大选择器 c:DOM封装 d:ajax封装 e:不污染顶级变量 只建立一个jQuery对象 ...
- [转]JAVA设计模式之单例模式
原文地址:http://blog.csdn.net/jason0539/article/details/23297037 概念: java中单例模式是一种常见的设计模式,单例模式的写法有好几种,这里主 ...
- Activiti 学习笔记(2016-8-30)
前言 不管学习什么,都必须对知识体系中专有的名词或者特定的语言组织方式 有所了解. 本文仅记录学习过程中的笔记,参考意义因人而定,不保证所言全部正确. 学习方式,百度传课的视频<权威Activi ...
- 数据库开发基础-SQl Server 主键、外键、子查询(嵌套查询)
主键 数据库主键是指表中一个列或列的组合,其值能唯一地标识表中的每一行.这样的一列或多列称为表的主键,通过它可强制表的实体完整性.当创建或更改表时可通过定义 PRIMARY KEY约束来创建主键.一个 ...
- 控件(文本类): TextBox, PasswordBox
介绍背水一战 Windows 10 之 控件(文本类) TextBox PasswordBox 示例1.TextBox 的示例 1Controls/TextControl/TextBoxDemo1.x ...
- 18 BufferedReader使用方法
生成BufferedReader对象的方法: BufferedReader in=new BufferedReader(new FileReader("foo.in")); imp ...
- iOS 蓝牙开发(三)app作为外设被连接的实现(转)
转载自:www.cocoachina.com/ios/20151105/14071.html 原作者:刘彦玮 再上一节说了app作为central连接peripheral的情况,这一节介绍如何使用ap ...
- 【BZOJ-1912】patrol巡逻 树的直径 + DFS(树形DP)
1912: [Apio2010]patrol 巡逻 Time Limit: 4 Sec Memory Limit: 64 MBSubmit: 1034 Solved: 562[Submit][St ...