
Python爬虫scrapy-redis分布式实例(一)
目标任务:将之前新浪网的Scrapy爬虫项目,修改为基于RedisSpider类的scrapy-redis分布式爬虫项目,将数据存入redis数据库。
一、item文件,和之前项目一样不需要改变
# -*- coding: utf-8 -*-

import scrapy

import sys

reload(sys)

sys.setdefaultencoding("utf-8")

class SinanewsItem(scrapy.Item):

    # 大类的标题和url

    parentTitle = scrapy.Field()

    parentUrls = scrapy.Field()

    # 小类的标题和子url

    subTitle = scrapy.Field()

    subUrls = scrapy.Field()

    # 小类目录存储路径

    subFilename = scrapy.Field()

    # 小类下的子链接

    sonUrls = scrapy.Field()

    # 文章标题和内容

    head = scrapy.Field()

    content = scrapy.Field()
二、spiders爬虫文件,使用RedisSpider类替换之前的Spider类,其余地方做些许改动即可,具体代码如下:
# -*- coding: utf-8 -*-

import scrapy

import os

from sinaNews.items import SinanewsItem

from scrapy_redis.spiders import RedisSpider

import sys

reload(sys)

sys.setdefaultencoding("utf-8")

class SinaSpider(RedisSpider):

    name = "sina"
    # 启动爬虫的命令

    redis_key = "sinaspider:strat_urls"

  # 动态定义爬虫爬取域范围

    def __init__(self, *args, **kwargs):

        domain = kwargs.pop('domain', '')

        self.allowed_domains = filter(None, domain.split(','))

        super(SinaSpider, self).__init__(*args, **kwargs)

    def parse(self, response):

        items= []

        # 所有大类的url 和 标题

        parentUrls = response.xpath('//div[@id="tab01"]/div/h3/a/@href').extract()

        parentTitle = response.xpath('//div[@id="tab01"]/div/h3/a/text()').extract()

        # 所有小类的ur 和 标题

        subUrls  = response.xpath('//div[@id="tab01"]/div/ul/li/a/@href').extract()

        subTitle = response.xpath('//div[@id="tab01"]/div/ul/li/a/text()').extract()

        #爬取所有大类

        for i in range(0, len(parentTitle)):

            # 爬取所有小类

            for j in range(0, len(subUrls)):

                item = SinanewsItem()

                # 保存大类的title和urls

                item['parentTitle'] = parentTitle[i]

                item['parentUrls'] = parentUrls[i]

                # 检查小类的url是否以同类别大类url开头,如果是返回True (sports.sina.com.cn 和 sports.sina.com.cn/nba)

                if_belong = subUrls[j].startswith(item['parentUrls'])

                # 如果属于本大类,将存储目录放在本大类目录下

                if(if_belong):

                    # 存储 小类url、title和filename字段数据

                    item['subUrls'] = subUrls[j]

                    item['subTitle'] =subTitle[j]

                    items.append(item)

        #发送每个小类url的Request请求,得到Response连同包含meta数据 一同交给回调函数 second_parse 方法处理

        for item in items:

            yield scrapy.Request( url = item['subUrls'], meta={'meta_1': item}, callback=self.second_parse)

    #对于返回的小类的url,再进行递归请求

    def second_parse(self, response):

        # 提取每次Response的meta数据

        meta_1= response.meta['meta_1']

        # 取出小类里所有子链接

        sonUrls = response.xpath('//a/@href').extract()

        items= []

        for i in range(0, len(sonUrls)):

            # 检查每个链接是否以大类url开头、以.shtml结尾,如果是返回True

            if_belong = sonUrls[i].endswith('.shtml') and sonUrls[i].startswith(meta_1['parentUrls'])

            # 如果属于本大类,获取字段值放在同一个item下便于传输

            if(if_belong):

                item = SinanewsItem()

                item['parentTitle'] =meta_1['parentTitle']

                item['parentUrls'] =meta_1['parentUrls']

                item['subUrls'] = meta_1['subUrls']

                item['subTitle'] = meta_1['subTitle']

                item['sonUrls'] = sonUrls[i]

                items.append(item)

        #发送每个小类下子链接url的Request请求,得到Response后连同包含meta数据 一同交给回调函数 detail_parse 方法处理

        for item in items:

                yield scrapy.Request(url=item['sonUrls'], meta={'meta_2':item}, callback = self.detail_parse)

    # 数据解析方法,获取文章标题和内容

    def detail_parse(self, response):

        item = response.meta['meta_2']

        content = ""

        head = response.xpath('//h1[@id="main_title"]/text()')

        content_list = response.xpath('//div[@id="artibody"]/p/text()').extract()

        # 将p标签里的文本内容合并到一起

        for content_one in content_list:

            content += content_one

        item['head']= head[0] if len(head) > 0 else "NULL"

        item['content']= content

        yield item
三、settings文件设置
SPIDER_MODULES = ['sinaNews.spiders']

NEWSPIDER_MODULE = 'sinaNews.spiders'

# 使用scrapy-redis里的去重组件,不使用scrapy默认的去重方式

DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"

# 使用scrapy-redis里的调度器组件,不使用默认的调度器

SCHEDULER = "scrapy_redis.scheduler.Scheduler"

# 允许暂停,redis请求记录不丢失

SCHEDULER_PERSIST = True

# 默认的scrapy-redis请求队列形式(按优先级)

SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.SpiderPriorityQueue"

# 队列形式,请求先进先出

#SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.SpiderQueue"

# 栈形式,请求先进后出

#SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.SpiderStack"

# 只是将数据放到redis数据库,不需要写pipelines文件

ITEM_PIPELINES = {

#    'Sina.pipelines.SinaPipeline': 300,

    'scrapy_redis.pipelines.RedisPipeline': 400,

}

# LOG_LEVEL = 'DEBUG'

# Introduce an artifical delay to make use of parallelism. to speed up the

# crawl.

DOWNLOAD_DELAY = 1

# 指定数据库的主机IP

REDIS_HOST = "192.168.13.26"

# 指定数据库的端口号

REDIS_PORT = 6379
执行命令:
本次直接使用本地的redis数据库,将settings文件中的REDIS_HOST和REDIS_PORT注释掉。
启动爬虫程序
scrapy runspider sina.py
执行程序后终端窗口显示如下:
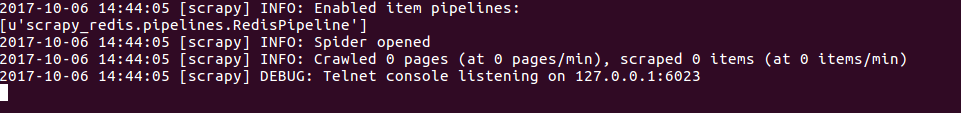
表示程序处于等待状态,此时在redis数据库端执行如下命令:
redis-cli> lpush sinaspider:start_urls http://news.sina.com.cn/guide/
http://news.sina.com.cn/guide/为起始url,此时程序开始执行。
Python爬虫scrapy-redis分布式实例(一)的更多相关文章
- 爬虫--scrapy+redis分布式爬取58同城北京全站租房数据
作业需求: 1.基于Spider或者CrawlSpider进行租房信息的爬取 2.本机搭建分布式环境对租房信息进行爬取 3.搭建多台机器的分布式环境,多台机器同时进行租房数据爬取 建议:用Pychar ...
- python爬虫Scrapy(一)-我爬了boss数据
一.概述 学习python有一段时间了,最近了解了下Python的入门爬虫框架Scrapy,参考了文章Python爬虫框架Scrapy入门.本篇文章属于初学经验记录,比较简单,适合刚学习爬虫的小伙伴. ...
- python爬虫项目(scrapy-redis分布式爬取房天下租房信息)
python爬虫scrapy项目(二) 爬取目标:房天下全国租房信息网站(起始url:http://zu.fang.com/cities.aspx) 爬取内容:城市:名字:出租方式:价格:户型:面积: ...
- python爬虫scrapy框架——人工识别登录知乎倒立文字验证码和数字英文验证码(2)
操作环境:python3 在上一文中python爬虫scrapy框架--人工识别知乎登录知乎倒立文字验证码和数字英文验证码(1)我们已经介绍了用Requests库来登录知乎,本文如果看不懂可以先看之前 ...
- python爬虫scrapy项目详解(关注、持续更新)
python爬虫scrapy项目(一) 爬取目标:腾讯招聘网站(起始url:https://hr.tencent.com/position.php?keywords=&tid=0&st ...
- Python爬虫Scrapy框架入门(0)
想学习爬虫,又想了解python语言,有个python高手推荐我看看scrapy. scrapy是一个python爬虫框架,据说很灵活,网上介绍该框架的信息很多,此处不再赘述.专心记录我自己遇到的问题 ...
- Python爬虫教程-新浪微博分布式爬虫分享
爬虫功能: 此项目实现将单机的新浪微博爬虫重构成分布式爬虫. Master机只管任务调度,不管爬数据:Slaver机只管将Request抛给Master机,需要Request的时候再从Master机拿 ...
- [Python爬虫] scrapy爬虫系列 <一>.安装及入门介绍
前面介绍了很多Selenium基于自动测试的Python爬虫程序,主要利用它的xpath语句,通过分析网页DOM树结构进行爬取内容,同时可以结合Phantomjs模拟浏览器进行鼠标或键盘操作.但是,更 ...
- 安装python爬虫scrapy踩过的那些坑和编程外的思考
这些天应朋友的要求抓取某个论坛帖子的信息,网上搜索了一下开源的爬虫资料,看了许多对于开源爬虫的比较发现开源爬虫scrapy比较好用.但是以前一直用的java和php,对python不熟悉,于是花一天时 ...
- Python 爬虫-Scrapy爬虫框架
2017-07-29 17:50:29 Scrapy是一个快速功能强大的网络爬虫框架. Scrapy不是一个函数功能库,而是一个爬虫框架.爬虫框架是实现爬虫功能的一个软件结构和功能组件集合.爬虫框架是 ...
随机推荐
- CentOS定位、查找文件的命令
定位.查找文件的命令 命令 功能 命令 功能 which 从path中找出文件的位置 find 找出所有符合要求的文件 whereis 找出特定程序的路径 locate 从索引中找出文件位置 9.1 ...
- NET Core 环境搭建和命令行CLI入门[转]
NET Core 环境搭建和命令行CLI入门 时间:2016-07-06 01:48:19 阅读:258 评论:0 收藏:0 [点我收藏+] 标签: N ...
- 浮点纹理 opengl
原文地址:http://wangqingyun84.blog.163.com/blog/static/790836172010323113604/ 因为 glsl部分 绑定fbo 看到要用浮点纹理,搜 ...
- 接口日志记录AOP实现-LogAspect
使用spring aop日志记录 所需jar包 pom.xml <!-- logger begin --> <dependency> <groupId>org.sl ...
- TMS320F28335项目开发记录3_28335简介
28335特性介绍 高性能静态CMOS技术 高达150MHZ(6.67ns的周期时间):1.9V / 1.8内核 ,3.3V I/O设计 高性能32位CPU IEEE- ...
- 如何在word文档中添加mathtype加载项
MathType是强大的数学公式编辑器,通常与office一起使用,mathtype安装完成后,正常情况下会在word文档中的菜单中自动添加mathtype加载项,但有时也会出现小意外,mathtyp ...
- 【matlab】error:试图访问 im2(1,1211);由于 size(im2)=[675,1210],索引超出范围。
试图访问 im2(1,1211):由于 size(im2)=[675,1210],索引超出范围. 出错 dect (line 14) if abs((im2(i,j))-(im1(i,j)))> ...
- JavaScript第五天之数组
<script> var a=[1,2,3]; //var a=new Array(1,2,3); //alert(a.length); alert(a[0]); </script& ...
- mysql数据库binary log中的事件到底是什么?
需求描述: 最近看mysql备份恢复的时候,基于时间点恢复,提到了binary log中存的是"事件" 那么到底什么是事件呢 概念解释: binary log中存的是事件(even ...
- Codeforces Round #313 D. Equivalent Strings(DFS)
D. Equivalent Strings time limit per test 2 seconds memory limit per test 256 megabytes input standa ...