
scrapy安装和框架内容
在cdm中:直接,pip install scrapy
有可能让你升级一下pip先,就输入这个:python -m pip install --upgrade pip
当它报错的话,看看它是缺了什么,少啥补啥(我的是Python3.6.6,安装scrapy的时候报错,缺了twisted),注意选对Python版本就好,下面是各个模块的下载地址:
lxml:
https://www.lfd.uci.edu/~gohlke/pythonlibs/#lxml
pyOpenSSL:
https://pypi.org/project/pyOpenSSL/#files
twisted:
https://www.lfd.uci.edu/~gohlke/pythonlibs/#twisted
pywin32(这个不会提示你安装,但如果缺了的话,scrapy执行爬虫的时候会报错):
sourceforge.net/projects/pywin32/files/pywin32/Build%20220/(不一定能自动检测到Python3.6的exe)
https://pypi.org/project/pypiwin32/220/
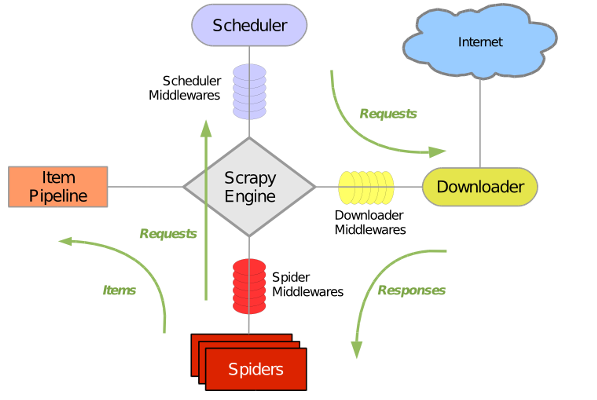
Scrapy主要包括了以下组件:
- 引擎(Scrapy)
用来处理整个系统的数据流, 触发事务(框架核心) - 调度器(Scheduler)
用来接受引擎发过来的请求, 压入队列中, 并在引擎再次请求的时候返回. 可以想像成一个URL(抓取网页的网址或者说是链接)的优先队列, 由它来决定下一个要抓取的网址是什么, 同时去除重复的网址 - 下载器(Downloader)
用于下载网页内容, 并将网页内容返回给蜘蛛(Scrapy下载器是建立在twisted这个高效的异步模型上的) - 爬虫(Spiders)
爬虫是主要干活的, 用于从特定的网页中提取自己需要的信息, 即所谓的实体(Item)。用户也可以从中提取出链接,让Scrapy继续抓取下一个页面 - 项目管道(Pipeline)
负责处理爬虫从网页中抽取的实体,主要的功能是持久化实体、验证实体的有效性、清除不需要的信息。当页面被爬虫解析后,将被发送到项目管道,并经过几个特定的次序处理数据。 - 下载器中间件(Downloader Middlewares)
位于Scrapy引擎和下载器之间的框架,主要是处理Scrapy引擎与下载器之间的请求及响应。 - 爬虫中间件(Spider Middlewares)
介于Scrapy引擎和爬虫之间的框架,主要工作是处理蜘蛛的响应输入和请求输出。 - 调度中间件(Scheduler Middewares)
介于Scrapy引擎和调度之间的中间件,从Scrapy引擎发送到调度的请求和响应。
Scrapy运行流程大概如下:
- 引擎从调度器中取出一个链接(URL)用于接下来的抓取
- 引擎把URL封装成一个请求(Request)传给下载器
- 下载器把资源下载下来,并封装成应答包(Response)
- 爬虫解析Response
- 解析出实体(Item),则交给实体管道进行进一步的处理
- 解析出的是链接(URL),则把URL交给调度器等待抓取
scrapy安装和框架内容的更多相关文章
- Python -- Scrapy 框架简单介绍(Scrapy 安装及项目创建)
Python -- Scrapy 框架简单介绍 最近在学习python 爬虫,先后了解学习urllib.urllib2.requests等,后来发现爬虫也有很多框架,而推荐学习最多就是Scrapy框架 ...
- 第三百三十一节,web爬虫讲解2—Scrapy框架爬虫—Scrapy安装—Scrapy指令
第三百三十一节,web爬虫讲解2—Scrapy框架爬虫—Scrapy安装—Scrapy指令 Scrapy框架安装 1.首先,终端执行命令升级pip: python -m pip install --u ...
- Python的两个爬虫框架PySpider与Scrapy安装
Python的两个爬虫框架PySpider与Scrapy安装 win10安装pyspider: 最好以管理员身份运行CMD,不然可能会出现拒绝访问文件夹的情况! pyspider:pip instal ...
- python爬虫框架—Scrapy安装及创建项目
linux版本安装 pip3 install scrapy 安装完成 windows版本安装 pip install wheel 下载twisted,网址:http://www.lfd.uci.edu ...
- python Scrapy安装和介绍
python Scrapy安装和介绍 Windows7下安装1.执行easy_install Scrapy Centos6.5下安装 1.库文件安装yum install libxslt-devel ...
- 在windows下如何新建爬虫虚拟环境和进行scrapy安装
Scrapy是Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy吸引人的地方在于它是一个框架,任何人都可以根据需求方便的修改.Sc ...
- Windows下安装Scrapy方法及常见安装问题总结——Scrapy安装教程
这几天,很多朋友在群里问Scrapy安装的问题,其实问题方面都差不多,今天小编给大家整理一下Scrapy的安装教程,希望日后其他的小伙伴在安装的时候不再六神无主,具体的教程如下. Scrapy是Pyt ...
- python网络爬虫(14)使用Scrapy搭建爬虫框架
目的意义 爬虫框架也许能简化工作量,提高效率等.scrapy是一款方便好用,拓展方便的框架. 本文将使用scrapy框架,示例爬取自己博客中的文章内容. 说明 学习和模仿来源:https://book ...
- 第五篇 scrapy安装及目录结构,启动spider项目
实际上安装scrapy框架时,需要安装很多依赖包,因此建议用pip安装,这里我就直接使用pycharm的安装功能直接搜索scrapy安装好了. 然后进入虚拟环境创建一个scrapy工程: (third ...
随机推荐
- 从后台传select的值
var option = ''; $.each(data, function (i, v) { option += "<option value='" + i + " ...
- [转]history.back(-1)和history.go(-1)的区别
目录: 1.这个方法的用途 2.两个方法的区别 3.总结 概述: H5页面做多了,自然就会做到页面上的返回功能,返回功能大致有两种:history.back(-1)和history.go(-1),今天 ...
- IEnumerable、GetEnumerator、IEnumerator之间的关系。
了解了这些也就明白了遍历的原理,晚安. using System; using System.Collections; public class Person { public Person(stri ...
- http服务 WCF、Web API、Web service、WCF REST之间的区别
http服务 WCF.Web API.Web service.WCF REST之间的区别 在.net平台下,有大量的技术让你创建一个HTTP服务,像Web Service,WCF,现在又出了Web ...
- android android各种应用的许可
android各种应用的许可 在Android的设计中,资源的访问或者网络连接,要得到这些服务都需要声明其访问权限,否则将无法正常工作.在Android中这样的权限有很多种,这里将各类访问权限一一罗列 ...
- 新增扩展程序功能打包提交新版 WARNING ITMS-90473 警告问题
1.问题描述 自从在主应用中加入SiriShortCut功能之后,打包程序上传至 iTunes Connect 就会出现警告,看其原因描述是CFBundleVersion主应用与子应用的不一致导致的 ...
- CLion中出现错误add_dependencies called with incorrect number of arguments解决
出现这个错误以后我以为是IDE出现问题了,可是重新启动,打开其他的工程文件以后发现并没有这个错误,但是新建的文件却报错 然后就打开其他工程的Cmake_list.txt文件,发现最后一行是有工程文件夹 ...
- web渗透测试(上传漏洞)
一句话木马—— 一句话木马短小精悍,而且功能强大,隐蔽性非常好,在入侵中扮演着强大的作用. 黑客在注册信息的电子邮箱或者个人主页等插入类似如下代码: <%execute request(“val ...
- 华为敏捷/DevOps实践:产品经理如何开好迭代计划会议
大家好,我是华为云DevCloud项目管理服务的产品经理恒少,作为布道师和产品经理,出差各地接触客户是常态,线下和华为云的客户交流.布道.技术沙龙. 但是线下交流,覆盖的用户总还是少数.我希望借助线上 ...
- 190310HTML&CSS&JS
一.HTML 1.web server import socket def handle_request(client): buf = client.recv(1024) client.send(by ...