
Robots协议一定放在网站根目录下
一.网络爬虫的尺寸
1.以爬取网页,玩转网页为目的进行小规模,数据量小对爬取速度不敏感的可以使用request库实现功能(占90%)
2.以爬取网站或爬取系列网站为目的,比如说获取一个或多个旅游网站的爬虫,对数据要求规模较大,爬取速度敏感的可以使用Scrapy库
3.以爬取全网为目的,规模很大搜索引擎爬取速度关键,需要定制开发
二.网络爬虫带来的问题
总的来说有:骚扰问题,法律风险,隐私泄露
1.爬虫可利用计算机的快速功能访问服务器,它会比人类的速度快到百倍甚至千倍,受限于编写水平和目的,网络爬虫将会为web服务器带来巨大的资源开销。对网站运行者来讲,爬虫形成了骚扰。
2.网络爬虫会带来法律风险。服务器上的数据有产权归属,比如新浪上的新闻规新浪所有,如果网络爬虫获取数据牟利后将会带来法律风险。
3.网络爬虫会造成隐私泄露。网络爬虫可能具备突破简单访问控制的能力,或得被保护数据从而泄露个人隐私。
三.网络爬虫的限制
来源审查:判断User-Agent进行限制
检查来访HTTP协议头的User-Agent域,只响应浏览器或友好爬虫的访问。
发布公告: Robots协议
告知所有爬虫网站的爬取策略,要求爬虫遵守。
四.Robots协议
作用:网站会告知网络爬虫哪些页面可以抓取,哪些不行
形式:在网站根目录下的robots.txt文件。
下面我自己做了一个实例 打开京东的Robots协议 https://www.jd.com/robots.txt
会出现下面几句话
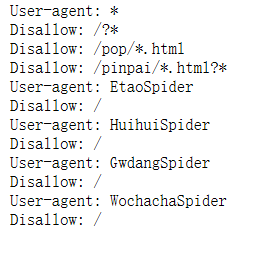
大概的意思是所有爬虫都要遵守以下协定
任何爬虫都不允许访问?* 即?号开头的网页
任何爬虫都不允许访问pop*.html开头的网页
任何爬虫都不允许访问pinpai*.html开头的网页
此外 EtaoSpider HuihuiSpidder GwdangSpider WochachaSpider这四个网络爬虫都不能爬取京东的任何数据
五.Robots协议基本语法
*代表所有 /代表根目录
User-agent: 代表哪些爬虫
Disallow:你不允许访问资源的目录
六.其他注意
1.Robots协议一定放在网站根目录下
2.http://www.news.sina.com.cn/robots.txt和http://www.sina.com.cn/robots.txt它们的Robots协议是不一样的
3.如果一个网站没有Robots协议,是允许所有爬虫无限制爬取
Robots协议一定放在网站根目录下的更多相关文章
- 【转载】Asp.net网站安全:去除网站根目录下的备份文件防止代码泄露
很多网站运维人员在更新网站版本的时候,喜欢直接在网站目录文件夹中直接压缩原来的网站文件,如果这个备份压缩文件没有移动出去,这样是非常不安全的,有些网站攻击者可能会尝试访问你网站下有没有对应名字的压缩备 ...
- asp.net在网站根目录下创建文件夹
假设要在asp.net网站的根目录下建立文件夹hovertree,C#代码如下: string m_keleyiFolderName = Server.MapPath("/hovertree ...
- linux centos无法删除网站根目录下的.user.ini解决办法
.user.ini文件在执行rm -rf时,提示无法删除 解决办法 首先了解下chattr命令的作用:不让用户修改.删除文件等. -i选项:设定文件不能被删除.改名.设定链接关系,同时不能写入或新增内 ...
- 网络爬虫引发的问题及robots协议
一.网络爬虫的尺寸 1.以爬取网页,玩转网页为目的进行小规模,数据量小对爬取速度不敏感的可以使用request库实现功能(占90%) 2.以爬取网站或爬取系列网站为目的,比如说获取一个或多个旅游网站的 ...
- vue中打包之后的dist文件不放在服务器的根目录下
在工作当中,我使用webpack打包的dist,由于管理的问题,无法被放在服务器根目录下 ,但在目前的vue配置,dist不放在根目录下,访问页面会成为一片空白,于是便要对vue框架的config进行 ...
- Robots协议(爬虫协议、机器人协议)
Robots协议(也称为爬虫协议.机器人协议等)的全称是“网络爬虫排除标准”(Robots Exclusion Protocol),网站通过Robots协议告诉搜索引擎哪些页面可以抓取,哪些页面不能抓 ...
- Robots协议(摘)
robots协议 Robots协议(也称为爬虫协议.机器人协议等)的全称是“网络爬虫排除标准”(Robots Exclusion Protocol),网站通过Robots协议告诉搜索引擎哪些页面可以抓 ...
- Python 爬虫-Robots协议
2017-07-25 21:08:16 一.网络爬虫的规模 二.网络爬虫的限制 • 来源审查:判断User‐Agent进行限制 检查来访HTTP协议头的User‐Agent域,只响应浏览器或友好爬虫的 ...
- 爬虫的盗亦有道Robots协议
爬虫的规定 Robots协议 网站开发者对于网络爬虫的规范的公告,你可以不遵守可能存在法律风险,但尽量去遵守 Robots协议:在网页的根目录+robots.txt Robots协议的基本语法: #注 ...
随机推荐
- PHP开启错误提示而不是单单返回500
方法一 修改php.ini文件和php-fpm.conf php.ini文件在我使用的发行版本/etc/php/<版本号>/cli/php.ini php-fpm.conf文件在/etc/ ...
- WTL项目各种error的解决方法
error RC1015: cannot open include file 'atlres.h' 解决办法: 向“VC项目属性->资源->附加包含目录” 添加WTL的Include目录( ...
- 百度AI训练营笔记
参加了两天百度AI训练营,简单记录一下学到的东西 一.知识图谱 知识图谱是让机器具有积累知识.运用知识的本领. 由于目前知识量很大,所以人工标注的方法无法满足,可以采用数据驱动.自底向上的方式自动构建 ...
- Eclipse快捷键和IDEA对比
- BZOJ 3551: [ONTAK2010]Peaks加强版 Kruskal重构树+dfs序+主席树+倍增
建出来 $Kruskal$ 重构树. 将询问点向上跳到深度最小,且合法的节点上. 那么,得益于重构树优美的性质,这个最终跳到的点为根的所有子节点都可以与询问点互达. 对于子树中求点权第 $k$ 大的问 ...
- vue中的js绑定样式
添加class 对象形式添加 activated为true时p标签的class为activated false时为空 <div id="app"> <p :c ...
- /static/fonts/SIMYOU.TTF’ 字体
/** * pdf 加水印 * * @return */ public byte[] pdfAddWaterMark(byte[] byes) { String fileName = UUID.ran ...
- idea 编译内存溢出
idea.max.intellisense.filesize=9999 idea.max.content.load.filesize=99999 idea.cycle.buffer.size=disa ...
- Static class 与non static class的区别
内部静态类不需要有指向外部类的引用.但非静态内部类需要持有对外部类的引用.非静态内部类能够访问外部类的静态和非静态成员.静态类不能访问外部类的非静态成员.他只能访问外部类的静态成员.一个非静态内部类不 ...
- vue网址路由的实时检测
有些时候,我们需要实时的检测网址,来进行判断,操作,处理等等 我们需要使用 watch 的监视器,然后直接进行操作 我们需要 ’$route.path‘ 属性来进行监听,且需要加引号,然后只要页面 ...