
4.10:Spark之wordcount
〇、概述
1、拓扑结构
2、目标
使用spark完成计数实验
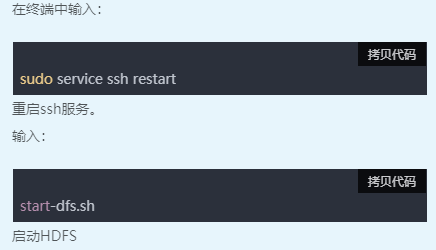
一、启动环境
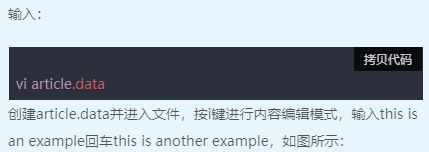
二、新建数据文件
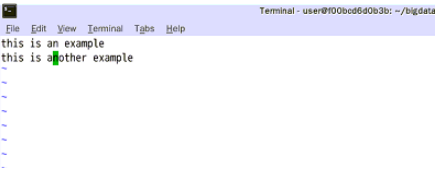
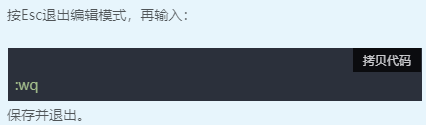
三、查看文件内容
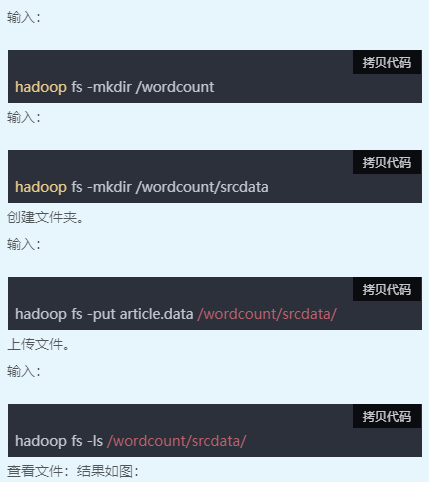
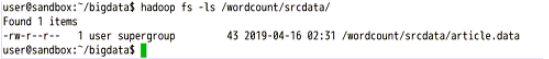
四、启动spark服务
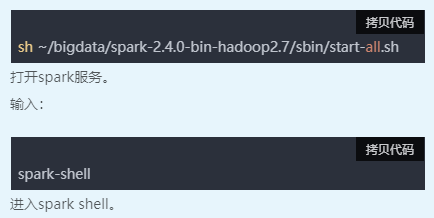
五、编写代码
复制以下代码到shell中(复制后在终端右键->粘贴):
import org.apache.spark.HashPartitioner

import java.io.PrintWriter

import java.io.File

val links = sc.parallelize(List(("A",List("B","C")),("B",List("A","C")),("C",List("A","B","D")),("D",List("C")))).partitionBy(new HashPartitioner(100)).persist()

var ranks=links.mapValues(v=>1.0)

for (i <- 0 until 10) {

val contributions=links.join(ranks).flatMap {

case (pageId,(links,rank)) => links.map(dest=>(dest,rank/links.size))

}

ranks=contributions.reduceByKey((x,y)=>x+y).mapValues(v=>0.15+0.85*v)

}

ranks.sortByKey().collect()

var input = sc.textFile("hdfs://localhost:9000/wordcount/srcdata/article.data")

val writer = new PrintWriter(new File("/home/user/bigdata/spark_output.txt"))

writer.println(input.flatMap(x=>x.split(" ")).countByValue())

writer.close()

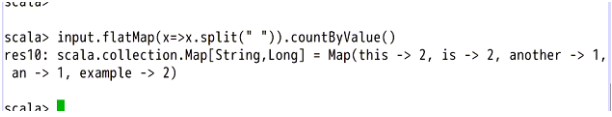
input.flatMap(x=>x.split(" ")).countByValue()
之后可以查看输出结果。
4.10:Spark之wordcount的更多相关文章
- [转] 用SBT编译Spark的WordCount程序
问题导读: 1.什么是sbt? 2.sbt项目环境如何建立? 3.如何使用sbt编译打包scala? [sbt介绍 sbt是一个代码编译工具,是scala界的mvn,可以编译scala,java等,需 ...
- Spark版wordcount,并根据词频进行排序
import org.apache.spark.{SparkConf, SparkContext}/** * Created by loushsh on 2017/10/9. */object Wor ...
- 用SBT编译Spark的WordCount程序
问题导读: 1.什么是sbt? 2.sbt项目环境如何建立? 3.如何使用sbt编译打包scala? sbt介绍 sbt是一个代码编译工具,是scala界的mvn,可以编译scala,java等,需要 ...
- 编写Spark的WordCount程序并提交到集群运行[含scala和java两个版本]
编写Spark的WordCount程序并提交到集群运行[含scala和java两个版本] 1. 开发环境 Jdk 1.7.0_72 Maven 3.2.1 Scala 2.10.6 Spark 1.6 ...
- 1.spark的wordcount解析
一.Eclipse(scala IDE)开发local和cluster (一). 配置开发环境 要在本地安装好java和scala. 由于spark1.6需要scala 2.10.X版本的.推荐 2 ...
- Spark 实现wordcount
配置完spark之后,使用spark实现wordcount,这一部分完全参考<深入理解Spark:核心思想与源码分析> 依然使用hadoop wordcountTest的那几个txt文件 ...
- spark 例子wordcount topk
spark 例子wordcount topk 例子描述: [单词计算wordcount ] [词频排序topk] 单词计算在代码方便很简单,基本大体就三个步骤 拆分字符串 以需要进行记数的单位为K,自 ...
- .Net for Spark 实现 WordCount 应用及调试入坑详解
.Net for Spark 实现WordCount应用及调试入坑详解 1. 概述 iNeuOS云端操作系统现在具备物联网.视图业务建模.机器学习的功能,但是缺少一个计算平台产品.最近在调研使用 ...
- 在IDEA中编写Spark的WordCount程序
1:spark shell仅在测试和验证我们的程序时使用的较多,在生产环境中,通常会在IDE中编制程序,然后打成jar包,然后提交到集群,最常用的是创建一个Maven项目,利用Maven来管理jar包 ...
- spark学习之IDEA配置spark并wordcount提交集群
这篇文章包括以下内容 (1)IDEA中scala的安装 (2)hdfs简单的使用,没有写它的部署 (3) 使用scala编写简单的wordcount,输入文件和输出文件使用参数传递 (4)IDEA打包 ...
随机推荐
- mysqld_exporter参数信息
[root@database03 mysqld_exporter]# ./mysqld_exporter --help usage: mysqld_exporter [<flags>] F ...
- Docker — 从入门到实践(v1.2.0)
在线地址:https://www.bookstack.cn/read/docker_practice-1.2.0 pdf文件下载地址:https://files.cnblogs.com/files/s ...
- 复现禅道V16.5的SQL注入(CNVD-2022-42853)
漏洞详情 禅道V16.5未对输入的account参数内容作过滤校验,导致攻击者拼接恶意SQL语句执行. 环境搭建 环境下载:禅道V16.5 下载后双击运行,进入目录运行start.exe 直接访问即可 ...
- oneplus8手机蓝牙连接tws耳机无法双击退出语音助手
通过蓝牙协议栈我们知道,蓝牙耳机可以通过发送AT指令唤醒或者退出语音助手 唤醒语音助手: AT+BVRA=1 退出语音助手: AT+BVRA=0 但是实际操作中发现双击可以唤醒但再次双击却无法退出语音 ...
- struts.xml 中用OGNL表达式取不到中文文件名的原因
在struts2中xml配置如下,以execl文件为例: <result name="success" type="stream"> < ...
- 魔改xxl-job,彻底告别手动配置任务!
原创:微信公众号 码农参上,欢迎分享,转载请保留出处. 哈喽大家好啊,我是Hydra. xxl-job是一款非常优秀的任务调度中间件,轻量级.使用简单.支持分布式等优点,让它广泛应用在我们的项目中,解 ...
- EFCore (三)悲观锁 和 乐观锁
原理 UPDATE [Person] SET [FirstName] = @p1 WHERE [PersonId] = @p0 AND [LastName] = @p2; 在 SaveChanges ...
- 配置DNS域名解析服务
概: DNS技术作为互联网基础设施中的重要一环,为用户提供不间断.稳定且快速的域名查询服务,保证互联网正常运转.在互联网中,用户基本上都是基于DNS服务,使用域名访问网络上的计算机,DNS服务是我 ...
- logback.xml详解
介绍 之前博文有专门介绍过基于Log4j Appender 实现大数据平台组件日志的采集, 本篇主要对java项目中经常会接触到的logback.xml文件的配置做一个介绍和总结. logback.x ...
- mybatis-plugin插件执行原理
mybatis-plugin插件执行原理 今天主要是在看mybatis的主流程源码,其中比较感兴趣的是mybatis的plugin功能,这里主要记录下mybatis-plugin的插件功能原理. pl ...