
SQL SERVER 索引中聚集索引分析和Transact-SQL语句优化
一. 聚集索引B树分析
1.聚集索引按B树结构进行组织的,索引B树种的每一页称为一个索引节点。B树的顶端节点称为根节点。
索引中的低层节点称为叶节点。根节点与叶节点之间的任何索引级别统称为中间级。在聚集索引中,叶节点包含基础表的数据页。
根节点和中间级节点包含存有索引行的索引页。每个索引行包含一个键值和一个指针,该指针指向 B 树上的某一中间级页或叶级索引中的某个数据行.每级索引中的页均被连接在双向链接列表中。
2.索引使用的每一个分区的index_id = 1 ,默认情况下聚集索引单个分区,当使用分区表的时候,每个分区都有一个包含该特定分区相关数据的B树结构,我是这么理解的不知道对不对?
3.SQL Server 写入的数据,数据链内的页和行将按聚集索引键值进行排序。
4.SQL Server 将在索引中查找该范围的起始键值,然后用向前或向后在数据页中进行扫描。为了查找数据页链的首页,SQL Server 将从索引的根节点沿最左边的指针进行扫描。
聚集索引B树图 :

二 .优化 Transact-SQL 语句经常使用的语句
1.SET STATISTICS IO {ON| OFF} /*Transact-SQL 语句生成的磁盘活动量的信息*/
2.SET SHOWPLAN_ALL ON {ON| OFF} /*返回有关语句执行情况的详细信息,并估计语句对资源的需求*/
3.SET STATISTICS TIME {ON| OFF} /*显示分析、编译和执行各语句所需的毫秒数*/
4.使用T-SQL语句创建索引的语法:
CREATE [UNIQUE] [CLUSTERED|NONCLUSTERED]
INDEX index_name
ON table_name (column_name)
[WITH FILLFACTOR=x]
UNIQUE表示唯一索引,可选CLUSTERED、NONCLUSTERED表示聚集索引还是非聚集索引, 可选 FILLFACTOR表示填充因子,指定一个0到100之间的值,该值指示索引页填满的空间所占的百分比
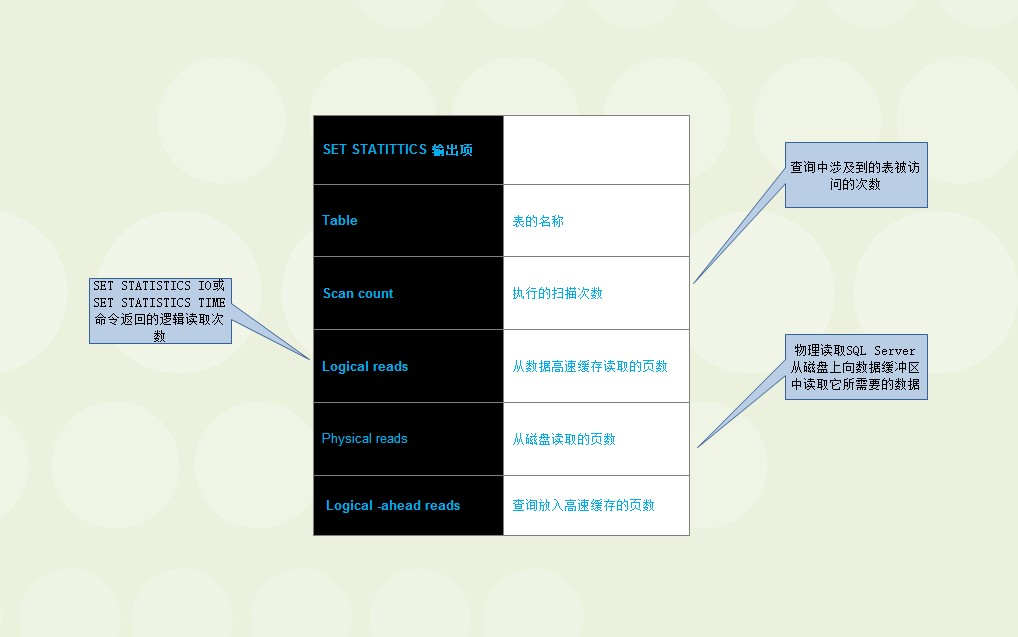
SET STATISTICS IO 输出信息如图
三 创建数据测试下上面学到的理论知识
--创建表
CREATE TABLE employee
(
emp_username varchar (20),
emp_register DATETIME
)
--插入测试数据
DECLARE @startid INT
DECLARE @endid INT
SELECT @startid= 1,@endid = 100
WHILE @startid <=@endid
BEGIN
INSERT INTO employee (
emp_username,
emp_register
) VALUES (
/* emp_username - varchar (20) */ '刘'+CAST(@startid AS NVARCHAR(20)),
/* emp_register - DATETIME */ GETDATE() )
SELECT @startid =@startid +1;
END
-- 查询employee的执行计划 和 io 信息
SET STATISTICS IO ON
SELECT * FROM employee WHERE emp_username = '刘'
查看消息输出的 IO 信息
表'employee'。(1)1扫描计数1,(2)逻辑读取1 次,(3)物理读取0 次,(4)预读0 次,lob 逻辑读取0 次,lob 物理读取0 次,lob 预读0 次。
输出的信息和上面的图片讲解的是对应的
1. 执行的扫描次数 。
2. 从磁盘读取的页数。
3. 为进行查询而放入缓存的页数。
4. 预读
T_SQL transaction 语句有很多种的写法,但是决定那条语句是最优的是根据(logical reads) 逻辑读取来判断。
添加聚集索引 查询逻辑读取是否会变少
CREATE CLUSTERED INDEX Idx_emp_username ON employee (emp_username);
--然后再执行查询
SET STATISTICS IO ON
SELECT * FROM employee WHERE emp_username = '刘'
查看消息输出的 IO 信息
表'employee'。扫描计数1,逻辑读取2 次,物理读取0 次,预读0 次,lob 逻辑读取0 次,lob 物理读取0 次,lob 预读0 次。
Q 这次逻辑读取是2次为什么呢 ?
A.难道查询比表扫描还要慢,答案是对的,数据量小的时候,聚集索引的优势体现不出来。
Q 为什么是2次逻辑读取
A 现在查询的时候如聚集索引图,先查询索引页 ,查找到对应的键值后,扫描数据页,如果有包含索引,直接在索引页就可以提取到需要的数据。
上面说了小数据量的时候聚集索引体现不出效果,下面我们继续填充数据测试 。
填充测试数据到1000
表扫描
消息:
表'employee'。扫描计数1,逻辑读取36 次,物理读取0 次,预读0 次,lob 逻辑读取0 次,lob 物理读取0 次,lob 预读0 次。
聚集索引扫描
消息:
表'employee'。扫描计数1,逻辑读取2 次,物理读取0 次,预读0 次,lob 逻辑读取0 次,lob 物理读取0 次,lob 预读0 次。
这个时候聚集索引的优势就先显示出来了 O(∩_∩)O
下面在来讲讲transaction sql 语句 ,大家在网上看到的一些人说 In like left 不使用索引 ,我们动手来测试下看他们说的对不对 ?
删除employee表的索引
DROP INDEX employee.Idx_emp_username
表 'employee'。扫描计数 1,逻辑读取 371 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
打开IO信息
SET STATISTICS IO ON
SELECT * FROM employee WHERE employee.emp_username in ('刘10000')
消息:
--添加Idx_emp_username聚集索引
CREATE CLUSTERED INDEX Idx_emp_username ON employee (emp_username);
SELECT * FROM employee WHERE employee.emp_username in ('刘10000');
消息:
表 'employee'。扫描计数 1,逻辑读取 3 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
使用索引后逻辑读取3次,没有使用索引是371次,IN 很好的使用了索引!
下面我们来测试下 LIKE 是否很好的使用索引
删除索引
DROP INDEX employee.Idx_emp_username
打开IO 信息
SET STATISTICS IO ON
执行查询
SELECT * FROM employee WHERE employee.emp_username like ('刘1000%')
消息:
表 'employee'。扫描计数 1,逻辑读取 371 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
添加索引
CREATE CLUSTERED INDEX Idx_emp_username ON employee (emp_username);
SET STATISTICS IO ON
SELECT * FROM employee WHERE employee.emp_username like ( '刘1000%');
表 'employee'。扫描计数 1,逻辑读取 3 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
网上很多优化的文章写到查询不要使用 in like left ,其实自己动手测试下看看查询计划就一幕了然了 。
引用地址: http://www.cr173.com/html/7022_all.html
SQL SERVER 索引中聚集索引分析和Transact-SQL语句优化的更多相关文章
- SQL Server的非聚集索引中会存储NULL吗?
原文:SQL Server的非聚集索引中会存储NULL吗? SQL Server的非聚集索引中会存储NULL吗? 这是个很有意思的问题,下面通过如下的代码,来说明,到底会不会存储NULL. --1.建 ...
- SQL Server查询中特殊字符的处理方法 (SQL Server特殊符号的转义处理)
SQL Server查询中特殊字符的处理方法 (SQL Server特殊符号的转义处理) SQL Server查询中,经常会遇到一些特殊字符,比如单引号'等,这些字符的处理方法,是SQL Server ...
- 程序员眼中的 SQL Server-非聚集索引能给我们带来什么?
写在前面 最近在做的一个项目,页面访问的时候很慢(大概几秒钟的样子),然后用日志记录的方式,来排查这个问题,最后发现是 Entity Framework 初始化的一个坑(大概要花 6-7 秒),详见: ...
- Entity Framework Code First+SQL Server,改变聚集索引,提高查询性能
.net Entity Framework(调研的是Entity Framework 4.0) code first方式生成数据库时,不能修改数据库表的索引,而SQLServer默认会把数据表的主键设 ...
- 在SQL Server里禁用聚集索引——真的好么?
有人问了我一个最有意思的问题:“你能禁用聚集索引么?” 对这个问题,我先是吓了一跳,因为我从未想过禁用聚集索引,因为聚集索引代表表数据,对这个最有趣问题,我立即答道:“我认为可以,但是...” 好吧, ...
- SQL Server 2008中新增的 1.变更数据捕获(CDC) 和 2.更改跟踪
概述 1.变更数据捕获(CDC) 每一次的数据操作都会记录下来 2.更改跟踪 只会记录最新一条记录 以上两种的区别: http://blog.csdn.n ...
- SQL Server 2008中新增的变更数据捕获(CDC)和更改跟踪
来源:http://www.cnblogs.com/downmoon/archive/2012/04/10/2439462.html 本文主要介绍SQL Server中记录数据变更的四个方法:触发器 ...
- SQL Server 2012 列存储索引分析(翻译)
一.概述 列存储索引是SQL Server 2012中为提高数据查询的性能而引入的一个新特性,顾名思义,数据以列的方式存储在页中,不同于聚集索引.非聚集索引及堆表等以行为单位的方式存储.因为它并不要求 ...
- SQL Server 2012 列存储索引分析(转载)
一.概述 列存储索引是SQL Server 2012中为提高数据查询的性能而引入的一个新特性,顾名思义,数据以列的方式存储在页中,不同于聚集索引.非聚集索引及堆表等以行为单位的方式存储.因为它并不要求 ...
随机推荐
- 图像处理之优化---任意半径局部直方图类算法在PC中快速实现的框架
在图像处理中,局部算法一般来说,在很大程度上会获得比全局算法更为好的效果,因为他考虑到了图像领域像素的信息,而很多局部算法可以借助于直方图获得加速.同时,一些常规的算法,比如中值滤波.最大值滤波.最小 ...
- jquery添加!important样式
$("span.colorFlag").parents("th").css("cssText","background-color ...
- XML转换成数组方法
<?php function xmlToArray2($xml) { // 将XML转为array $array_data = json_decode(json_encode(simplexml ...
- java锁和同步
Java 语言设计中的一大创新就是:第一个把跨平台线程模型和锁模型应用到语言中去,Java 语言包括了跨线程的关键字synchronized 和 volatile,使用关键字和java类库就能够简单的 ...
- 【分享】DevDocs API Documentation
http://devdocs.io/ 这是一份综合性的在线API列表,很全,方便查找.
- 模拟ORA-26040: Data block was loaded using the NOLOGGING option
我们知道通过设置nologging选项.能够加快oracle的某些操作的运行速度,这在运行某些维护任务时是非常实用的,可是该选项也非常危急,假设使用不当,就可能导致数据库发生ORA-26040错误. ...
- Segmented 标签栏 切换效果
转载:http://www.jcodecraeer.com/a/anzhuokaifa/androidkaifa/2014/0512/1615.html http://www.it165.net/pr ...
- jQuery的validate验证插件使用方法
(1)默认校验规则(1)required:true 必输字段(2)remote:"check.php" 使用ajax方法调用check.php验证输入值(3)email:true ...
- Import error: no module named cv2 错误解决方法
Windows: 将opencv安装目录下的cv2.pyd拷贝到Python安装目录里Lib中site-packages Linux: (1)将opencv安装目录下的cv2.so拷贝到Python安 ...
- 【BZOJ4543】[POI2014]Hotel加强版 长链剖分+DP
[BZOJ4543][POI2014]Hotel加强版 Description 同OJ3522数据范围:n<=100000 Sample Input 7 1 2 5 7 2 5 2 3 5 6 ...