
EDW on Hadoop(Hadoop上的数据仓库)技术选型和实践思考
在这篇文章中, 将讨论EDW on Hadoop 有哪些备选方案, 以及我个人的倾向性, 最后是建构方法. 欢迎转载, 但必须注明原贴(刘忠武, http://www.cnblogs.com/harrychinese/p/edw_on_hadoop.html).
数据仓库发展已经有二十多年了, 我们先看看数据仓库发展的趋势:
在数据规模小的时候, 采用单节点RDBMS作为存储和执行引擎, 比如Oracle/PostgreSQL/MySQL都行;
当数据规模大了后, 或者时间窗口很紧时, 多采用MPP的解决方案, 比如Teradata/Exedata, 这些MPP多是一体机, 实施成本比较高, 满配后如要做扩容, 哪怕是很小的扩容, 都需投入大量资金, 显得非常不划算. 现在有的互联网企业的数据量非常之大, 即使是采用顶配的一体机, 往往也撑不住.
最近几年, SQL on Hadoop技术发展很快, 尤其是Hive被大量采用之后, 开源社区和商业数据仓库厂商都意识到EDW on Hadoop是未来的方向. 下图是一些现在比较活跃的方案,
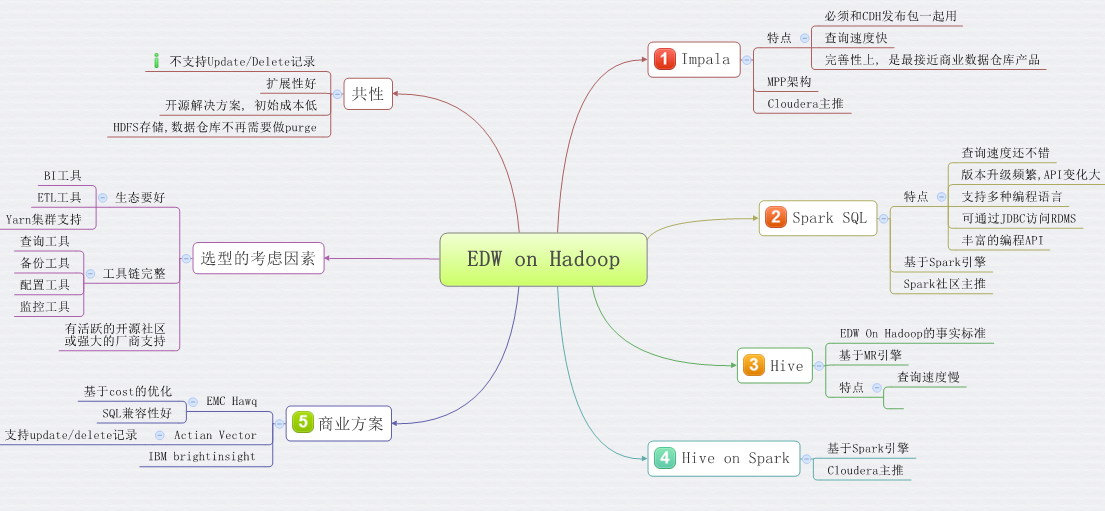
在开源方案中, 我比较看好Impala和Spark SQL, 尤其是Spark SQL. 原因有:
1.使用Spark SQL建构EDW相对容易些: 数据仓库项目中, ETL是非常重要的一环, Spark作为一个高效的计算框架, 借助RDD算子或者SQL写法很胜任ETL的Transform, Extract可以借助Sqoop.
2. Spark SQL性能不错: 在最近1.3版Spark SQL性能已经很不错.
3. Spark, one stack to rule them all: 对于企业而言, spark会给你更多, 将来MLlib应该能替代SAS. 对于开发者而言, 只需要学一门, 就能做好多方面的事情.这有点像Java语言当初的口号,一次编译,到处运行。
4. 社区活跃, 版本迭代快(版本这事, 是优点也是缺点)
Spark SQL数据仓库架构设计
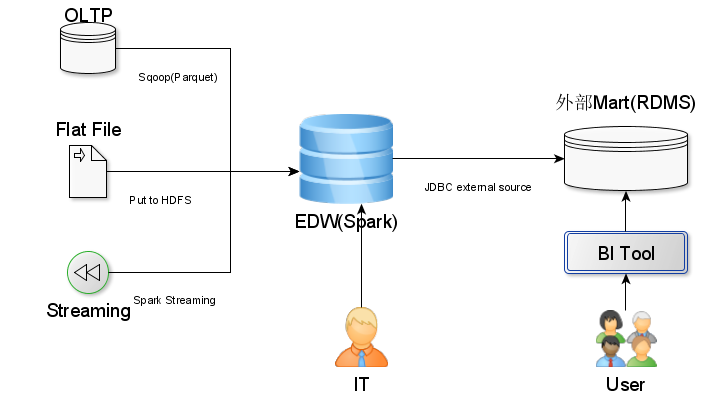
两张架构图, 第一张是展现EDW的位置, Input有哪些, Output有哪些. Input展现的已经很明显了, 对于EDW输出, 目前传统的BI工具还不支持Spark SQL, 所以我们设计一个外部RDBMS数据集市, Spark数据仓库负责推数据到该数据集市, BI工具直接访问这个数据集市.
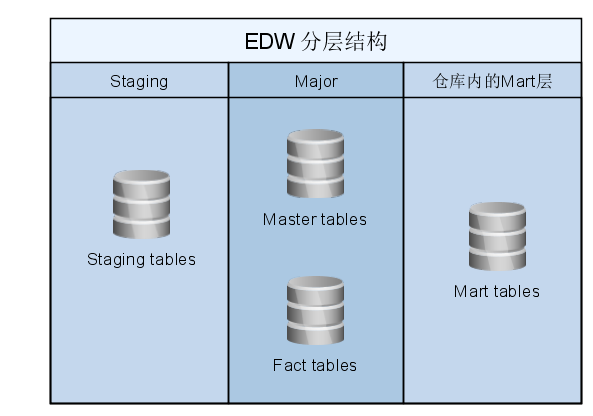
和传统的数据仓库一样, 为了治理需要, 也需要对于Spark EDW分层, 一般三层就足够了.
另外, 我们可考虑设计一个active archive区, 专门归档OLTP数据.
ETL设计思想
每个EDW, ETL工作量都很大, 而且直接影响EDW使用效果.
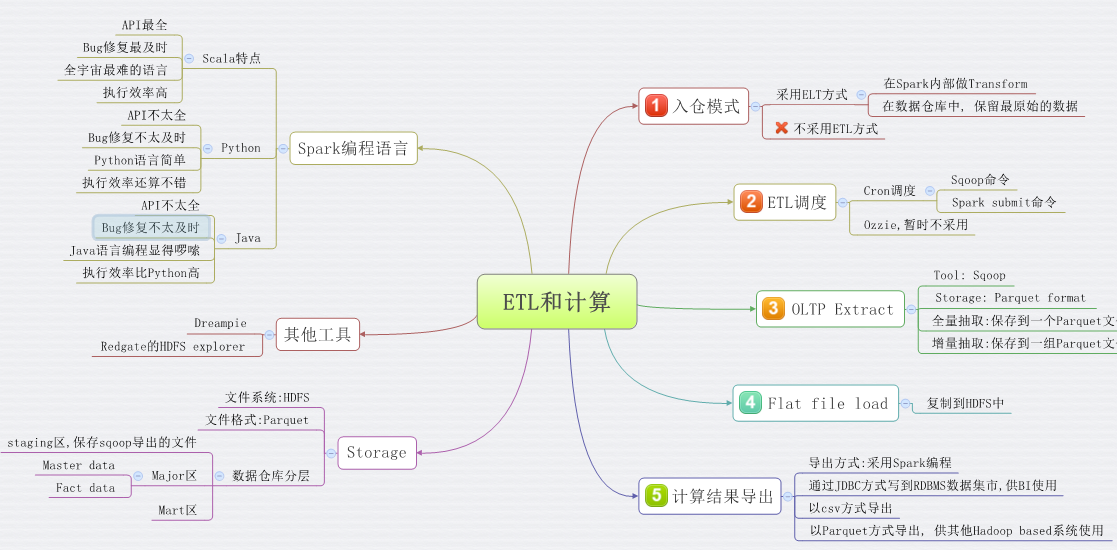
从大的设计架构看, 推荐采用ELT, 而不是ETL模式. 为什么? 传统ETL最大的好处是, 可以减轻EDW的压力. 对于Hadoop基础上的数据仓库, 但采用ETL的这个好处, 就不明显了, EDW压力可以通过横向扩展, 很容易解决.
对于Extract, 可用Sqoop完成卸载, 推荐采用Parquet格式, 这样Spark SQL可以直接mount这些数据, 也就完整了Load.
Transform在Spark上完成, Spark编程接口非常丰富, 支持Scala/Python/Java编程语言.
至于到底采用哪种开发语言, 我的看法是, 优先采用Python, 无它, Python代码最易读了. 但我们需要清楚的是, Scala API总是最全的, Java 版API次之, Python版的API最少, 另外, API若有bug的话, Python版修复的进度也是最晚的. 但好在Python API现在已经很完善了. 在Spark 1.3版中, Python 的dataFrame缺少createJDBCTable() 编程接口.
简单总结一下
Spark数据仓库的能承担的作用有:
1. 产生BI报表数据
2. 做数据挖掘
3. 作为Active archive
另外, 还能节省不少开销: 省掉了一体机, 省掉了ETL工具, 省掉了SAS分析软件, 省掉高端的存储.
EDW on Hadoop(Hadoop上的数据仓库)技术选型和实践思考的更多相关文章
- Hadoop生态上几个技术的关系与区别:hive、pig、hbase 关系与区别 Pig
Hadoop生态上几个技术的关系与区别:hive.pig.hbase 关系与区别 Pig 一种操作hadoop的轻量级脚本语言,最初又雅虎公司推出,不过现在正在走下坡路了.当初雅虎自己慢慢退出pig的 ...
- Hadoop生态上几个技术的关系与区别:hive、pig、hbase 关系与区别
初接触Hadoop技术的朋友肯定会对它体系下寄生的个个开源项目糊涂了,我敢保证Hive,Pig,HBase这些开源技术会把你搞的有些糊涂,不要紧糊涂的不止你一个,如某个菜鸟的帖子的疑问,when to ...
- Hadoop生态上几个技术的解释:hive、pig、hbase 关系与区别
hadoop生态圈 Pig 一种操作hadoop的轻量级脚本语言,最初又雅虎公司推出,不过现在正在走下坡路了.当初雅虎自己慢慢退出pig的维护之后将它开源贡献到开源社区由所有爱好者来维护.不过现在还是 ...
- 【转载】Hadoop生态上几个技术的关系与区别:hive、pig、hbase 关系与区别
转自:http://www.linuxidc.com/Linux/2014-03/98978.htm Pig 一种操作hadoop的轻量级脚本语言,最初又雅虎公司推出,不过现在正在走下坡路了.当初雅虎 ...
- 前端开发工程师 - 05.产品前端架构 - 协作流程 & 接口设计 & 版本管理 & 技术选型 &开发实践
05.产品前端架构 第1章--协作流程 WEB系统 角色定义 协作流程 职责说明 第2章--接口设计 概述 接口规范 规范应用 本地开发 第3章--版本管理 见 Java开发工程师(Web方向) - ...
- 平安银行在开源技术选型上的思考和实践 RocketMQ
小结: 1. https://mp.weixin.qq.com/s/z_c5D8fvHaYvHSczm0nYFA 平安银行在开源技术选型上的思考和实践 平安银行·吴建峰 阿里巴巴中间件 3月7日 随着 ...
- MaxCompute 构建企业云数据仓库CDW的最佳实践建议
在本文中阿里云资深产品专家云郎分享了基于阿里云 MaxCompute 构建企业云数据仓库CDW的最佳实践建议. 本文内容根据演讲视频以及PPT整理而成. 大家下午好,我是云郎,之前在甲骨文做企业架构师 ...
- 大数据入门第五天——离线计算之hadoop(上)概述与集群安装
一.概述 根据之前的凡技术必登其官网的原则,我们当然先得找到它的官网:http://hadoop.apache.org/ 1.什么是hadoop 先看官网介绍: The Apache™ Hadoop® ...
- SQL on Hadoop中用到的主要技术——MPP vs Runtime Framework
转载声明 本文转载自盘点SQL on Hadoop中用到的主要技术,个人觉得该文章对于诸如Impala这样的MPP架构的SQL引擎和Runtime Framework架构的Hive/Spark SQL ...
随机推荐
- wpf添加超链接
前段: <TextBlock Margin="69,93,859,10"> <Hyperlink NavigateUri="http://dmsite. ...
- ubuntu下gedit中文乱码
gsettings set org.gnome.gedit.preferences.encodings auto-detected "['GB18030', 'GB2312', 'GBK', ...
- UVa 673 Parentheses Balance
一个匹配左右括号的问题 /*UVa 673 Parentheses Balance*/ #include<iostream> #include<algorithm> #incl ...
- 恶意软件/BOT/C2隐蔽上线方式研究
catalogue . 传统木马上线方式 . 新型木马上线方式 . QQ昵称上线 . QQ空间资料上线 . 第三方域名上线 . UDP/TCP二阶段混合上线 . Gmail CNC . NetBot两 ...
- 解决Cookie乱码问题
写了一个cookie的定义和获取,结果我输入中文后,页面报错 报错信息如下: type Exception report message An exception occurred processin ...
- 《JavaScript权威指南》学习笔记 第七天 DOM操作
由衷的觉得,随着IT技术的广泛的运用,个人电脑以及智能手机的使用,信息的获取与传播更为简单.但是我们获取有用信息的难度相反是越来越大了,想要保持住自己的注意力越来越难了.除了吃饭睡觉,我的精力都在电脑 ...
- 机器学习笔记----- ID3算法的python实战
本文申明:本文原创,如有转载请申明.数据代码来自实验数据都是来自[美]Peter Harrington 写的<Machine Learning in Action>这本书,侵删. Hell ...
- SaltStack与ZeroMQ(二)
SaltStack与ZeroMQ SaltStack底层是基于ZeroMQ进行高效的网络通信. ZeroMQ简介 ØMQ (也拼写作ZeroMQ,0MQ或ZMQ)是一个为可伸缩的分布式或并发应用程序设 ...
- 从.o文件中提取指定开头依赖于外部接口的脚本
nm -g audio_la-audio.o | grep " U " | awk '{ print $2}' | grep "^gst_"
- Java线程:Timer和TimerTask
Timer和TimerTask可以做为实现线程的第三种方式,前两中方式分别是继承自Thread类和实现Runnable接口. Timer是一种线程设施,用于安排以后在后台线程中执行的任务.可安排任务执 ...