
spark ML pipeline 学习
一。pipeline
一个典型的机器学习过程从数据收集开始,要经历多个步骤,才能得到需要的输出。这非常类似于流水线式工作,即通常会包含源数据ETL(抽取、转化、加载),数据预处理,指标提取,模型训练与交叉验证,新数据预测等步骤。
在介绍工作流之前,我们先来了解几个重要概念:
- DataFrame:使用Spark SQL中的DataFrame作为数据集,它可以容纳各种数据类型。 较之 RDD,包含了 schema 信息,更类似传统数据库中的二维表格。它被 ML Pipeline 用来存储源数据。例如,DataFrame中的列可以是存储的文本,特征向量,真实标签和预测的标签等。
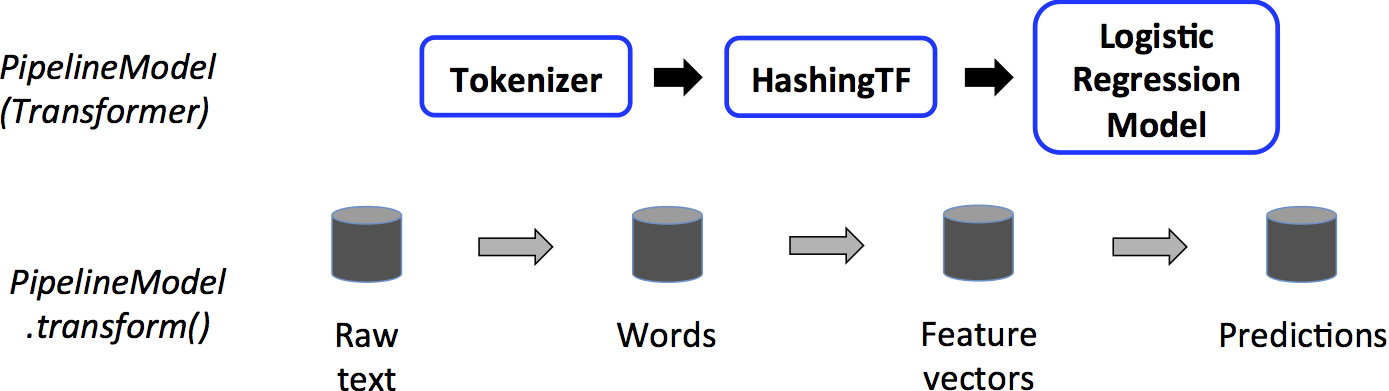
- Transformer:翻译成转换器,是一种可以将一个DataFrame转换为另一个DataFrame的算法。比如一个模型就是一个 Transformer。它可以把 一个不包含预测标签的测试数据集 DataFrame 打上标签,转化成另一个包含预测标签的 DataFrame。技术上,Transformer实现了一个方法transform(),它通过附加一个或多个列将一个DataFrame转换为另一个DataFrame。
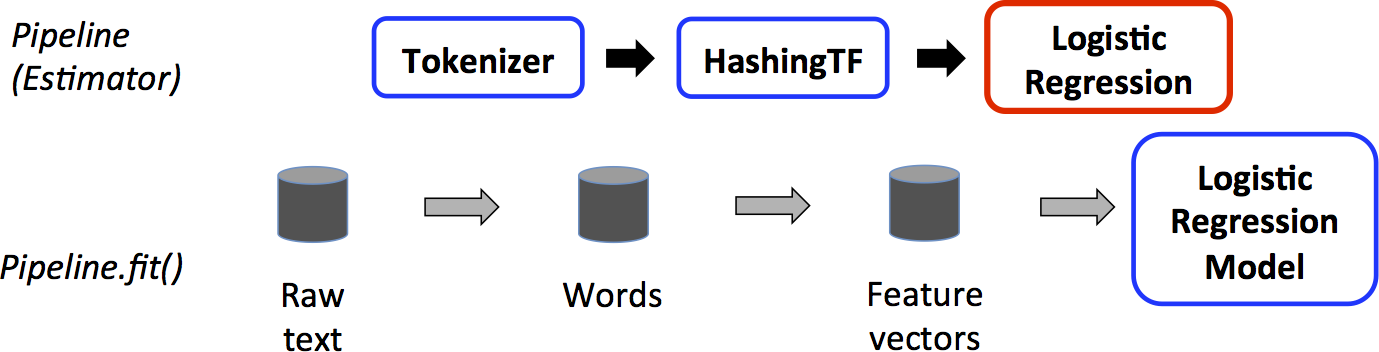
Estimator:翻译成估计器或评估器,它是学习算法或在训练数据上的训练方法的概念抽象。在 Pipeline 里通常是被用来操作 DataFrame 数据并生产一个 Transformer。从技术上讲,Estimator实现了一个方法fit(),它接受一个DataFrame并产生一个转换器。如一个随机森林算法就是一个 Estimator,它可以调用fit(),通过训练特征数据而得到一个随机森林模型。
Parameter:Parameter 被用来设置 Transformer 或者 Estimator 的参数。现在,所有转换器和估计器可共享用于指定参数的公共API。ParamMap是一组(参数,值)对。
PipeLine:翻译为工作流或者管道。工作流将多个工作流阶段(转换器和估计器)连接在一起,形成机器学习的工作流,并获得结果输出。
工作流如何工作
二。构建 ml pipeline
Spark2.0起,SQLContext、HiveContext已经不再推荐使用,改以SparkSession代之,故本文中不再使用SQLContext来进行相关的操作,关于SparkSession的具体详情,这里不再赘述,可以参看Spark2.0的官方文档
Spark2.0以上版本的pyspark创建一个名为spark的SparkSession对象,当需要手工创建时,SparkSession可以由其伴生对象的builder()方法创建出来
from pyspark.ml import Pipeline

from pyspark.ml.classification import LogisticRegression

from pyspark.ml.feature import HashingTF, Tokenizer

# Prepare training documents from a list of (id, text, label) tuples.

training = spark.createDataFrame([

    (0, "a b c d e spark", 1.0),

    (1, "b d", 0.0),

    (2, "spark f g h", 1.0),

    (3, "hadoop mapreduce", 0.0)

], ["id", "text", "label"])

tokenizer = Tokenizer(inputCol="text", outputCol="words")

hashingTF = HashingTF(inputCol=tokenizer.getOutputCol(), outputCol="features")

lr = LogisticRegression(maxIter=10, regParam=0.001)

pipeline = Pipeline(stages=[tokenizer, hashingTF, lr])

model = pipeline.fit(training)

test = spark.createDataFrame([

    (4, "spark i j k"),

    (5, "l m n"),

    (6, "spark hadoop spark"),

    (7, "apache hadoop")

], ["id", "text"])

prediction = model.transform(test)

selected = prediction.select("id", "text", "probability", "prediction")

for row in selected.collect():

    rid, text, prob, prediction = row

    print("(%d, %s) --> prob=%s, prediction=%f" % (rid, text, str(prob), prediction))

//输出

(4, spark i j k) --> prob=[0.155543713844,0.844456286156], prediction=1.000000

(5, l m n) --> prob=[0.830707735211,0.169292264789], prediction=0.000000

(6, spark hadoop spark) --> prob=[0.0696218406195,0.93037815938], prediction=1.000000

(7, apache hadoop) --> prob=[0.981518350351,0.018481649649], prediction=0.000000
通过上述结果,我们可以看到,第4句和第6句中都包含”spark”,其中第六句的预测是1,与我们希望的相符;而第4句虽然预测的依然是0,但是通过概率我们可以看到,第4句有46%的概率预测是1,而第5句、第7句分别只有7%和2%的概率预测为1,这是由于训练数据集较少,如果有更多的测试数据进行学习,预测的准确率将会有显著提升。
spark ML pipeline 学习的更多相关文章
- 使用spark ml pipeline进行机器学习
一.关于spark ml pipeline与机器学习 一个典型的机器学习构建包含若干个过程 1.源数据ETL 2.数据预处理 3.特征选取 4.模型训练与验证 以上四个步骤可以抽象为一个包括多个步骤的 ...
- Spark ML Pipeline简介
Spark ML Pipeline基于DataFrame构建了一套High-level API,我们可以使用MLPipeline构建机器学习应用,它能够将一个机器学习应用的多个处理过程组织起来,通过在 ...
- spark ml pipeline构建机器学习任务
一.关于spark ml pipeline与机器学习一个典型的机器学习构建包含若干个过程 1.源数据ETL 2.数据预处理 3.特征选取 4.模型训练与验证 以上四个步骤可以抽象为一个包括多个步骤的流 ...
- spark ml 的例子
一.关于spark ml pipeline与机器学习 一个典型的机器学习构建包含若干个过程 1.源数据ETL 2.数据预处理 3.特征选取 4.模型训练与验证 以上四个步骤可以抽象为一个包括多个步骤的 ...
- 基于Spark ML的Titanic Challenge (Top 6%)
下面代码按照之前参加Kaggle的python代码改写,只完成了模型的训练过程,还需要对test集的数据进行转换和对test集进行预测. scala 2.11.12 spark 2.2.2 packa ...
- Spark ML机器学习库评估指标示例
本文主要对 Spark ML库下模型评估指标的讲解,以下代码均以Jupyter Notebook进行讲解,Spark版本为2.4.5.模型评估指标位于包org.apache.spark.ml.eval ...
- Spark.ML之PipeLine学习笔记
地址: http://spark.apache.org/docs/2.0.0/ml-pipeline.html Spark PipeLine 是基于DataFrames的高层的API,可以方便用户 ...
- Spark ML下实现的多分类adaboost+naivebayes算法在文本分类上的应用
1. Naive Bayes算法 朴素贝叶斯算法算是生成模型中一个最经典的分类算法之一了,常用的有Bernoulli和Multinomial两种.在文本分类上经常会用到这两种方法.在词袋模型中,对于一 ...
- Spark ML源码分析之一 设计框架解读
本博客为作者原创,如需转载请注明参考 在深入理解Spark ML中的各类算法之前,先理一下整个库的设计框架,是非常有必要的,优秀的框架是对复杂问题的抽象和解剖,对这种抽象的学习本身 ...
随机推荐
- C语言的第一堂课
感觉茂哥讲了很多,但是有些输入的语句还是没能记住 刚讲的都是概念,看来需要看一下表格,以及C语言的基础 有些意思还不能够理解 略显尴尬 回去把C语言书的各种概念理解一下……
- 2017-12-19python全栈9期第四天第二节之列表的增删查改之元祖是只读列表、可循环查询、可切片、儿子不能改、孙子可以改
#!/user/bin/python# -*- coding:utf-8 -*-tu = ('zs','ls','ww',[1,2,3,4,5,'zxcvb'],'zl')print(tu[3])pr ...
- Intellij IDEA 4种配置热部署的方法【转】【补】
热加载 热加载可以使代码修改后无须重启服务器,就可以加载更改的代码.(其实分java和非java代码,本处可以让java代码立即生效且不重启服务) 第1种:修改服务器配置,使得IDEA窗口失去焦点时, ...
- axios 或 ajax 请求文件
axios 或 ajax 请求文件 axios({ url: path + '/monitor/exportPicture' + '?access_token=' + getToken(), meth ...
- 1. Ansible 简介
目录 1. Ansible 是什么? 2. Ansible 特性 3. 控制主机需求 4. 被管理节点需求 1. Ansible 是什么? Ansible 是一个配置管理系统(configuratio ...
- 微信小程序button组件样式
点击微信按键组件才能出授权,所以自定义样式就是必须的了,来自网友的帮助,如下图 <button class='btn1' open-type='contact'> <image cl ...
- Python——built-in module Help: math
Help on built-in module math: NAME math DESCRIPTION This module is always available. It provides acc ...
- Window7 定制 Explore中的右键菜单
win+R 命令 运行 regedit ,打开注册表 在 HKEY_CLASSES_ROOT\*\shell\VisualCode下创建针对文件的新增命令 command 在HKEY_CLASSE ...
- C# - 设计模式 - 模板模式
模板模式 问题场景 咖啡和茶派生于抽象类饮料,咖啡和茶都具有烧水的方法,所以可以将烧水的方法提取到抽象类饮料中去实现,而咖啡具有一个向杯子加咖啡粉的方法,茶具有一个向杯子加茶叶的方法,看起来两个方法是 ...
- $HOME
Ubuntu中 命令行输入$HOME bash: /home/XXX: Is a directory $HOME 是用户主目录